未找到提示词
试试搜索其他内容
试试这些 AI 技能
发现精选工具,帮助你生成精彩内容。
万物图鉴 · 中文知识信息图
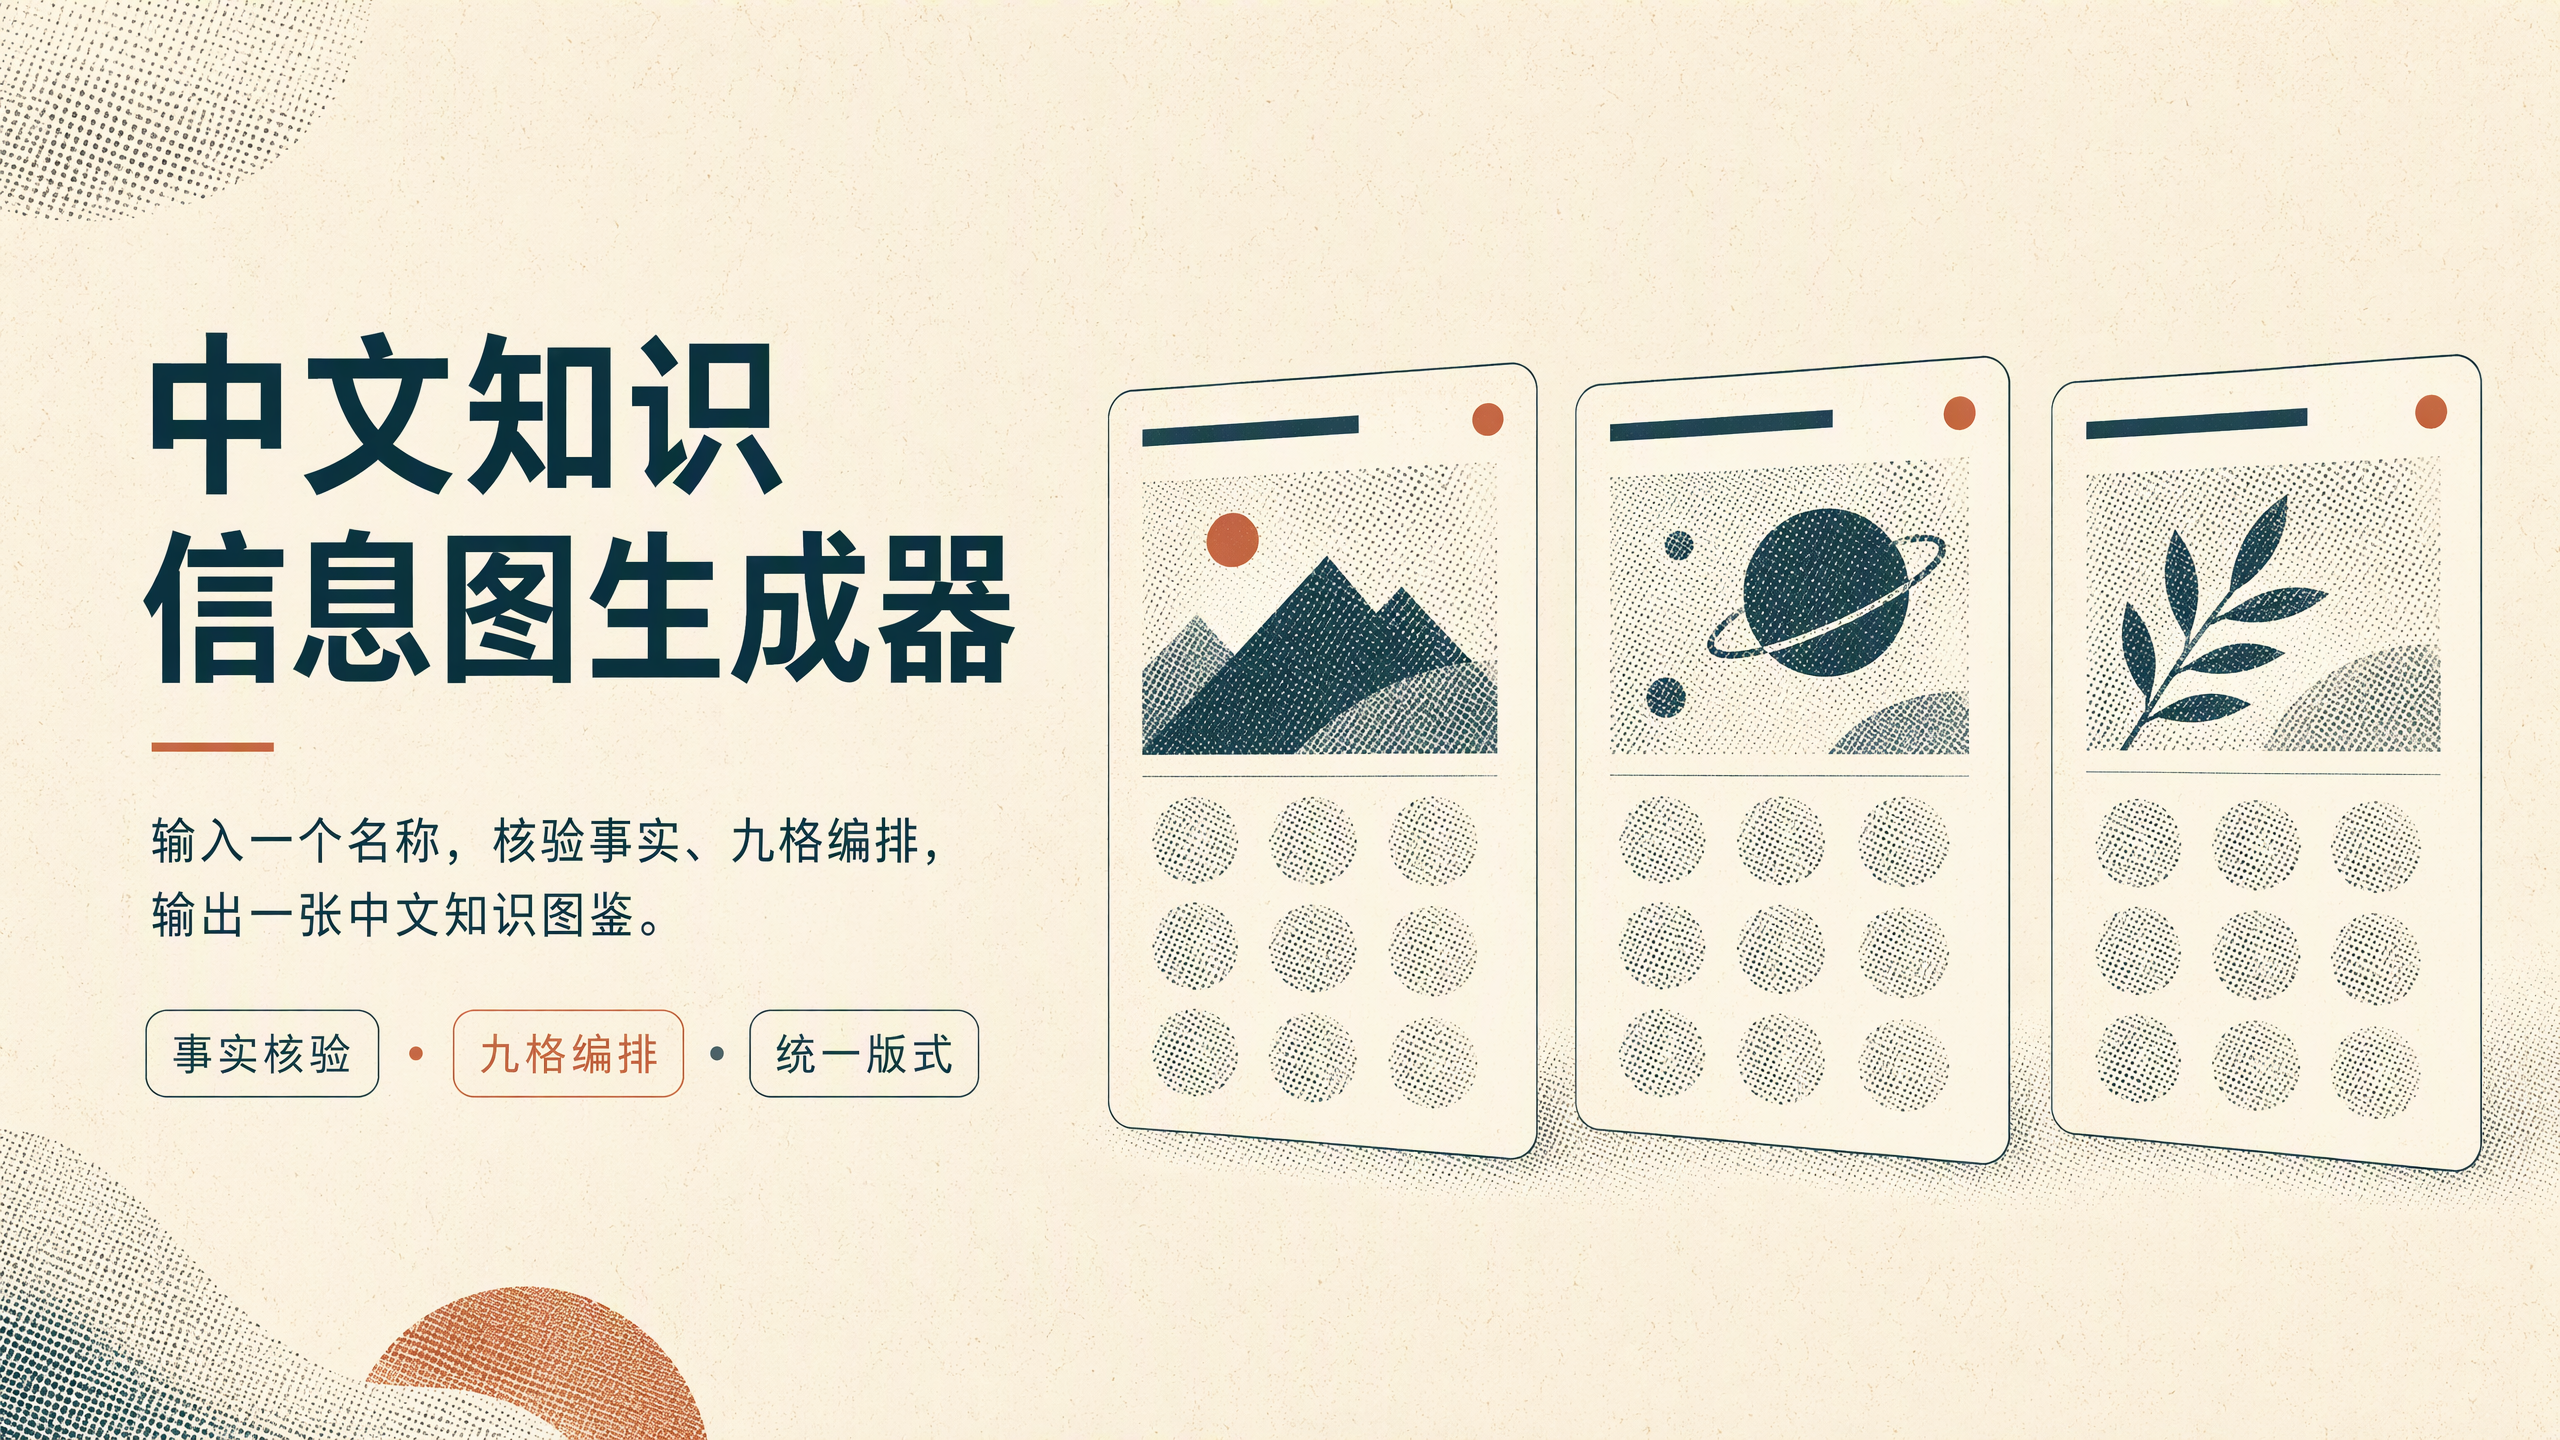
输入一个对象名称(也可附文章、笔记或图片),技能先定下这张图要回答的那一个问题,再做一轮事实核证,然后根据信息量选四格、六格或九格的版面,把每一格要写的字先定稿,最后实际出图并逐项验图。交付一张 3:4 竖版中文知识信息图,附一句说明、可复制的图中文字与真实来源;图片能力不可用时,交可复制的完整出图提示词。默认简体中文,可换繁体和横版比例。
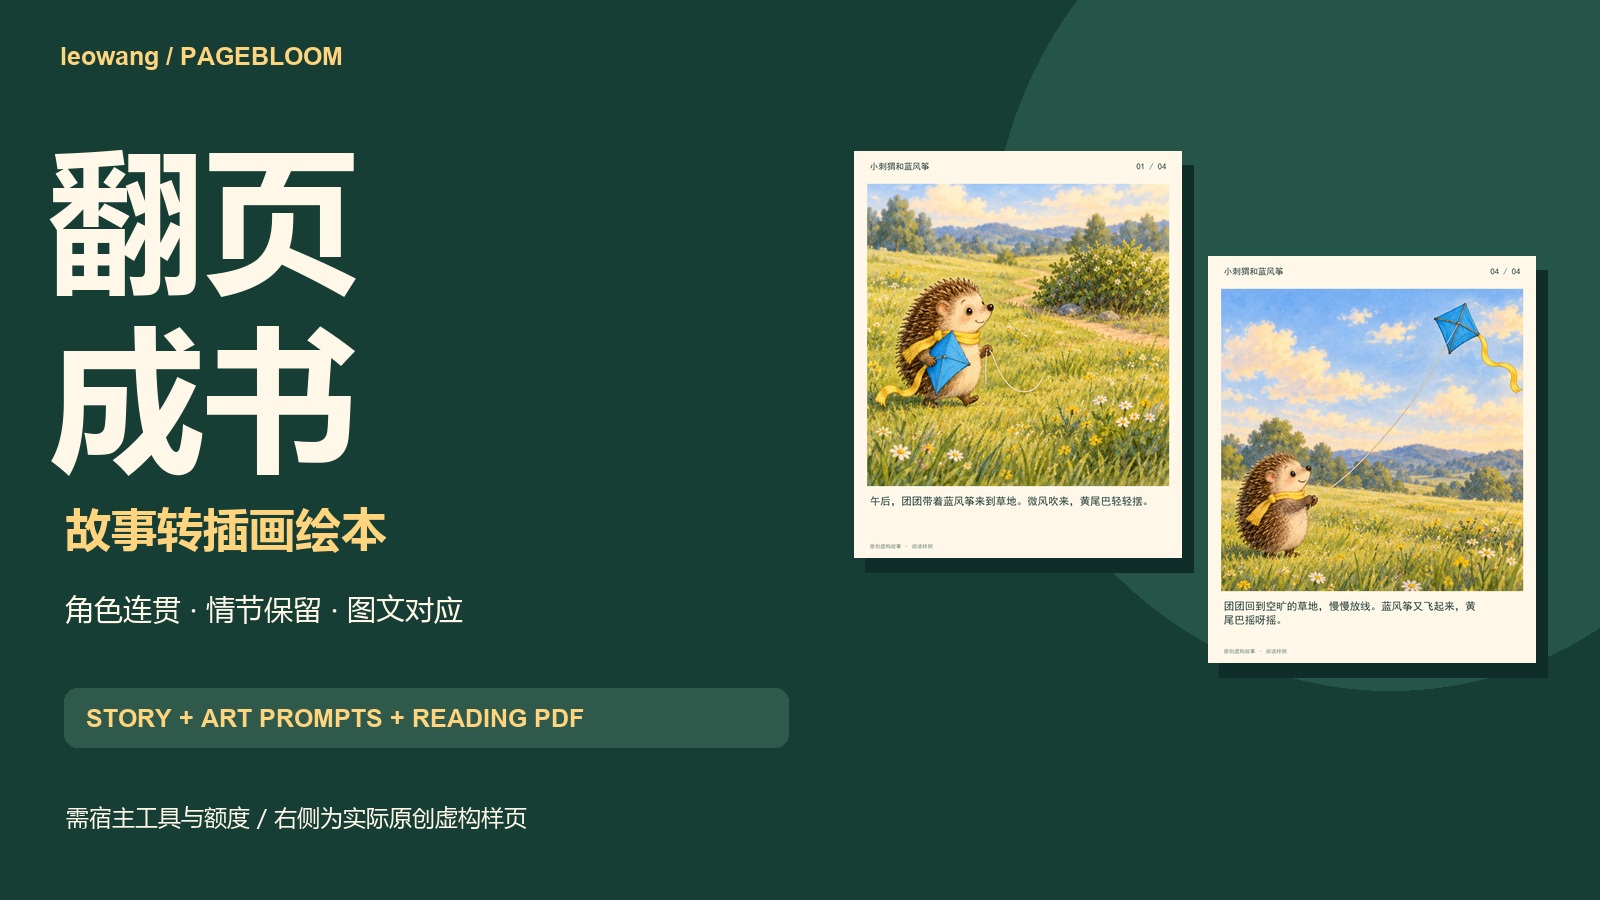
翻页成书|故事转插画绘本
故事写好了,下一步把它翻成一本小书。 提供自写或获准改编的故事,补充读者年龄、页数和画风,整理角色卡、逐页正文、画面方案与完整提示词。宿主有图像及文件工具且用量覆盖时,再生成插画、排字并导出阅读PDF;没有工具则交完整页稿。 附原创虚构故事的4页中英文样例。已完成一次中文文本API测试和一次四画面插画生成,并在本地裁切、排字与导出PDF;英文为编辑适配。尚未在YouMind内实测,不含模型额度,不保证跨图绝对一致或印刷出版合规。 已知样例偏差:第3幅可见风筝已被托起,但未清楚表现主角绕到灌木另一边的空间变化;该动作项未通过,不将本例称为情节全项合格。
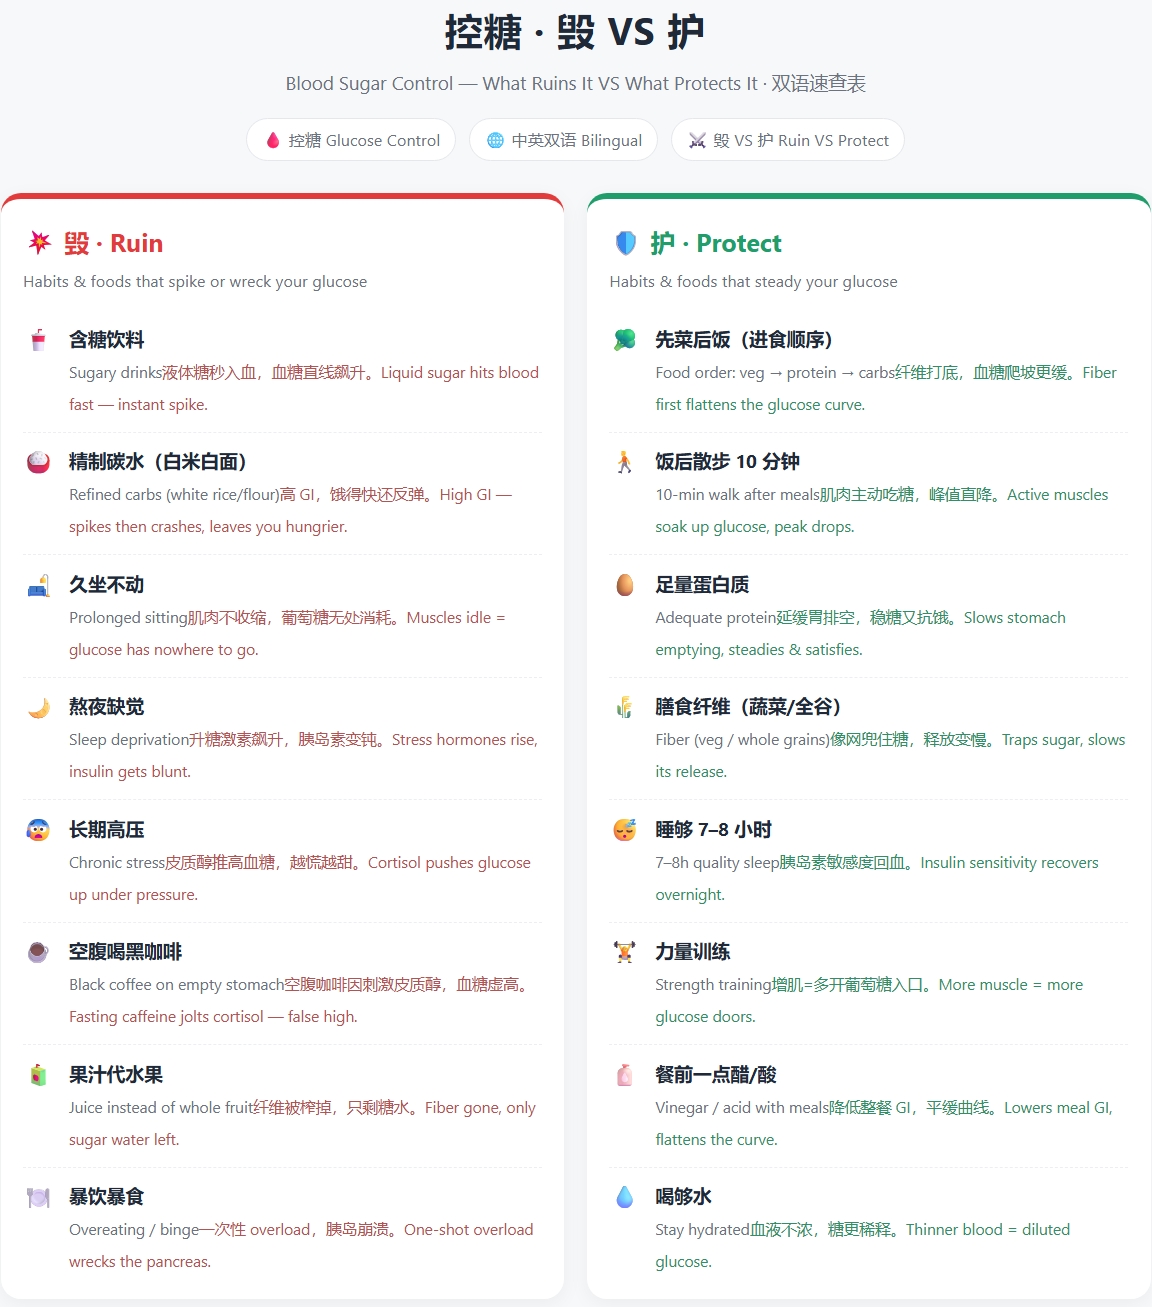
你身边的免费信息图生图提示词方案专家
知识信息图工作室:输入一个主题或一段资料,输出一张结构化知识信息图的「版式骨架 + 可复制的中英文字稿 + 生图提示词」,由用户拿去即梦 / 通义 / GPT Image 等外部 AI 出图。支持「毁 VS 护」爆款对比分屏。当用户提到做信息图、知识卡、科普长图、知识信息图、infographic、对比图、左右分屏、毁VS护时使用。我们不产图,但我们产出方案跟提示词,让你的只是信息图更加专业! 做自媒体的朋友大概都懂这种感觉:刷到别人一张"毁 VS 护"的护发对比图,点赞好几千,自己也心动想做。结果打开绘图软件——版式怎么分?字写啥?提示词怎么写?一通折腾,要么跑出来的图漂了,要么每次出图都扣你好几百积分,月底一算真心疼。 其实你缺的不是审美,是一套"能直接抄"的结构。这个 skill 就是干这个的:你丢一个词(比如"护发""控糖"),它把版式锁死、把图上要写的字逐字备好、再把一份精准的中英双语提示词交到你手里。你拿去任意绘图 AI 一键出图,**结构稳、风格成系列、积分一分不花**。 别人那个同类型的"爆款对比图"技能,兑换要 4688 积分;我们这个,免费,而且给的是同样能打的"毁 VS 护"分屏结构——只不过出图那一步交给你常用的 AI,把省下来的积分留给真正要紧的事。
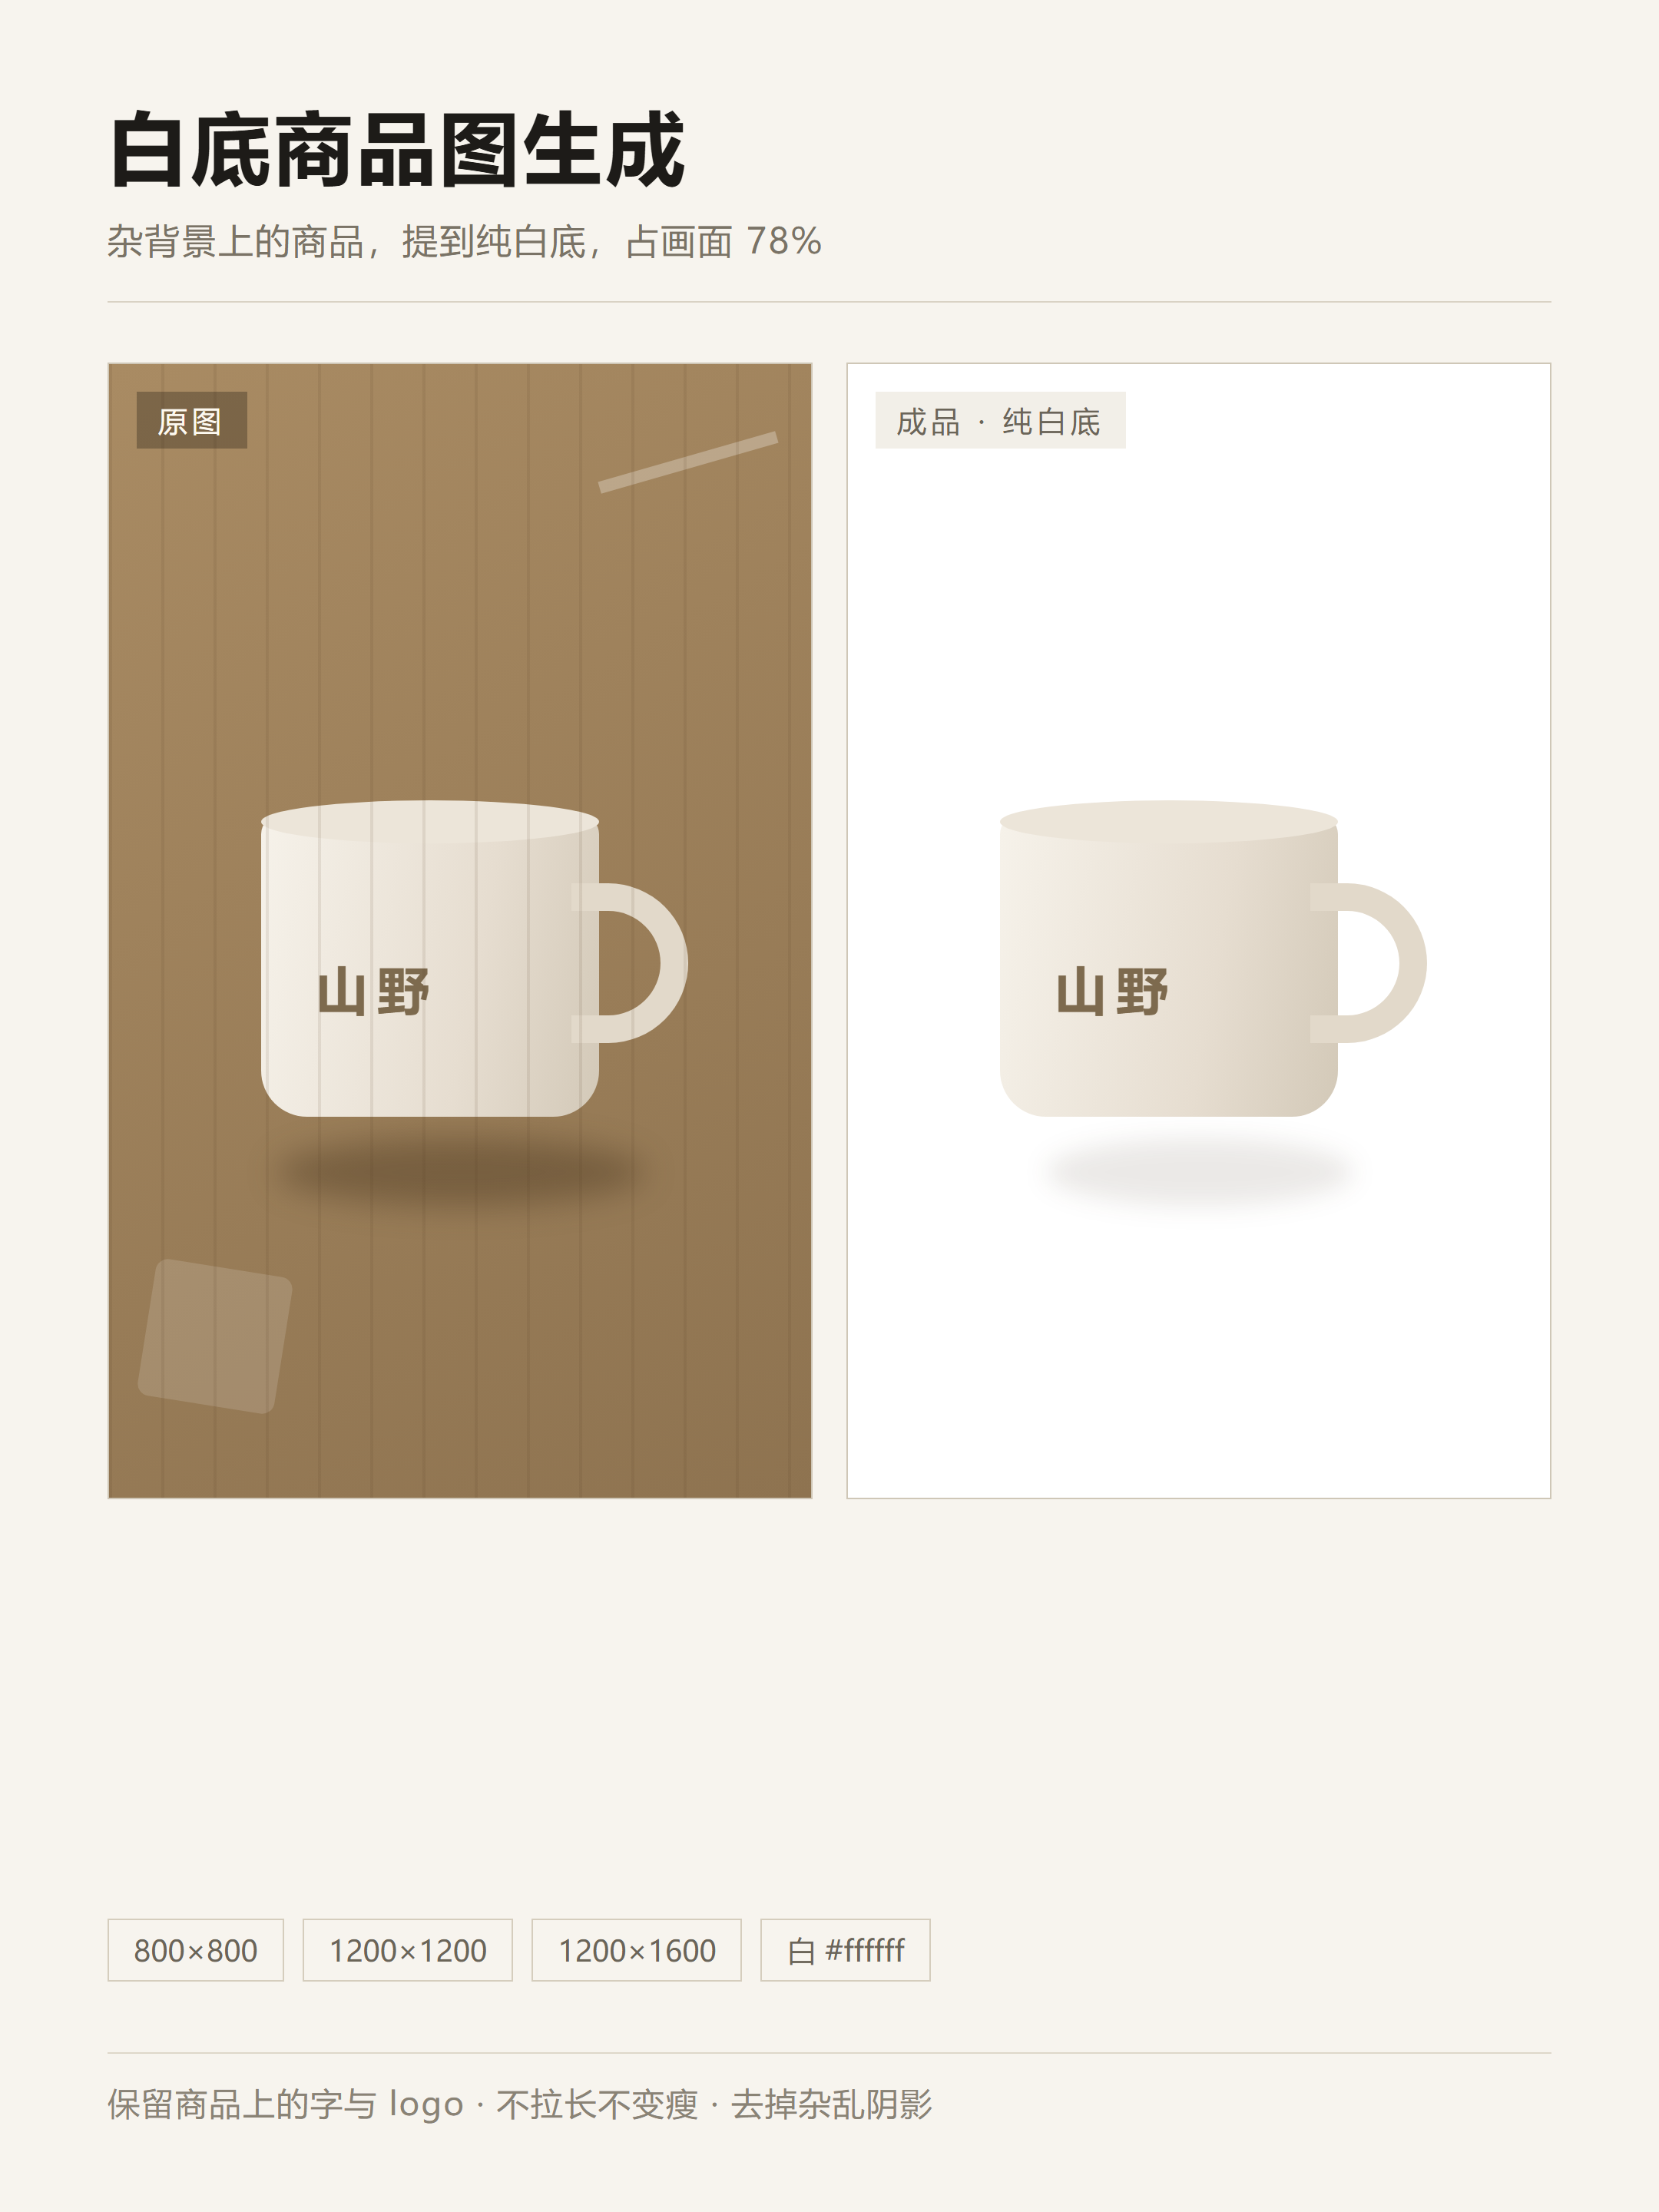
白底商品图生成
淘宝、拼多多、抖音小店,主图头一张都要求白底;自己拍总有阴影、有色偏、背景不干净。【白底商品图生成】把商品从原背景里提出来放到纯白背景上:校正角度、去掉杂乱阴影、修色偏、按平台要求留边距,输出 800×800 与 1200×1200 两个尺寸。硬规则:不改商品形状、颜色和文字;不美化到认不出;服装类不拉长不变瘦。
明信片时光机
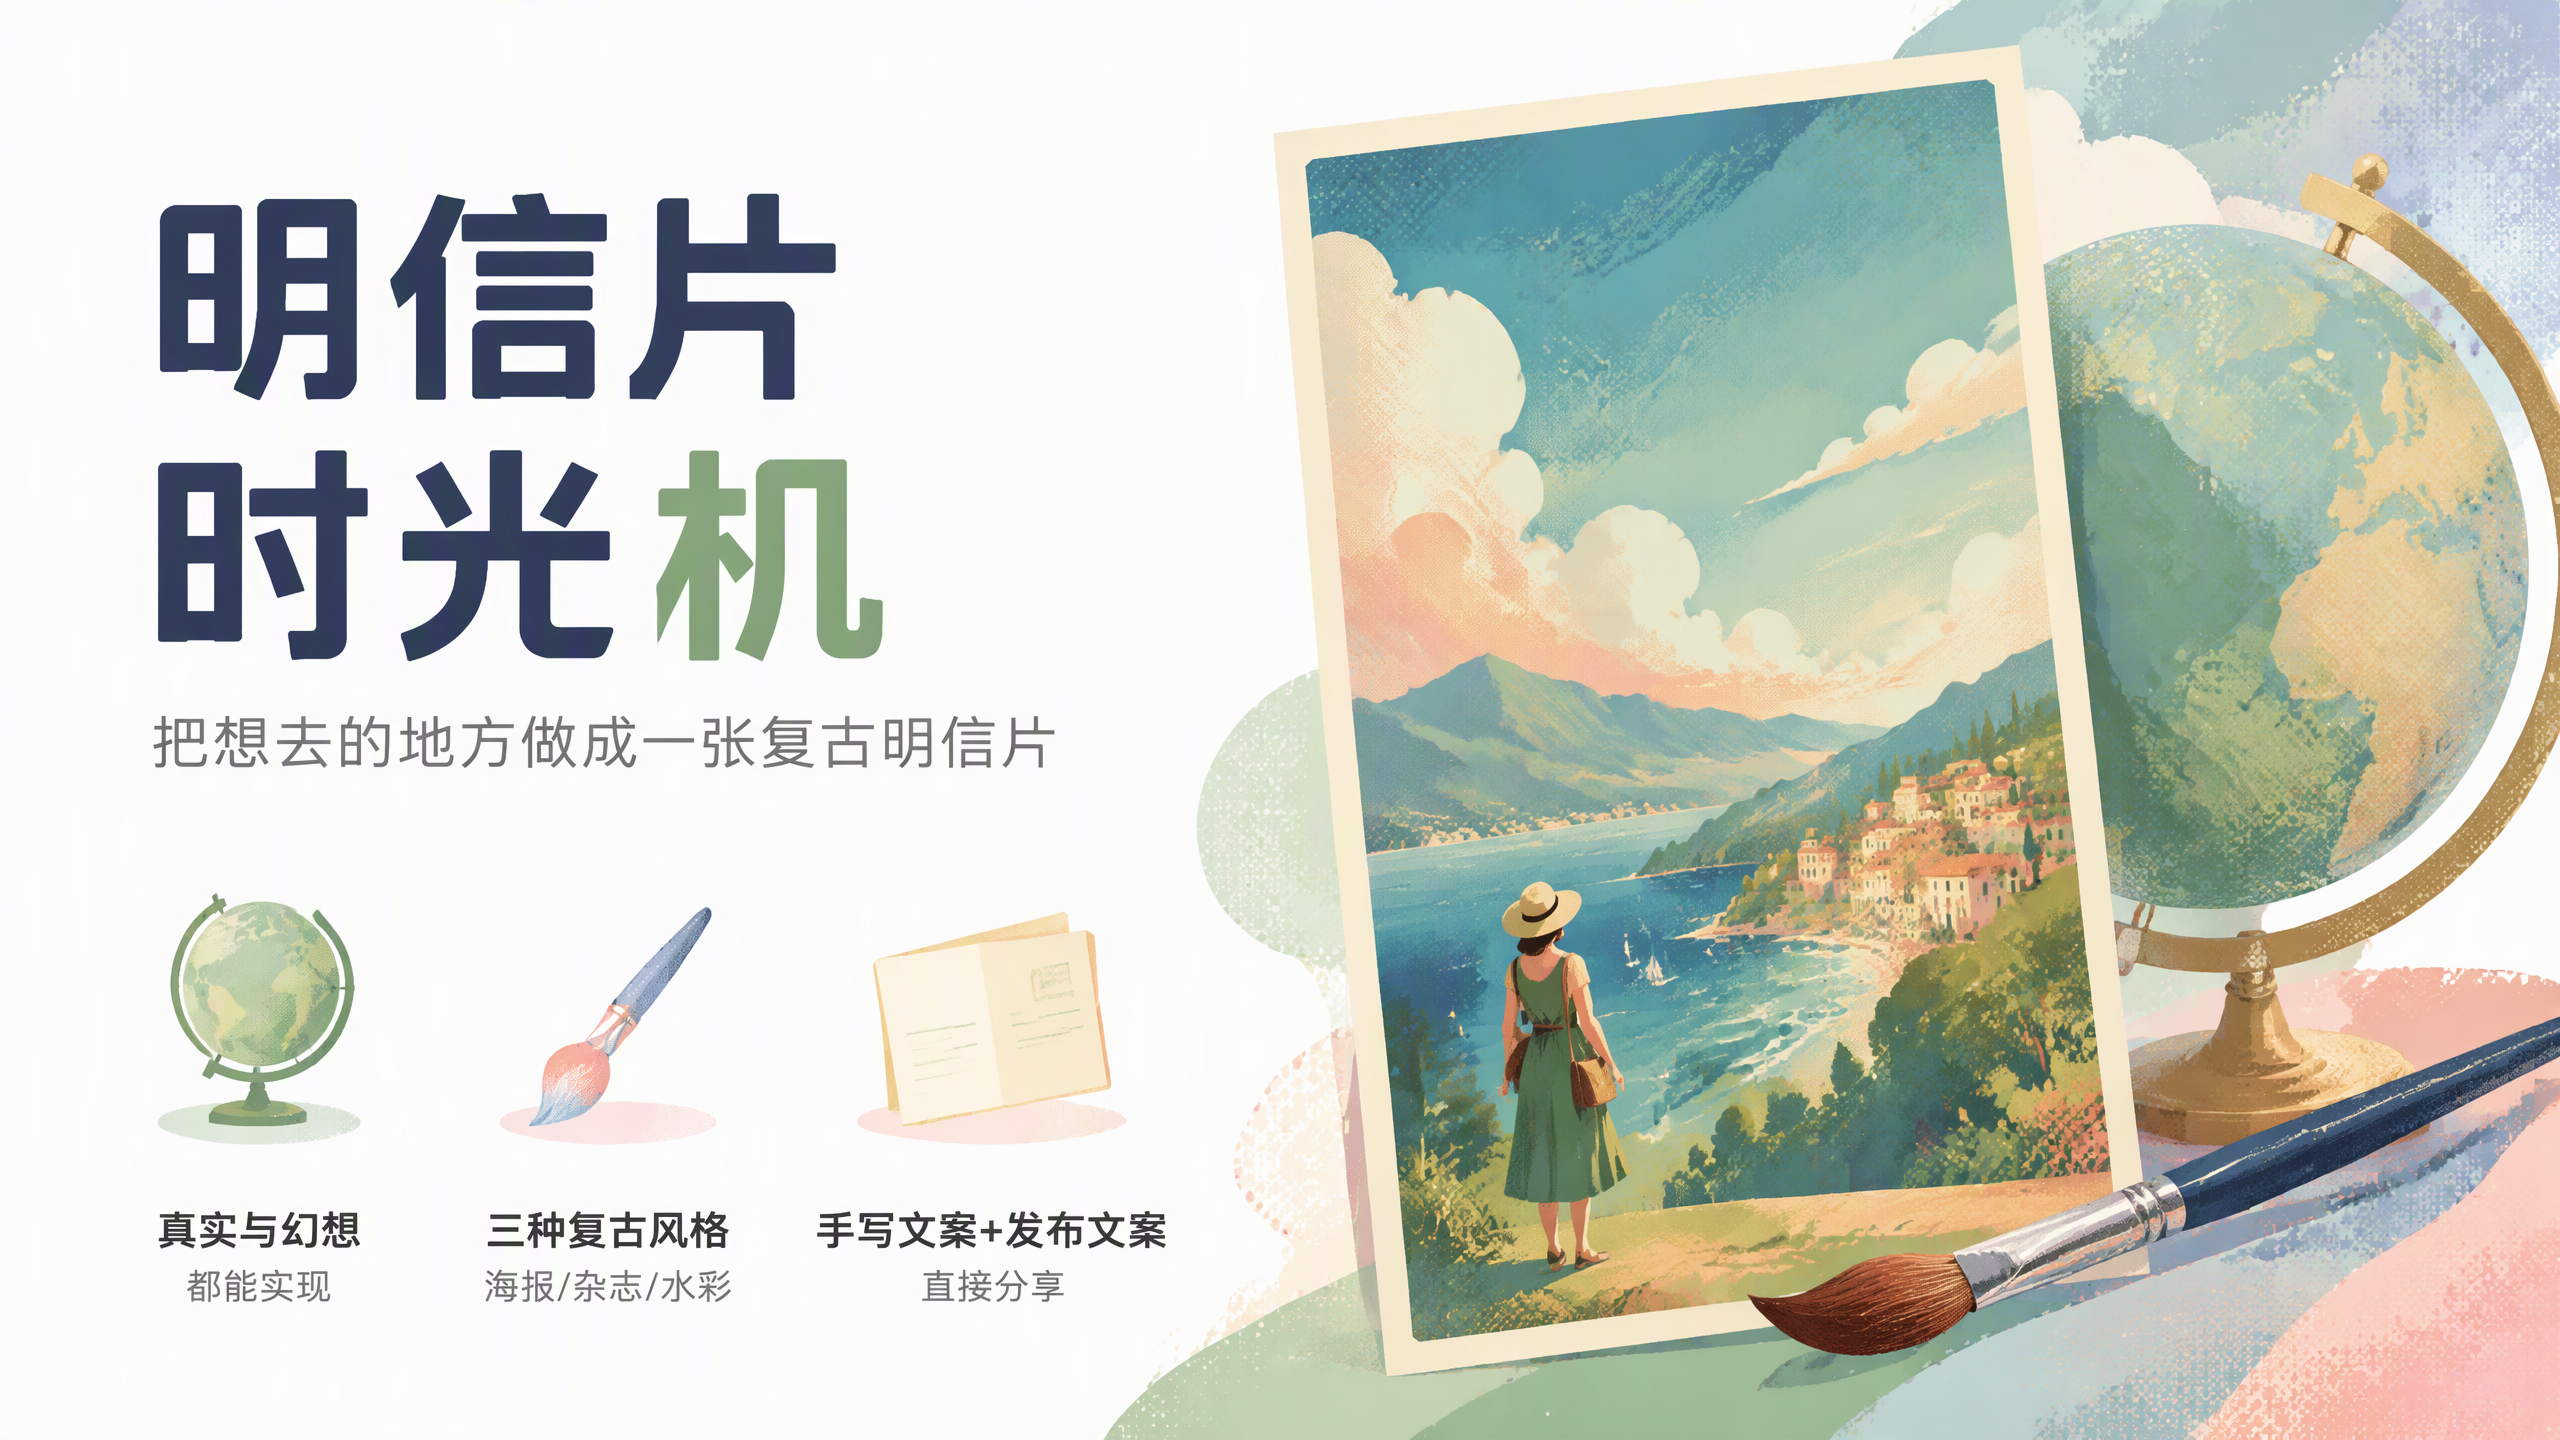
它把用户想去(或幻想去)的地方做成一张能直接发出来的复古明信片。真实地点不画地标明信片机位,而是抓「本地人才知道的角度」;幻想地点则让用户描述一两个画面细节。可选三种年代感:五六十年代旅游海报、八十年代旧杂志、手绘水彩老信片。每张附一段背面手写体文案(写给一个具体的人)、两版发布文案(朋友圈 / 小红书各一版),以及一张「成系列」的下一个目的地建议。画面固定竖版 3:4、前景放一个小人物背影制造代入感、天空留三分之一、配色不超过四色。硬规则:画面内绝不出现文字、不画邮票邮戳边框(留给用户排版)、不出现任何已有卡通形象、不模仿具名画师。适合做旅行系列图文、给朋友寄一张不存在的明信片、或单纯想把一个地方留住的人。
虚拟形象设定集
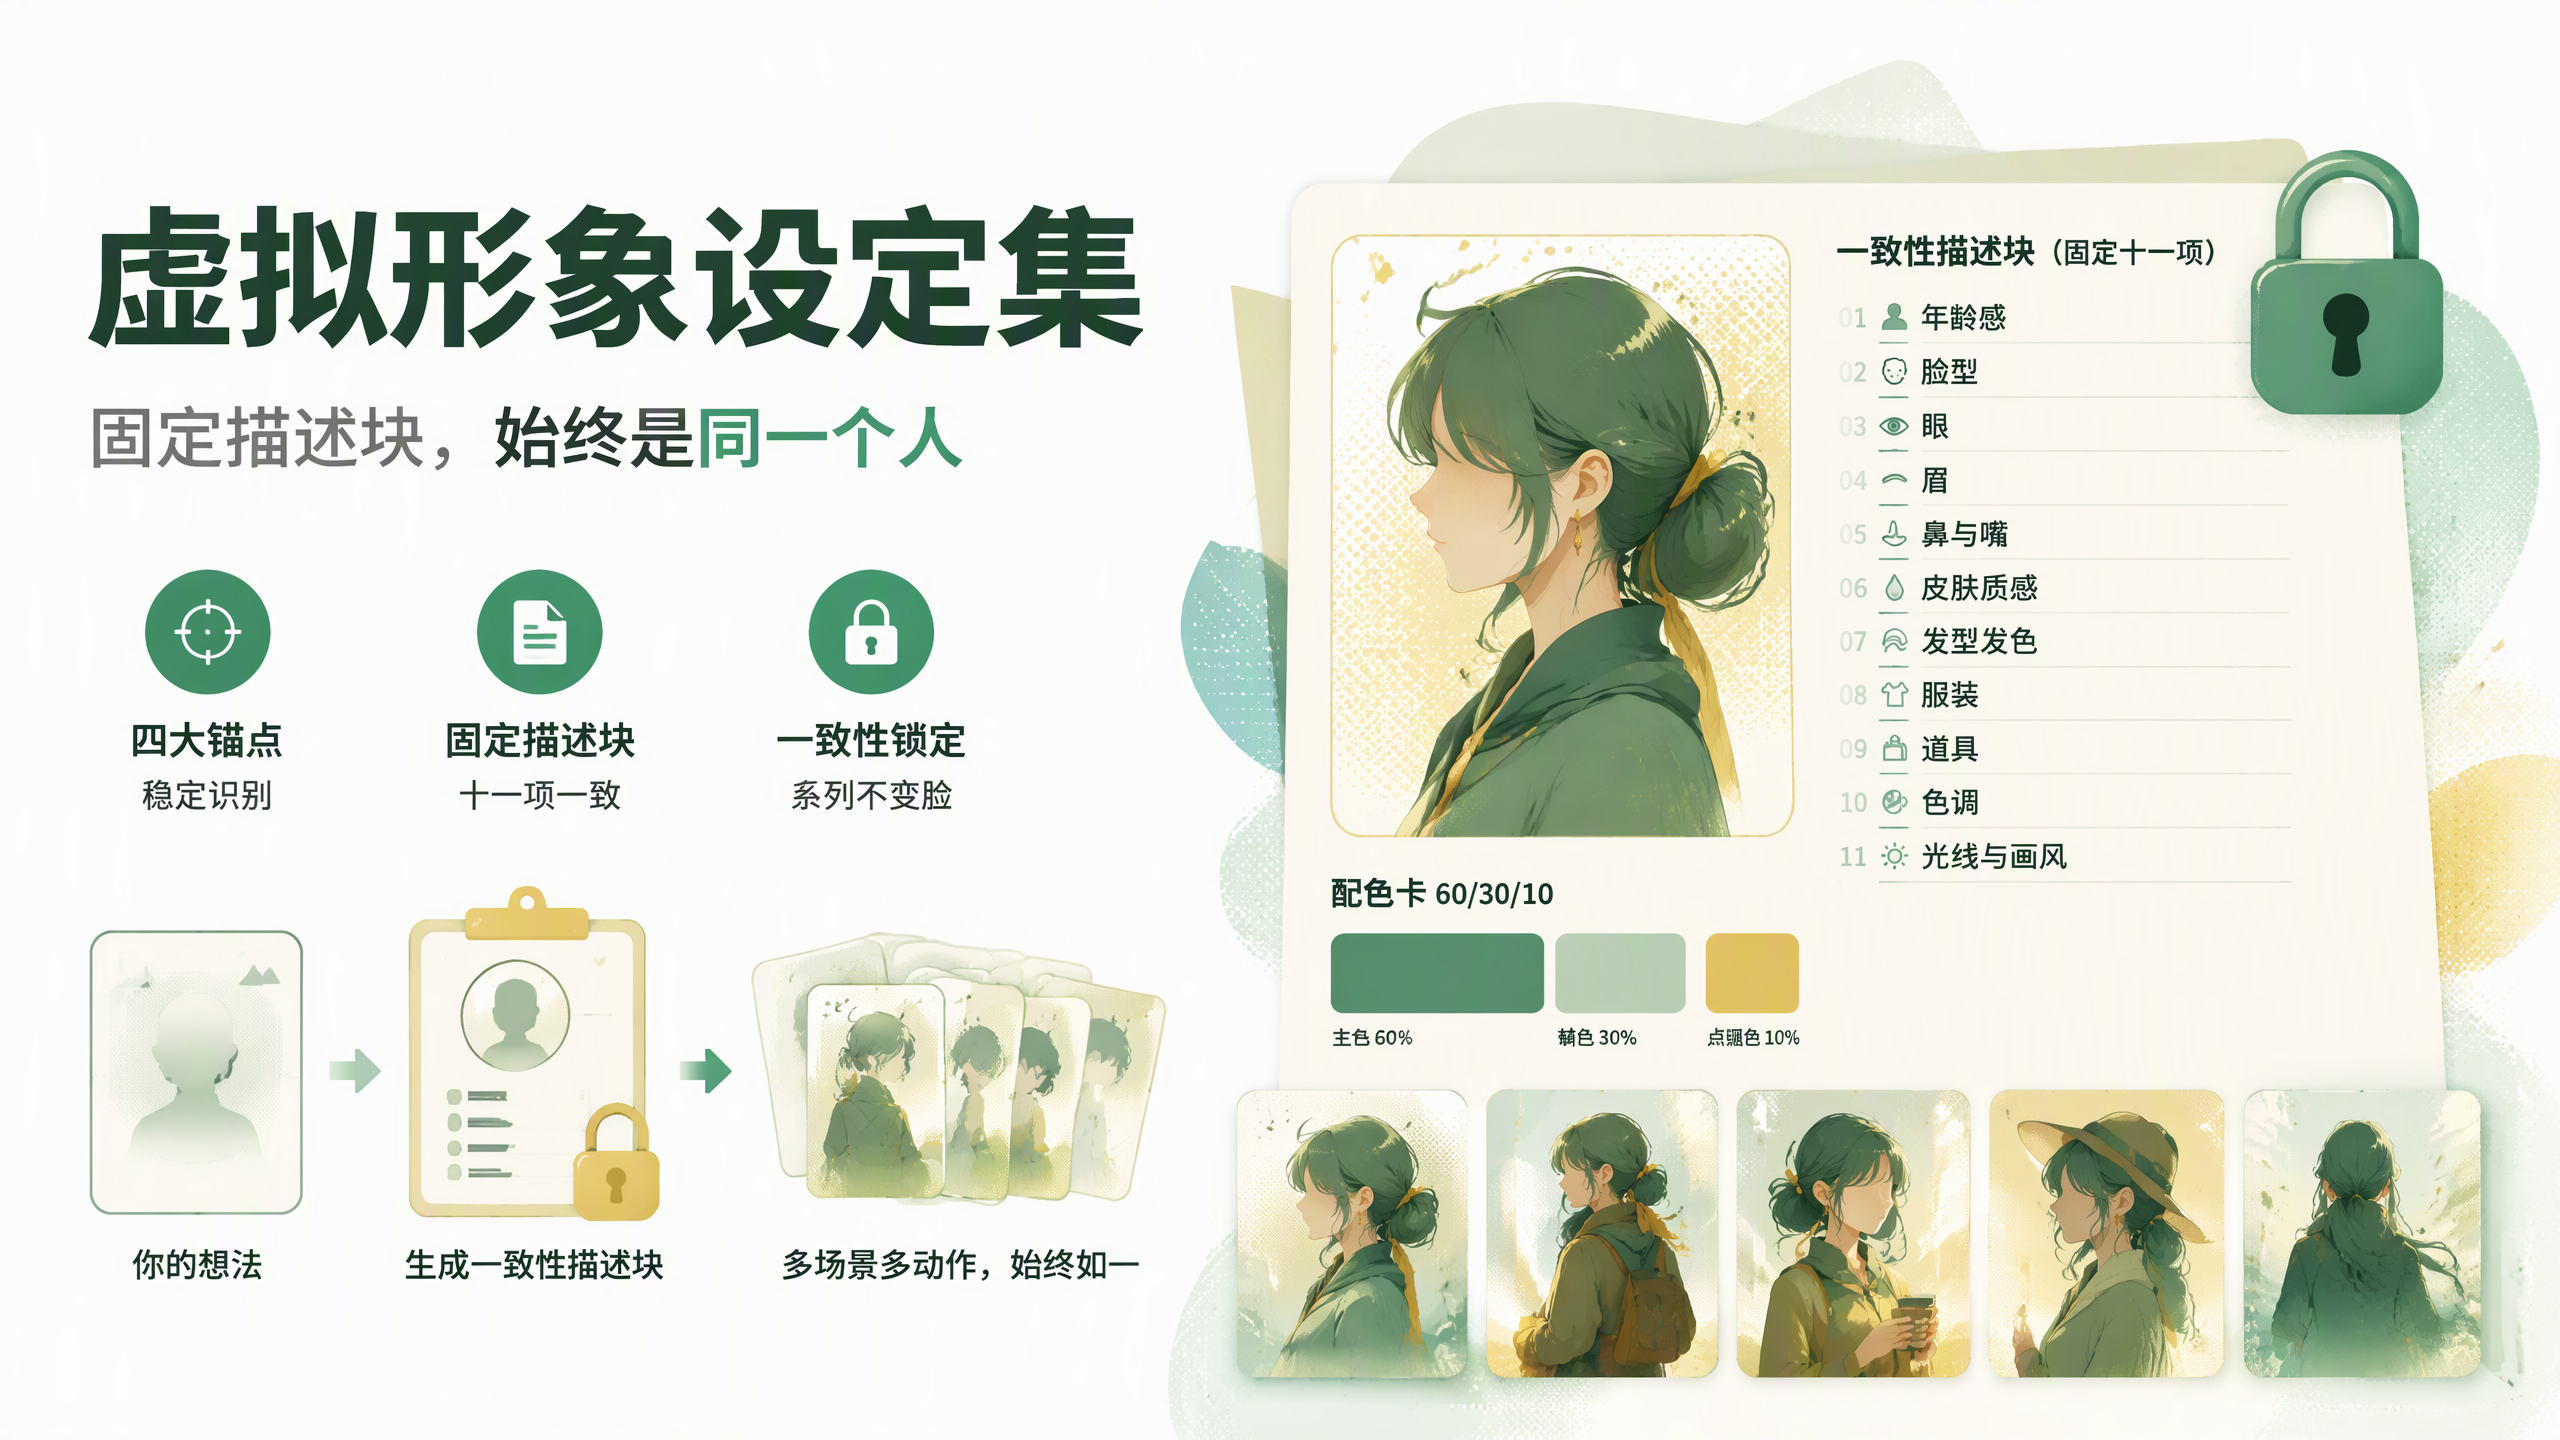
做虚拟形象最痛的一件事是:第一张好看,第二张就变成另一个人,系列内容根本做不起来。【虚拟形象设定集】就是来破解这个问题的。它先设计四个"可复述的识别点"(一个发型锚点、一个面部锚点、一个服装锚点、一个道具锚点),再产出一段**固定的一致性描述块**——按固定顺序写满十一项(年龄感、脸型、眼、眉、鼻与嘴、皮肤质感、发型发色、服装、道具、色调、光线与画风),每次生成原样复制、只改场景和动作那一句,这样五张图放一起才像同一个人。还会给五张首图方案用来验证一致性、一套配色卡(60/30/10)、以及形象使用守则(锚点不动、只改服装与场景)。硬规则:形象完全原创,不得与任何已有卡通动漫游戏影视形象相似、不得与任何真人相似、不做换脸、只从参考图提取配色与气质、不生成未成年人形象、不生成暴露或性化设计、不提供任何用于冒充真人的方案。适合想做虚拟IP、不想露脸、或要做系列插画账号的人。