Guía práctica GPT Image 2.5
Prompts y edición consistente para e-commerce
Guía práctica GPT Image 2.5
Prompts y edición consistente para e-commerce
Vista previa
Descripción
Para quienes aún no logran crear buenas imágenes con GPT Image 2.5, esta guía reúne sus capacidades clave en un flujo de trabajo fijo: elegir entre Flare y Sunburst, escribir prompts controlables con una fórmula de nueve partes, asignar funciones a las imágenes de referencia, cambiar una sola cosa a la vez y conservar el resto, mantener la coherencia de personajes y productos, extraer un fondo realmente transparente, evitar errores comunes y revisar el resultado antes de entregarlo. Se activa cuando el usuario pregunta cómo escribir prompts para GPT Image 2.5, cómo editar una imagen sin cambiar lo demás, cómo elegir entre Flare y Sunburst, cómo crear un fondo transparente, por qué el texto de una imagen sale mal escrito o cómo usar GPT Image 2.5 para trabajar por encargo o crear imágenes para e-commerce. Solo ofrece metodología, flujos de trabajo y plantillas de prompts reutilizables; no utiliza herramientas de generación de imágenes.
Ideal para
Ideal para principiantes y equipos de operaciones que necesitan crear prompts y editar de forma consistente imágenes para e-commerce, redes sociales o branding.
Cómo usar este Skill
Proporciona los datos
Indica el objetivo de generación o edición, el canal y tamaño, los requisitos del sujeto y del texto, además de las imágenes de referencia, los cambios necesarios y los elementos que deben conservarse.
Ejecuta el Skill
Organiza el prompt según el objetivo, define el papel de cada imagen de referencia, el alcance de la edición, los requisitos de consistencia y los puntos para comprobar el fondo transparente; también ofrece un flujo de trabajo práctico.
Revisa el resultado
Obtén prompts de imagen reutilizables, un plan de edición y una lista de comprobación previa a la entrega para ejecutarlos en tu herramienta de imágenes; no genera imágenes directamente.
Habilidades relacionadas
Ver todo
Experto en Dibujo Manual para IP
No es que no sepas escribir contenido, sino que a menudo te quedas atascado en el último paso: ¿qué tipo de imagen debería hacer para que este punto de vista, método o historia se vea como tú? El Experto en Dibujo Manual para IP desglosa una expresión de contenido en una forma visual adecuada y luego te brinda un conjunto de soluciones de texto e imagen que puedes implementar. Obtendrás: - Determinar si este contenido es adecuado para un diagrama de ideas, un diagrama de métodos o un diagrama de historias. - Una dirección visual dibujada a mano que coincida con tu campo y personalidad. - Una tabla de fijación de texto que primero confirmas y luego produces. - Un lienzo base dibujado a mano sin texto, o un Prompt de lienzo base sin texto listo para usar. - Instrucciones de diseño: dónde colocar títulos, pasos y texto clave, y cuánto espacio dejar. ¿Por qué dar primero un lienzo sin texto? El texto en chino debe ser preciso y editable. Aquí no permitimos que el modelo genere palabras al azar; primero diseñamos la imagen, los personajes o las escenas y dejamos espacios en blanco para el texto. Luego, con tus herramientas habituales, superpones el texto confirmado. Esto es ideal para quienes desean verificar primero si necesitan una expresión visual personal: consultores, instructores, coaches, creadores de contenido de conocimiento, o aquellos que están comenzando a construir su marca personal. Actualmente, esta habilidad puede: - Solución visual de contenido única para una sola plataforma. - Un lienzo base de vista previa sin texto o un Prompt sin texto. - Fijación de texto e instrucciones de diseño. - Extraer anclas de IP dibujadas a mano cuando hay fotos; cuando no hay fotos, usar accesorios profesionales, escenas o símbolos abstractos para establecer reconocimiento. Actualmente no hace: - Generar múltiples imágenes o tarjetas de contenido de una sola vez. - Adaptarse a múltiples plataformas simultáneamente. - Guardar archivos de IP a largo plazo entre tareas. - Generar directamente imágenes terminadas publicables con texto chino preciso. - Publicar automáticamente en cualquier plataforma. Si después de la experiencia sientes naturalmente la necesidad de múltiples imágenes, múltiples plataformas, personajes fijos a largo plazo o series de columnas, estos son escenarios que las versiones Pro y Max resuelven mejor. Esta habilidad completará primero esta experiencia sin promocionarse activamente.
Director IP Dibujado Pro
No quieres hacer solo una imagen: quieres convertir ese contenido en un conjunto de piezas realmente publicables. Director IP Dibujado Pro se encarga de la "producción de contenido de una sesión": transforma una opinión, un método o una historia en 1-3 imágenes de contenido dibujadas a mano y con continuidad narrativa, reorganizadas de forma independiente para cada plataforma que elijas, en lugar de simplemente recortarlas. Qué obtendrás Tarjeta completa de estrategia de contenido: identifica el tipo de contenido, propone la estructura del conjunto y define la adaptación multiplataforma para que la confirmes antes de empezar; Bloqueo del texto: fija uno por uno el título principal, los puntos clave de cada paso o párrafo y las palabras destacadas de cada imagen; una vez confirmado, no se reescriben al azar; 1-3 imágenes base dibujadas a mano y sin texto: se generan según la composición confirmada, sin incluir ningún texto; Instrucciones precisas de composición: especifica el tamaño de fuente, el interlineado, la alineación y los márgenes de cada zona de cada imagen para que superpongas el texto por tu cuenta; Protocolo de correcciones parciales: cambiar la composición no implica volver a dibujar la imagen base; cambiar la composición visual no modifica el texto. Se resuelve cada problema en el menor alcance posible. Sobre la capa de texto, los textos en chino deben ser precisos, editables y fáciles de corregir por zonas. La entrega estándar consiste en una imagen base sin texto + instrucciones de composición; tú añadirás el texto con la herramienta que prefieras. Cuando la plataforma anfitriona verifique que cuenta con una capacidad determinista para superponer texto, también puede ofrecerse una pieza terminada con composición precisa. Sin embargo, no es una función predeterminada y dependerá del entorno de uso de cada sesión. Admite la adaptación simultánea para un máximo de 3 plataformas: Xiaohongshu, cuenta oficial de WeChat y Momentos. Cada plataforma se reorganiza de forma independiente según la proporción, la cantidad de texto y el ritmo narrativo; no se limita a recortar la misma imagen. Ideal para Consultores, docentes, coaches y responsables de operaciones que necesitan convertir de forma estable un contenido completo en piezas gráficas publicables, no solo generar una imagen rápida. Actualmente no incluye Piezas terminadas con texto chino integrado automáticamente y con precisión (la entrega estándar es una imagen base sin texto + instrucciones de composición); Guardado automático del perfil de IP entre tareas (el DNA es válido dentro de la sesión o el proyecto actual; puedes llevar un resumen para usarlo la próxima vez); Sistemas de secciones fijas o recursos de personajes a largo plazo (estos son escenarios más adecuados para Max); Uso ilimitado
 Imagen
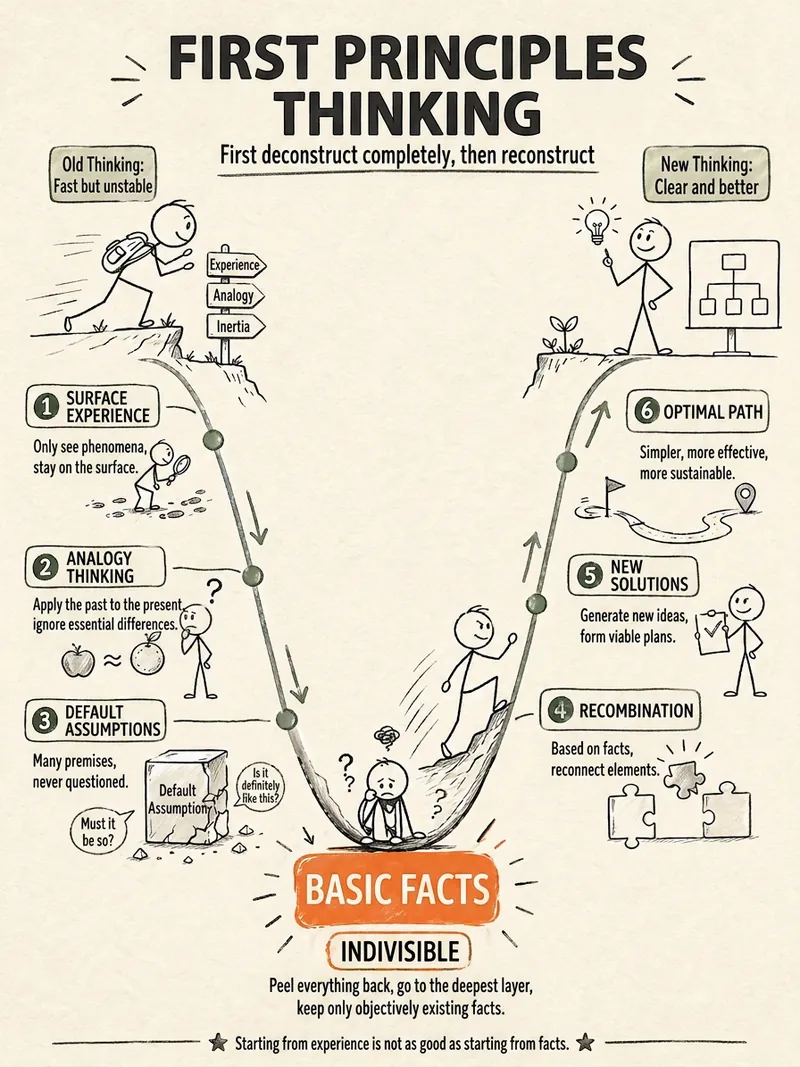
Diagramas de palitos
Convierte conceptos complejos, teorías abstractas, procesos extensos, apuntes, análisis empresariales o historias de crecimiento en tarjetas verticales de conocimiento, infografías y prompts de ilustración hechos a mano, ideales para generar imágenes con GPT-Image 2. Ya sea para organizar procesos, comparar situaciones, analizar causas, clasificar conocimientos o narrar un crecimiento desde un punto bajo hasta un avance, extrae las conclusiones clave y las combina con una composición, metáfora visual y recorrido de lectura adecuados, para que el contenido se entienda y recuerde de un vistazo. Obtendrás una explicación en chino de la estructura de la tarjeta y recomendaciones para el sistema visual, que incluyen la composición, el estilo dibujado a mano, la filosofía del color y la personalidad tipográfica, además de un prompt en inglés para generar imágenes, listo para copiar y usar. El formato vertical predeterminado es 3:4, ideal para tarjetas de conocimiento, tarjetas de Xiaohongshu, infografías verticales y pósteres. Según el tema, puedes elegir figuras de palitos, personajes simplificados o íconos para representar estados, acciones y emociones, mientras controlas la cantidad de módulos de información para evitar composiciones saturadas, texto demasiado pequeño o una distribución dispersa de los elementos principales. Ideal para convertir rápidamente apuntes de lectura, metodologías, habilidades profesionales, temas de psicología y crecimiento, perspectivas empresariales, procesos de producto y conceptos complejos en expresiones visuales claras, narrativas y prácticas.
Información
- Versión
- v3
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Automático
- Casos de uso
- Imágenes y diseñoMarketing y crecimientoComercio electrónico y ventas
- Qué obtendrás
- PromptPlan
