9D деконструктор візуалу
Розбирає інфографіку й створює промпти
9D деконструктор візуалу
Розбирає інфографіку й створює промпти
Попередній перегляд
Опис
Розкладає одну чи кілька інфографік, візуалізацій даних, блок-схем, часових шкал, карт, графів знань і організаційних діаграм на повторно використовувані візуальні та інформаційні структури. Це допомагає точно зрозуміти, чому зображення організоване саме так, і відтворити подібний спосіб подання. Навичка аналізує просторову композицію, виміри й матеріали, колірну ієрархію, шрифти та типографіку, взаємозв’язки між модулями й інші візуальні чинники. Водночас вона розпізнає кодування даних у діаграмах, траєкторію читання, метафори піктограм, а також географічні чи мережеві зв’язки, щоб аналіз не обмежувався лише питанням «на що це схоже за стилем». Ви отримаєте параметризований результат візуальної декомпозиції, що охоплює логіку полотна й композиції, візуальну ієрархію, щільність тексту, топологію модулів, способи подання даних і зв’язків, а також сюжетну лінію зображення. Для статистичних діаграм, карт або мережевих графів результат зосереджується на тому, як дані відображаються через колір, положення, розмір, лінії зв’язку, вузли та інші візуальні змінні. Для складних тематичних схем додатково розкривається узгоджена взаємодія графіки, тексту й системи метафор. На основі цього аналізу навичка створює докладні, чітко структуровані англомовні промпти для генерації зображень. Вони підходять для відтворення інфографіки, візуальних досліджень, пошуку дизайнерських рішень, розробки брендованого контенту та створення концептуальних зображень. Незалежно від того, надаєте ви готове зображення чи описуєте задум щодо теми й візуального напряму, ви отримаєте промпти, наближені до відтворення структури, а не загальний опис стилю.
Схожі навички
Переглянути всі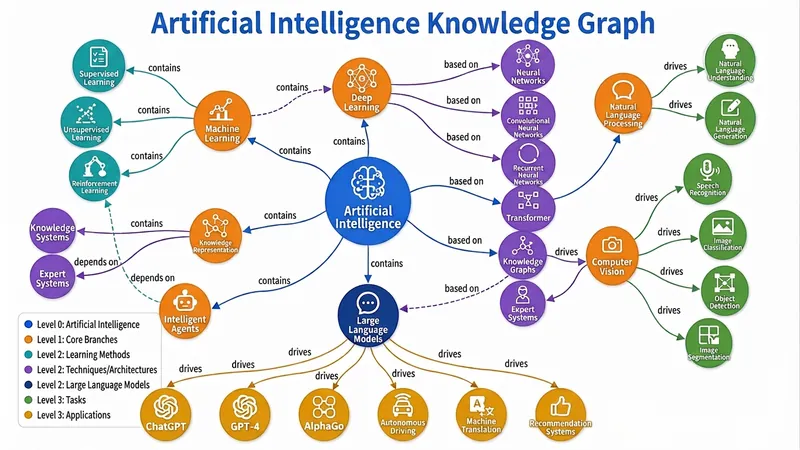
Двигун графів знань
Автоматично будує п'ять типів графів (граф знань, ментальна карта, концептуальна карта, блок-схема/архітектурна діаграма, діаграма зв'язків) з тексту, файлів або теми, надаючи триєдине рішення: інтерактивна веб-сторінка, статичне зображення високої якості та код візуалізації. Поєднує найкращі практики інженерії графів знань та візуалізації інформації, підтримує динамічний контроль деталізації, усунення неоднозначностей і дублікатів, та перехресну перевірку з кількох джерел. Перетворюйте ваш текст, файли або навіть думку на інтерактивний граф знань, який можна перетягувати, масштабувати та шукати, і одним клацанням експортуйте зображення високої якості та готовий код — це триєдиний двигун візуалізації знань, якого ви ще не бачили. 🧠 Що таке «Двигун графів знань»? Це не простий інструмент для малювання, а інженер знань і експерт з візуалізації, який живе у вашому браузері. Дайте йому текст підручника, статтю, PDF або просто ключове слово, і він автоматично: 🔍 Виймає основні сутності, прояснює глибокі зв'язки 🧱 Будує структурований JSON графа (граф знань/ментальна карта/концептуальна карта/блок-схема/діаграма зв'язків) 🎨 Виводить три найкращі форми: інтерактивна веб-сторінка + статичне зображення високої якості + код Markdown/Mermaid/Graphviz Відтепер впорядкування інформації не вимагає ручного малювання рамок, а представлення знань більше не є просто статичною картинкою. ⚡ Чому це «найкраще»? 1. Повністю автоматизований конвеєр «від тексту до графа» Не потрібно вивчати мови моделювання або вручну визначати вузли та зв'язки. Просто введіть вміст, і двигун автоматично визначить тип графа: Предметна система знань? → Генерує семантично багатий граф знань Розбір читацьких нотаток? → Генерує чітку ієрархічну ментальну карту Процеси та рішення? → Генерує блок-схему/архітектурну діаграму з гілками Мережа зв'язків між людьми? → Генерує багатовимірну діаграму зв'язків Навіть якщо ви просто введете тему, він самостійно збере матеріали, доповнить вміст і створить граф. 2. Триєдиний вихід, що охоплює всі сценарії використання 🖱️ Інтерактивна веб-сторінка на D3.js: перетягуйте вузли, масштабуйте коліщатком, натискайте для деталей, виділяйте пов'язані шляхи, шукайте ключові слова... Як робота з живою картою. Один HTML-файл, без бекенду, можна вбудувати в будь-яку сторінку або надіслати будь-кому. 🖼️ Статичне зображення графа високої якості: силове компонування, кольорове кодування категорій, готове для ілюстрацій у статтях, презентаціях PowerPoint, навчальних матеріалах — чітке до останнього тега. 📜 Код візуалізації: одночасно генерується код Mermaid та Graphviz, який розробники можуть прямо вставити в документацію, вікі, Notion для подальшого редагування. 3. Відмінний досвід користувача 🎨 Кольори автоматично зіставляються з типами сутностей, ієрархія виражається через розмір вузла 🔗 Мітки зв'язків відображаються безпосередньо на кривих — одразу видно «включає», «призводить до», «підтримує» 💡 Натисніть на будь-який вузол — не пов'язані частини автоматично зникають, фокусуючи думку 🔄 Скидання компонування, пошук позиції, масштабування та панорамування — всі дії плавні 4. Інженерна мудрість, що поєднує «широту» та «глибину» Від усунення неоднозначностей і дублікатів сутностей до перехресної перевірки з різних джерел; від контролю рівня деталізації до пунктирних ліній, що підтримують міжпредметні зв'язки — це найкращі практики інженерії графів знань, не іграшка, а інструмент продуктивності. 👥 Кому це потрібно найбільше? Вчителі та творці освітнього контенту Перетворюйте цілі розділи підручників на інтерактивну карту знань, студенти одразу розуміють зв'язки між поняттями. Дослідники та студенти Огляди літератури більше не будуються лише на тексті — один граф прояснює теоретичні зв'язки десятків статей. Продукт-менеджери та корпоративні архітектори Системна архітектура, бізнес-процеси, декомпозиція функцій — миттєво створюйте архітектурні діаграми, подвоюючи ефективність комунікації. Читачі та люди, що навчаються протягом усього життя Нотатки більше не є просто планом, а досліджуваною мережею думок, яка дозволяє знанням справді «зростати» разом. 🚀 Тепер дозвольте вашим знанням «ожити» Ви даєте вміст — він дає інсайти. Ви даєте тему — він дає систему. Ви даєте потребу — він дає повний результат: веб-сторінку, зображення, код. Це не функція, це робочий процес, що перетворює інформацію на пізнання. Нехай «Двигун графів знань» стане продовженням вашого мислення, візуалізуйте вашу експертизу та досягайте «aha moment» кожного користувача. — Від сьогодні більше не «малюйте» графи, а «породжуйте» їх.
 Зображення
(Вірусний) інфографер
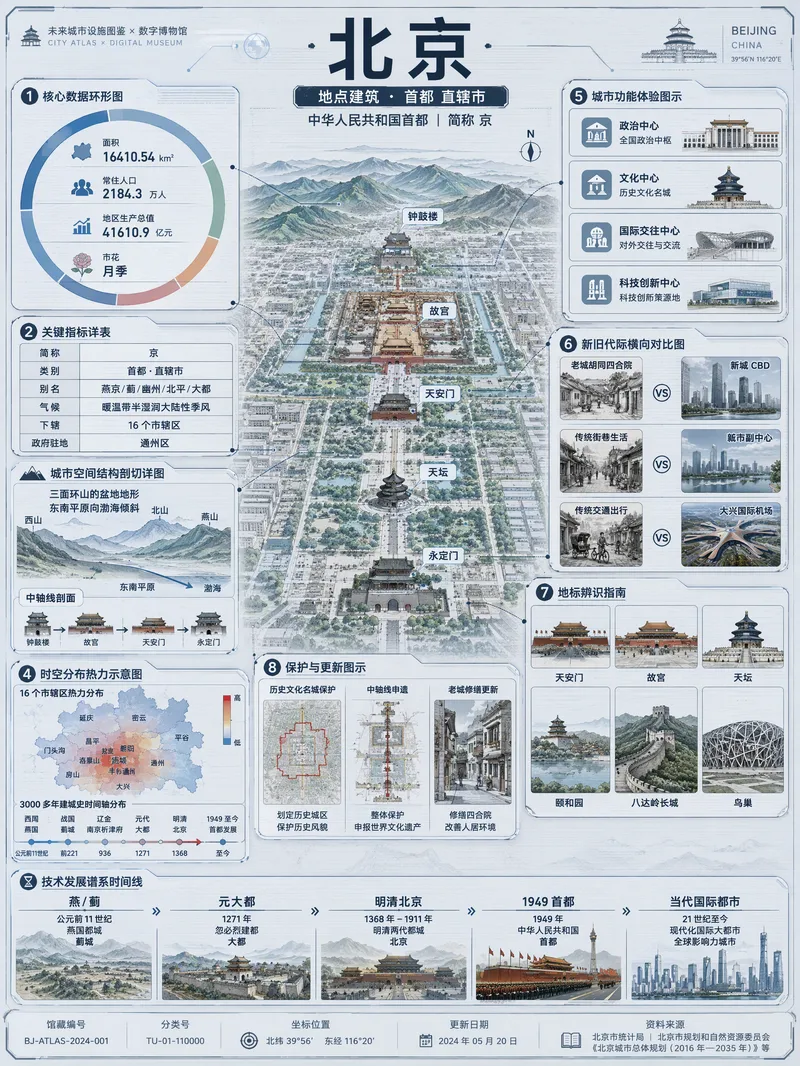
Швидко перетворює назву об’єкта на науково-ілюстрований постер із високою щільністю знань і виразною візуальною подачею. Це можуть бути живі організми, мінерали та матеріали, рукотворні об’єкти, місця й архітектурні споруди, культурні поняття або історичні постаті. Вміст можна адаптувати до вашої аудиторії, акцентів і мовних вимог, щоб він підходив для демонстрації та поширення. Спочатку навичка перевіряє в реальному часі через вебпошук визначення, ключові дані, склад і будову, поширення, застосування, розвиток та характерні ознаки об’єкта. Потім оформлює матеріал у вертикальну інфографіку формату 3:4. У центрі розміщується головний об’єкт у стилі музейного зразка, а навколо — дев’ять адаптивних інформаційних блоків: ключові показники, аналіз будови, просторово-часове поширення, опис контексту, порівняльні відомості, ознаки ідентифікації, поради щодо збереження або обслуговування, хронологія розвитку та інші матеріали. Теми блоків і змістові акценти змінюються залежно від типу об’єкта. Готовий постер використовує світло-сіро-блакитну технологічну основу, точні лінійні креслення, приглушені блакитно-бірюзові акварельні акценти та напівпрозору текстуру сканування. Візуальний стиль поєднує каталог міських об’єктів майбутнього з інформаційною панеллю цифрового музею, зберігаючи ідентифікатор об’єкта у верхній частині та зону музейних відомостей унизу. Для маловідомих об’єктів або за недостатньої кількості даних припущення позначаються окремою візуальною зоною. Підходить для науково-популярної освіти, презентацій виставок, поширення знань і публікацій у соціальних мережах.
 Зображення
Моно-но-аваре, вабі-сабі, юґен
Перетворює теми, сцени, образи людей, класичну поезію або фотографії на зображення в японській естетиці з чітким концептуальним підґрунтям і візуальною логікою. Підходить творцям, яким потрібні тонка розповідь і продумане мистецьке керування. Навичка обирає моно-но-аваре, вабі-сабі або юґен як провідний напрям відповідно до змісту: моно-но-аваре передає красу того, що минає, вабі-сабі показує сліди, залишені матеріалами й часом, а юґен створює стриману глибину через приховування, відстань, порожній простір і невидиме; поєднання використовується лише тоді, коли тема справді містить кілька взаємопов’язаних естетичних логік. Ви отримаєте чітке визначення теми, провідну естетику, зв’язок між напрямами, орієнтири з історії мистецтва та основну розповідь. Далі навичка створить професійний візуальний промпт із описом об’єкта, середовища, композиції, просторових рівнів, матеріалів, кольорів, освітлення, настрою та негативних обмежень, не зводячи «японський стиль», «дзен» або «вишуканість» до порожніх ярликів. Для портретних фотографій вона намагатиметься зберегти ідентичність, структуру обличчя, відчуття віку, статуру та основні особливості одягу, виконуючи естетичне перетворення через середовище, світло й розповідь, а не автоматично перетворюючи людину на персонажа в кімоно. Після підтвердження навичка покаже повний промпт і згенерує зображення, а також надасть пояснення естетики, щоб допомогти зрозуміти, як у кадрі втілено красу минущого, слідів часу або невидимого. Підходить для концептуального мистецтва, перетворення фотографій у різні стилі, візуалізації класичної поезії, створення сцен із людьми, просторової розповіді та генерації зображень зі звучанням японської естетики.
Інформація
- Версія
- v3
- Останнє оновлення
- Кредити за запуск
- За фактичним використанням
- Моделі
- Автоматично