GPT Image 2.5: guia prático
Prompts e edição consistente para e-commerce
GPT Image 2.5: guia prático
Prompts e edição consistente para e-commerce
Prévia
Descrição
Para iniciantes que ainda não sabem usar o GPT Image 2.5 para criar boas imagens, este guia organiza os principais recursos do GPT Image 2.5 em um fluxo de trabalho fixo: escolher entre Flare e Sunburst, escrever prompts controláveis com a fórmula de nove partes, definir o papel de cada imagem de referência, alterar uma coisa por vez e preservar o restante, manter a consistência de personagens, produtos e elementos, recortar com fundo realmente transparente, evitar erros comuns e revisar tudo antes de gerar a imagem. É indicado quando o usuário pergunta como escrever prompts para o GPT Image 2.5, como editar uma imagem sem alterar outras partes, como escolher entre Flare e Sunburst, como criar um fundo transparente, por que o texto na imagem sai errado ou como usar o GPT Image 2.5 para aceitar trabalhos ou criar imagens para e-commerce. O guia oferece apenas metodologia, fluxo de trabalho e modelos de prompts copiáveis; não chama ferramentas de geração de imagens.
Habilidades relacionadas
Ver tudo
Guia de Desenho à Mão IP
Você não tem dificuldade em criar conteúdo, mas muitas vezes trava no último passo: qual tipo de imagem essa opinião, método ou história deve se tornar para parecer com você? O Guia de Desenho à Mão IP vai primeiro decompor sua expressão de conteúdo em uma forma visual adequada e depois fornecer um conjunto de soluções gráficas e textuais que podem ser colocadas em prática. Você receberá: - Uma avaliação se o conteúdo é mais adequado para um gráfico de opinião, método ou história; - Uma direção de desenho à mão que combina com sua área e personalidade; - Uma tabela de bloqueio de texto para aprovação antes da produção; - Um fundo desenhado à mão sem texto, ou um Prompt de fundo sem texto pronto para uso; - Instruções de layout: onde colocar títulos, etapas e textos importantes, e quanto espaço deixar. Por que fornecer primeiro um fundo sem texto? O texto em chinês deve ser preciso e editável. Aqui, não deixamos o modelo de geração desenhar texto aleatoriamente; em vez disso, projetamos a imagem, personagens ou cena e os espaços em branco para o texto, permitindo que você sobreponha o texto aprovado usando suas ferramentas familiares. Isso é adequado para quem quer verificar primeiro se precisa de uma expressão visual pessoal: consultores, palestrantes, coaches, criadores de conteúdo de conhecimento, ou aqueles que estão começando a construir sua marca pessoal. Atualmente, essa skill pode: - Criar uma solução visual para um único conteúdo em uma única plataforma; - Gerar um fundo de visualização sem texto ou um Prompt sem texto; - Fornecer bloqueio de texto e instruções de layout; - Extrair âncoras de IP de desenho à mão a partir de fotos; na ausência de fotos, usar objetos profissionais, cenas ou símbolos abstratos para estabelecer reconhecimento. Atualmente, não faz: - Gerar várias imagens ou conjuntos de cartões de conteúdo de uma só vez; - Adaptar-se simultaneamente a várias plataformas; - Manter arquivos de IP a longo prazo entre tarefas; - Gerar imagens finais publicáveis com texto chinês preciso; - Publicar automaticamente em qualquer plataforma. Se, após a experiência, você naturalmente precisar de várias imagens, várias plataformas, um personagem fixo a longo prazo ou uma série columnizada, esses cenários serão mais adequados para as versões Pro e Max subsequentes. Esta skill completará esta experiência primeiro e não fará vendas ativas.
Diretor de Conteúdo IP Pro
Você não quer apenas criar uma imagem — quer transformar este conteúdo em um conjunto realmente pronto para publicar. O Diretor de Conteúdo IP Pro cuida da “produção de conteúdo da sessão”: transforma uma ideia, um método ou uma história em 1–3 imagens de conteúdo desenhadas à mão e com narrativa coerente, reorganizadas individualmente para cada plataforma escolhida, em vez de apenas recortadas. Você recebe Estratégia de conteúdo completa: identifica o tipo de conteúdo, propõe a estrutura do conjunto e define a adaptação para várias plataformas, para você confirmar antes da execução; Texto bloqueado: título principal, pontos de cada etapa ou parágrafo e palavras-chave de cada imagem são definidos individualmente. Depois da confirmação, não são reescritos aleatoriamente; 1–3 imagens-base desenhadas à mão, sem texto: geradas conforme a composição aprovada e sem qualquer texto; Instruções precisas de diagramação: especificações de tamanho da fonte, espaçamento entre linhas, alinhamento e margens de cada área de cada imagem, para você sobrepor o texto por conta própria; Protocolo de revisão parcial: alterar a diagramação não exige redesenhar a imagem-base; alterar a composição não modifica o texto — cada problema é resolvido no menor escopo possível. Sobre a camada de texto O texto em chinês deve ser preciso, editável e passível de revisão parcial. A entrega padrão é uma imagem-base sem texto + instruções de diagramação, para que você adicione o texto usando a ferramenta com que já está familiarizado. Quando a plataforma hospedeira verificar que possui capacidade de sobreposição precisa e determinística de texto, também poderá fornecer a composição final diagramada — mas isso não é uma função padrão e depende do ambiente de uso em cada ocasião. É possível adaptar simultaneamente até 3 plataformas: Xiaohongshu, conta oficial e Moments. Para cada plataforma, a composição é reorganizada de forma independente conforme proporção, volume de texto e ritmo narrativo — não se trata de simplesmente recortar a mesma imagem. Indicado para Consultores, instrutores, coaches e profissionais de operações que precisam transformar um conteúdo completo em material visual publicável de forma consistente, e não apenas gerar uma imagem avulsa. Não faz atualmente Composição automática e precisa de texto em chinês na imagem final (a entrega padrão é uma imagem-base sem texto + instruções de diagramação); Salvamento automático do arquivo do IP entre tarefas (o DNA é válido dentro da sessão ou do projeto atual; é possível levar um resumo para uso posterior); Sistemas fixos de séries de conteúdo ou ativos permanentes de personagens (esses são cenários mais adequados para Max); Uso ilimitado.
 Imagem
Diagramas com Bonecos de Palito
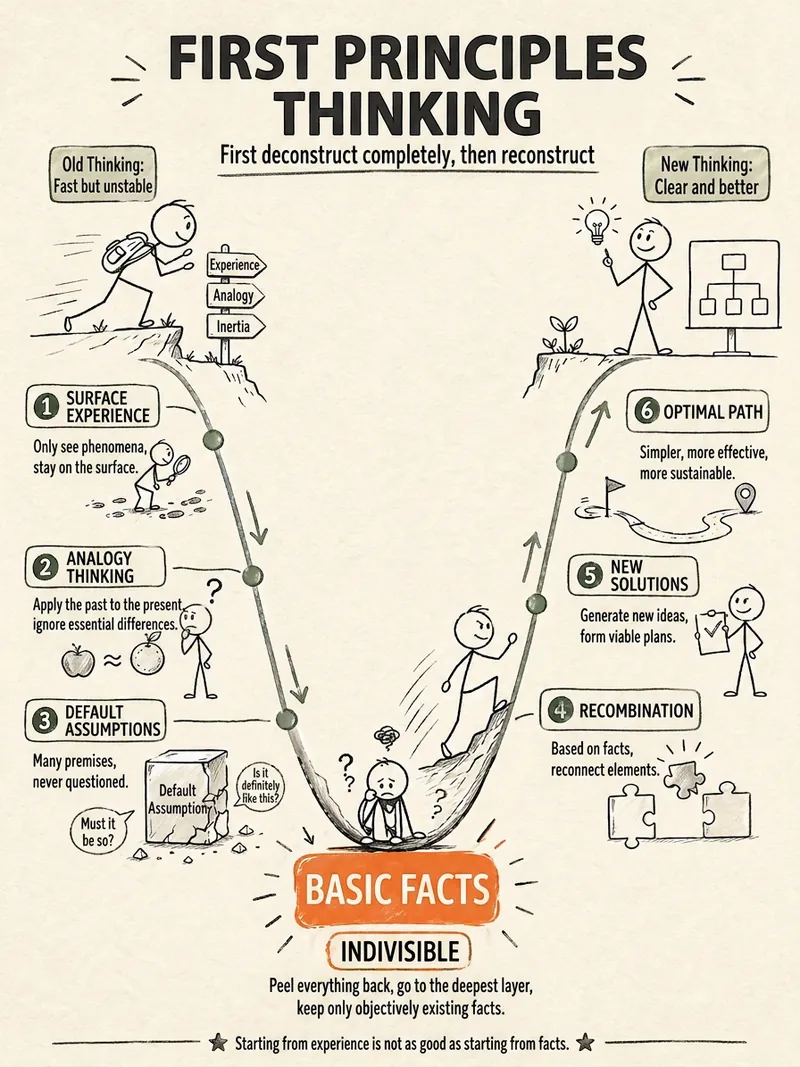
Transforme conceitos complexos, teorias abstratas, processos longos, anotações de estudo, análises de negócios ou histórias de crescimento em cards verticais de conhecimento, infográficos e prompts de diagramas desenhados à mão, adequados para geração com GPT-Image 2. Seja para organizar processos, comparar antes e depois, analisar causas, categorizar conhecimentos ou narrar uma trajetória de crescimento, extraia as conclusões centrais e combine composição, metáforas visuais e fluxo de leitura adequados para tornar o conteúdo mais fácil de entender e memorizar à primeira vista. Você receberá uma descrição da estrutura dos cards e sugestões de sistema visual em chinês, incluindo composição, estilo desenhado à mão, filosofia das cores, personalidade tipográfica e um Prompt em inglês para geração de imagens, pronto para copiar e usar. O formato padrão é vertical, na proporção 3:4, adequado para cards de conhecimento, cards para Xiaohongshu, infográficos verticais e pôsteres. Conforme o tema, é possível escolher bonecos de palito, personagens simplificados ou ícones para representar estados, ações e emoções, controlando também a quantidade de módulos de informação para evitar imagens sobrecarregadas, textos pequenos demais ou pontos principais dispersos. Ideal para transformar rapidamente anotações de leitura, metodologias, habilidades profissionais, temas de psicologia e crescimento, insights de negócios, fluxos de produtos e conceitos complexos em uma expressão visual clara, com narrativa e prática.
Informações
- Versão
- v3
- Última atualização
- Créditos por execução
- Conforme o uso
- Modelos
- Automático
- Casos de uso
- Imagens e designMarketing e crescimentoComércio eletrônico e vendas
- O que você recebe
- PromptPlano
