九維全域視覺解構引擎
反向拆解資訊圖,生成可複製的結構化提示詞
九維全域視覺解構引擎
反向拆解資訊圖,生成可複製的結構化提示詞
展示內容
描述
將單張或多張資訊圖、資料視覺化、流程圖、時間軸、地圖、知識圖譜與組織架構圖,拆解為可重複使用的視覺與資訊結構,幫助你準確理解一張圖為什麼這樣組織,並重建相近的表達效果。技能會從空間構圖、維度與材質、色彩層級、字體排版、模組關係等表現因素著手,同時辨識圖表編碼、閱讀路徑、圖示隱喻,以及地理或網路關係,讓分析不只停留在「風格像什麼」。 你將獲得一份參數化的視覺解構結果,涵蓋畫布與構圖邏輯、視覺層級、文字密度、模組拓撲、資料與關係的表達方式,以及圖像中的敘事動線。對於統計圖表、地圖或關係網路等內容,輸出會聚焦其資料如何映射為色彩、位置、大小、連線與節點等視覺變數;對於複雜專題圖,則會進一步梳理圖形、文字與隱喻系統之間的協同關係。 基於這些分析,技能會生成詳盡、結構清晰的英文圖像生成提示詞,適合用於資訊圖複製、視覺研究、設計參考、品牌內容探索與概念圖製作。無論你提供的是現有圖片,還是對主題與視覺方向的構想,都能得到更接近結構層級重現的提示詞,而不是泛泛的風格描述。
相關技能
查看全部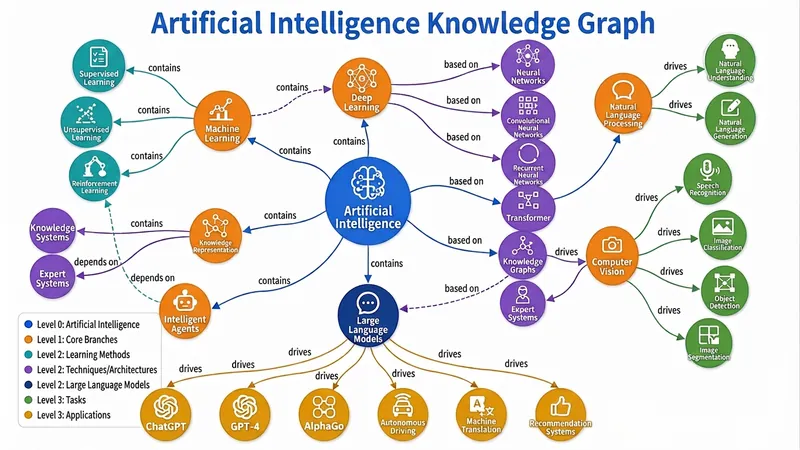
知識圖譜引擎
從文本、檔案或主題自動建構五類圖譜(知識圖譜、心智圖、概念圖、流程圖/架構圖、關係圖),以最高標準輸出互動式網頁、靜態圖片與可視化程式碼的三合一方案。融合知識圖譜工程與資訊可視化最佳實踐,支持粒度動態控制、消歧去重、多源交叉驗證。 把你的文字、檔案甚至一個念頭,秒變可拖曳、可縮放、可搜尋的互動式知識圖譜,並一鍵匯出高清圖片與即用程式碼——這是你從未體驗過的知識可視化「三合一」引擎。 🧠 什麼是「知識圖譜引擎」? 它不是你見過的那種簡單畫圖工具,而是一位藏在瀏覽器裡的知識工程師+可視化專家。給它一段教材、一篇論文、一份PDF,或者只給一個關鍵詞,它就能自動: 🔍 抽取核心實體,釐清深層關係 🧱 建構結構化圖譜JSON(知識圖譜/心智圖/概念圖/流程圖/關係圖) 🎨 輸出三種頂尖形態:可互動網頁 + 高清靜態圖 + Markdown/Mermaid/Graphviz程式碼 從此,資訊整理不再靠手動畫框,知識呈現不再只是一張死圖。 ⚡ 為什麼說它是「頂尖」的? 1. 全自動「從文本到圖譜」流水線 不用學任何建模語言,不用手動定義節點和連線。你只需輸入內容,引擎會自動判定圖譜類型: 學科知識體系?→ 生成語義豐富的知識圖譜 讀書筆記拆解?→ 生成層級清晰的心智圖 流程與決策?→ 生成帶分支的流程圖/架構圖 人物關係網?→ 生成多維關係圖 哪怕你只扔一個主題詞,它也能自主蒐集資料,補全內容後再出圖。 2. 三合一輸出,覆蓋全部使用場景 🖱️ 互動式D3.js網頁:拖曳節點、滾輪縮放、點擊彈出詳情、高亮關聯路徑、關鍵詞搜尋……像操作一張活的地圖。單檔案HTML,無後端,可以直接嵌入任何頁面或發給任何人。 🖼️ 高清靜態圖譜:力導向佈局,色彩分類,直接用於論文配圖、PPT彙報、教學材料,清晰到每個標籤都銳利可讀。 📜 可視化程式碼:同時生成Mermaid與Graphviz原始碼,開發者可直接放入文件、wiki、Notion,二次編輯無限擴展。 3. 極致用戶體驗設計 🎨 顏色按實體類型自動映射,層級用節點大小直觀表達 🔗 關係標籤直接顯示在曲線上,一眼看懂「包含」「導致」「支撐」 💡 點擊任意節點,非關聯部分自動淡出,聚焦思維路徑 🔄 重置佈局、搜尋定位、縮放平移……所有操作絲般順滑 4. 兼顧「廣度」與「深度」的工程智慧 從實體消歧去重,到多源交叉驗證;從層級粒度控制,到支持跨域關聯的虛線連接——這背後是知識圖譜工程的最佳實踐,不是玩具,是生產力工具。 👥 誰最需要它? 教師 & 教育內容創作者 把整本教材章節變成一張可互動知識地圖,學生一點即懂概念關聯。 研究人員 & 學生 論文文獻綜述不再只靠文字堆砌,一張圖釐清數十篇論文的理論脈絡。 產品經理 & 企業架構師 系統架構、業務流程、功能拆解,即時生成架構圖,溝通效率翻倍。 讀書人 & 終身學習者 筆記不再只是大綱,而是可探索的思維網路,讓知識真正「長」在一起。 🚀 現在,讓你的知識「活」過來 你給內容,它給洞察。 你給主題,它給體系。 你給需求,它給網頁、圖片、程式的完整交付物。 這不是一個功能,這是一套將資訊升維為認知的工作流。 讓「知識圖譜引擎」成為你思考的延伸,視覺化你的專業,觸達每一個受眾的「aha moment」。 —— 從今天起,不再「畫」圖譜,而是「生」圖譜。
 圖片
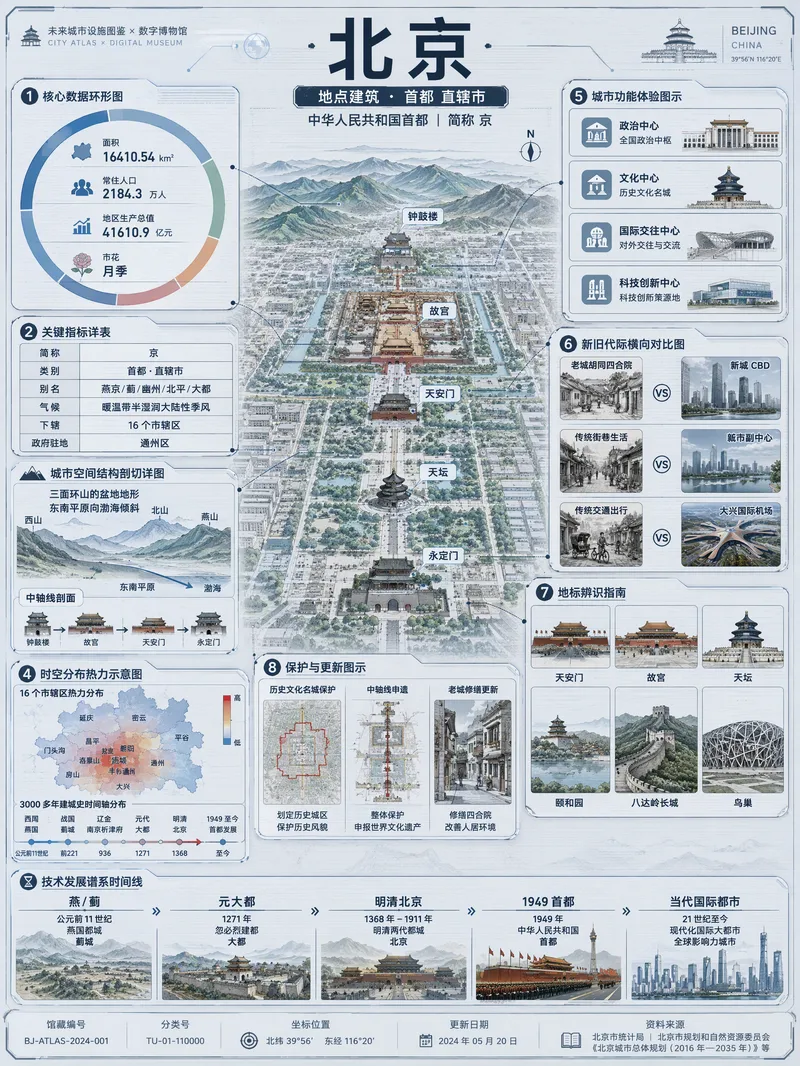
(爆紅)萬物資訊圖生成器
將一個對象名稱快速轉化為兼具知識密度與視覺表現力的科技博物圖鑑海報。無論是生物、礦物材料、人造物、地點建築、文化概念還是歷史人物,都能結合你的受眾、側重點和語言要求,整理出適合展示與分享的資訊內容。 技能會先透過即時網路搜尋核實定義、關鍵資料、結構組成、分布、應用、演變和辨識特徵等資料,再將內容編排為一張 3:4 直式資訊圖。海報以中央標本式主體為視覺核心,周圍環繞九組自適應資訊模組,涵蓋核心指標、結構解析、時空分布、場景說明、比較資訊、辨識要點、保護或維護提示及發展時間線等內容,並根據對象類型調整模組主題與資訊重點。 成品採用淺灰藍科技卡紙、精密線稿、低飽和青藍淡彩和半透明掃描質感,呈現未來城市設施圖鑑與數位博物館展板結合的視覺風格,同時保留頂部對象標識和底部館藏資料區。資料不足或較冷門的對象會以視覺化提示區分推測內容,適合用於科普教育、展覽介紹、知識分享和社群媒體發布。
 圖片
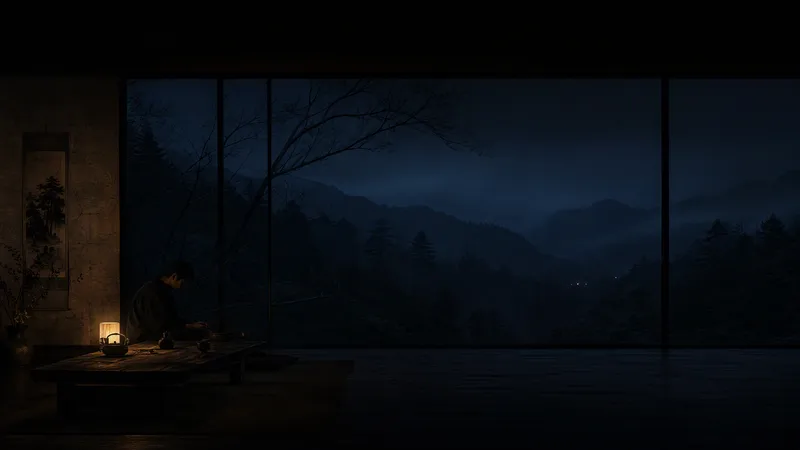
物哀侘寂幽玄視覺生成
將主題、場景、人物、古詩詞或照片轉化為具有明確思想來源與視覺依據的日本美學圖像,適合需要細膩敘事與藝術指導的創作者。技能會根據內容選擇物哀、侘寂或幽玄作為主導方向:物哀表現正在消逝的美,侘寂呈現材料與時間留下的痕跡,幽玄則透過遮蔽、距離、留白與不可見空間製造含蓄的深度;只有在主題確實同時具備多重審美邏輯時才進行融合。 你將獲得清晰的主題判斷、主導美學、融合關係、藝術史錨點及核心敘事,並進一步生成包含主體、環境、構圖、空間層次、材質、色彩、光線、情緒與負面約束的專業視覺提示詞,避免把「日式」「禪意」或「高級感」當作空泛標籤。對於人物照片,會盡量保留身分、臉部結構、年齡感、體型與主要服裝特徵,透過環境、光線與敘事完成美學轉換,而不是預設改造成和服人物。 確認後,技能會展示完整提示詞並生成圖片,同時提供美學說明,幫助你理解畫面如何體現消逝、留痕或不可見之美。適用於概念藝術、攝影風格轉換、古詩詞視覺化、人物場景創作、空間敘事,以及具有日本美學氣質的 AI 生圖。
資訊
- 版本
- v3
- 更新時間
- 執行點數
- 依實際用量
- 模型
- 自動選擇