AI 影片分鏡單
將文案拆成可逐鏡生成的提示表
AI 影片分鏡單
將文案拆成可逐鏡生成的提示表
展示內容
描述
AI 影片最常見的兩種失敗方式:一是無法向模型清楚說明(例如寫「一個充滿活力的人迎接新的一天」,模型根本無法執行);二是第一鏡和第二鏡中的人物不像同一個人。 【AI 影片分鏡單】會將文案拆成一張可直接複製貼上、逐鏡生成的表格,每鏡填寫五項:主體(誰正在做什麼能被看見的動作)、環境(前景與背景各有什麼)、光線(方向、軟硬度與色溫)、鏡頭(景別/機位高度/運動方式)、風格句(材質與色調)。最關鍵的是「一致性三招」——將主角描述寫成一段固定文字區塊,每次原樣複製、只修改動作;每鏡重複同一句光線與場景描述;先用首幀圖定錨,再讓影片工具以此驅動(比反覆修改文字提示詞有效得多)。另外提供時長分配與轉場建議、六個最容易失敗的情況(多人同框時臉部崩壞、快速動作變形、畫面文字變成亂碼、手部特寫出錯、反光材質模糊、跨鏡時衣服變色),以及相應的規避寫法。硬性規則:不生成影片、不使用真人肖像、不換臉;不出現任何既有的卡通、動漫、遊戲或影視形象;不具名模仿在世導演或藝術家;不生成未成年人形象或裸露內容;不教導將生成畫面當成實拍新聞發布。
適合對象
適合需要將文案整理成 AI 影片分鏡與逐鏡生成提示詞的內容創作者、行銷人員及影片製作人員。
如何使用此 Skill
提供輸入
提供一段口播稿、產品介紹或故事,並說明用途、成片時長、畫幅、整體風格、需要保持一致的主體或場景,以及使用的工具。
執行 Skill
將文案拆解成逐鏡分鏡表,明確可見動作、環境、光線、景別、機位、運鏡與風格,並統一角色及場景描述。
查看結果
取得可複製到 AI 影片工具的逐鏡提示詞、首幀描述、時長分配、轉場建議,以及常見畫面問題的規避提示。
相關技能
查看全部
AI影片與分鏡提示詞生成
將劇情、角色設定或現有影片提示詞,轉化為適合 AI 影片生成的專業短劇分鏡與可直接使用的鏡頭提示詞。無論是都市、古裝、懸疑、情感還是爽劇場景,都能圍繞人物關係、劇情節奏與情緒鉤子,明確景別、機位、視角、運鏡、構圖、光影、環境音與台詞,讓每個鏡頭具備清晰的視覺重點與可執行的動作。 技能會特別關注角色一致性與場景連續性,協助鎖定人物外觀、服裝邏輯、身分狀態與標誌性細節,降低換臉、漂移、空間錯亂及動作含糊等生成風險。角色的眼神、表情、呼吸、手部與身體反應,也會被轉化為可見的表演變化,增強短劇的衝突、壓迫感、反轉與情緒遞進。 你可以從完整劇情開始,也可以提供現有角色資產、分鏡或提示詞進行定向優化;已有穩定人設時可直接沿用,避免重複設計。最後還能將完整鏡頭整理為適合主流 AI 影片模型逐段生成的 15 秒以內片段,並保留畫面、聲音與時長資訊,方便複製使用與後續剪輯。
 影片
火種|影片圖解生成器
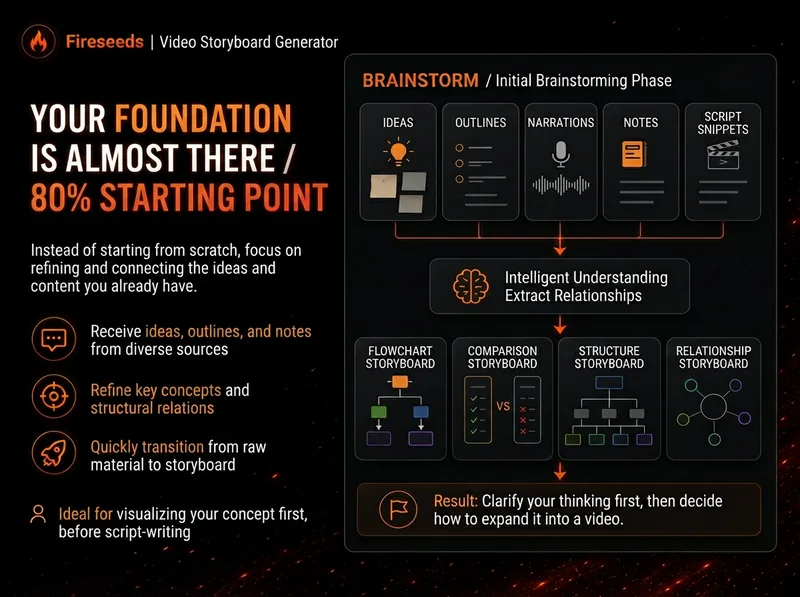
很多影片不是「沒有內容」,而是內容太抽象、太密集,觀眾聽懂了前一句,下一句就忘了。 「火種|影片圖解生成器」會把你的想法、腦暴、提綱、腳本、逐字稿或文章,先拆解出真正值得視覺化的概念,再判斷它更適合用流程、對比、架構、層級、循環、分支、決策樹或其他圖解結構來表達。 它不會為了湊數量硬畫,也不會把複雜內容塞成一張密密麻麻的資訊圖。多張圖會維持同一套視覺語言、命名和語意色彩,方便直接插入影片,作為講解骨架。 特別適合: 解釋複雜概念 拆解工作流程 比較兩種方法 展示系統結構 講清因果關係 把長篇腦暴整理成一組影片視覺節點 預設輸出為 16:9 靜態圖解。若執行環境無法提供可編輯的 Excalidraw 原始檔,會明確說明,不會把靜態圖片冒充成 .excalidraw。 適用情境 情境 1|把腦暴變成圖解 只有一大段口述想法,沒有完整腳本。技能會從中找出最值得繪製的觀點,整理成一組具有講述順序的圖解。 情境 2|把腳本變成影片視覺節點 已有完整腳本,但不知道哪裡該加畫面。技能會判斷哪些段落值得視覺化,並選擇合適的圖解類型。 情境 3|解釋複雜概念 例如 AI Agent 如何運作、為什麼工作流程比單次示範重要、商業模式如何運轉、產品架構包含哪些層級。 情境 4|拆解工作流程/流程 例如:選題池 → 研究 → Hook → 腳本 → 製作 → 複盤。 情境 5|進行比較 例如:沒有工作流程 vs 有工作流程;傳統方式 vs AI 方式;單次成功 vs 穩定且可複製。
MiniMax H3多模態影片反推提示詞助手
將完整的參考影片交給多模態 AI,自動拆解真實鏡頭、時間線、畫面變化與可聽見的聲音,並生成可直接用於影片創作的生產級提示詞。不局限於真人、廣告或電影素材,也適用於產品展示、建築風景、動物、美食、體育動作、舞蹈、2D/3D 動畫、UI 演示、螢幕錄製、資訊圖、視覺特效和抽象影像等多種題材。 根據影片的資訊結構,助手可輸出完整的文生影片提示詞,或按每個 Shot 生成圖生影片所需的參考圖/首幀提示詞、連續運動描述、必要的尾幀提示詞與鏡頭級穩定約束;當靜態畫面和時間變化都很重要時,也能同時提供兩種版本。生成內容會保留主體、構圖、攝影機運動、動作因果、結構變化、文字、對白、環境聲與音樂等實際可確認的資訊,並追蹤每個鏡頭直到真實結束狀態。 對於無法清楚確認的文字、聲音、身分、地點或拍攝方式,助手會避免擅自補全;同時區分目標畫面與播放器浮水印、控制層等外部元素,減少生成時的內容漂移。適合需要從參考影片反推文生影片提示詞、I2V 鏡頭提示詞,或為影片重建、風格重現和生成式廣告製作整理素材的創作者與製作團隊。
資訊
- 版本
- v2
- 更新時間
- 執行點數
- 依實際用量
- 模型
- 自動選擇
- 使用情境
- 寫作與內容影片與音訊行銷與成長
- 你將獲得
- 文件提示詞計畫