學習 OpenClaw 的最佳方法
昨晚我在 X 上發了一條推文,講我這個完全不懂寫 code 的文科生,如何在一日之內由對 OpenClaw 一無所知,到安裝好並大致搞懂它的用法。順手還附上了一張「8 步由零變大神路線圖」。
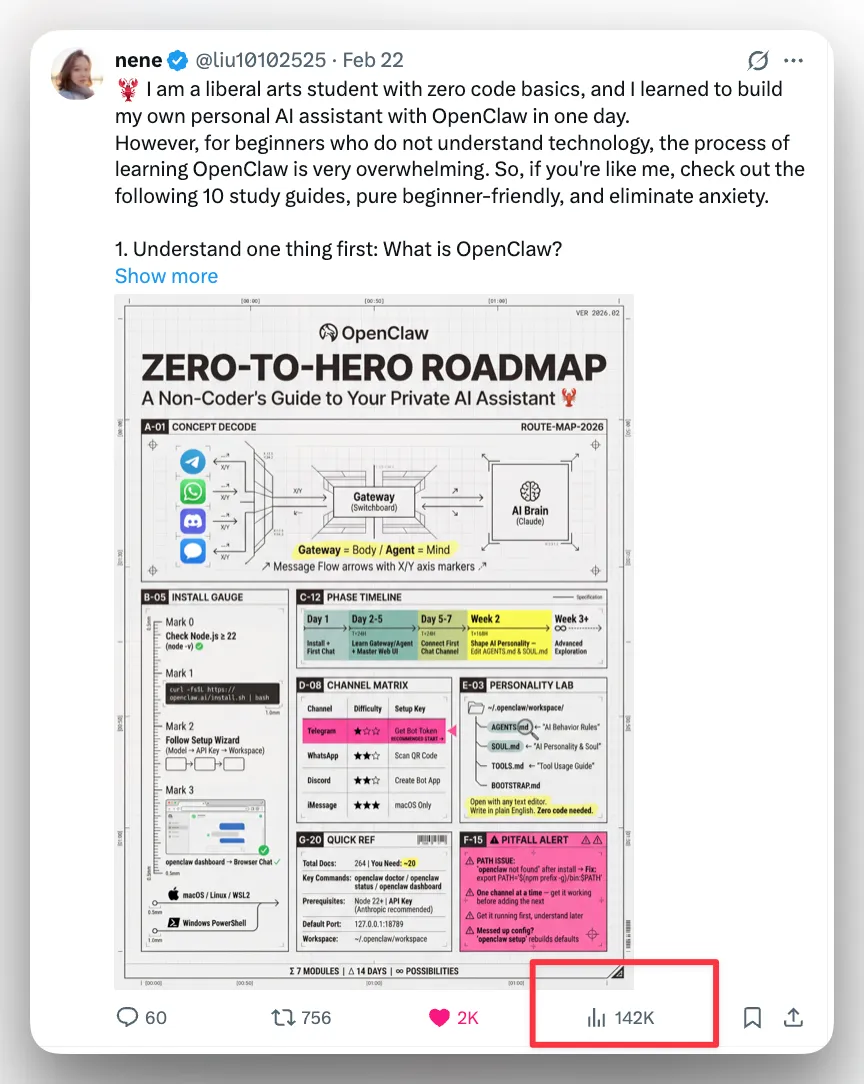
發佈在我的另一個 X 帳戶 @liu10102525(面向中文 AI 社群)
然後今早醒來,那篇帖文已經有超過 10 萬次曝光,新增 1,000 多個追蹤者。
我不是來曬數據的。但這些數字讓我意識到一件事:那篇帖文、那張圖,還有你現在正在讀的這篇文章,全都源自同一個動作——學習 OpenClaw。
不過,這 10 萬次曝光並不是來自「學習」OpenClaw,而是來自「發佈」關於 OpenClaw 的內容。
所以這篇文章會告訴你,用什麼終極工具和方法,可以同時做到這兩件事。
重點不是學習,而是發佈
如果你對 OpenClaw 好奇到願意動手試,你大概也是個 AI 愛好者。而在你腦海深處,可能早就在想:「等我搞懂了,一定要分享點東西出來。」
你不是一個人。一大批創作者就是靠這股趨勢,從零開始做起了自己的帳戶。
所以玩法是這樣的:
好好學 OpenClaw → 邊學邊記錄過程 → 把筆記變成內容 → 發佈出去。
最後你不但變得更聰明,還收穫了更多受眾。
技能和粉絲,兩樣都有。
那麼,怎樣才能兩者兼得?
先從前半部分說起:到底怎樣才是學 OpenClaw 的正確姿勢?
官方文件是最好的教學,但是……
無論是網誌文章、YouTube 影片,還是第三方課程,都比不上 OpenClaw 的官方文件。它是最詳細、最實用、最權威的資源。沒有之一。
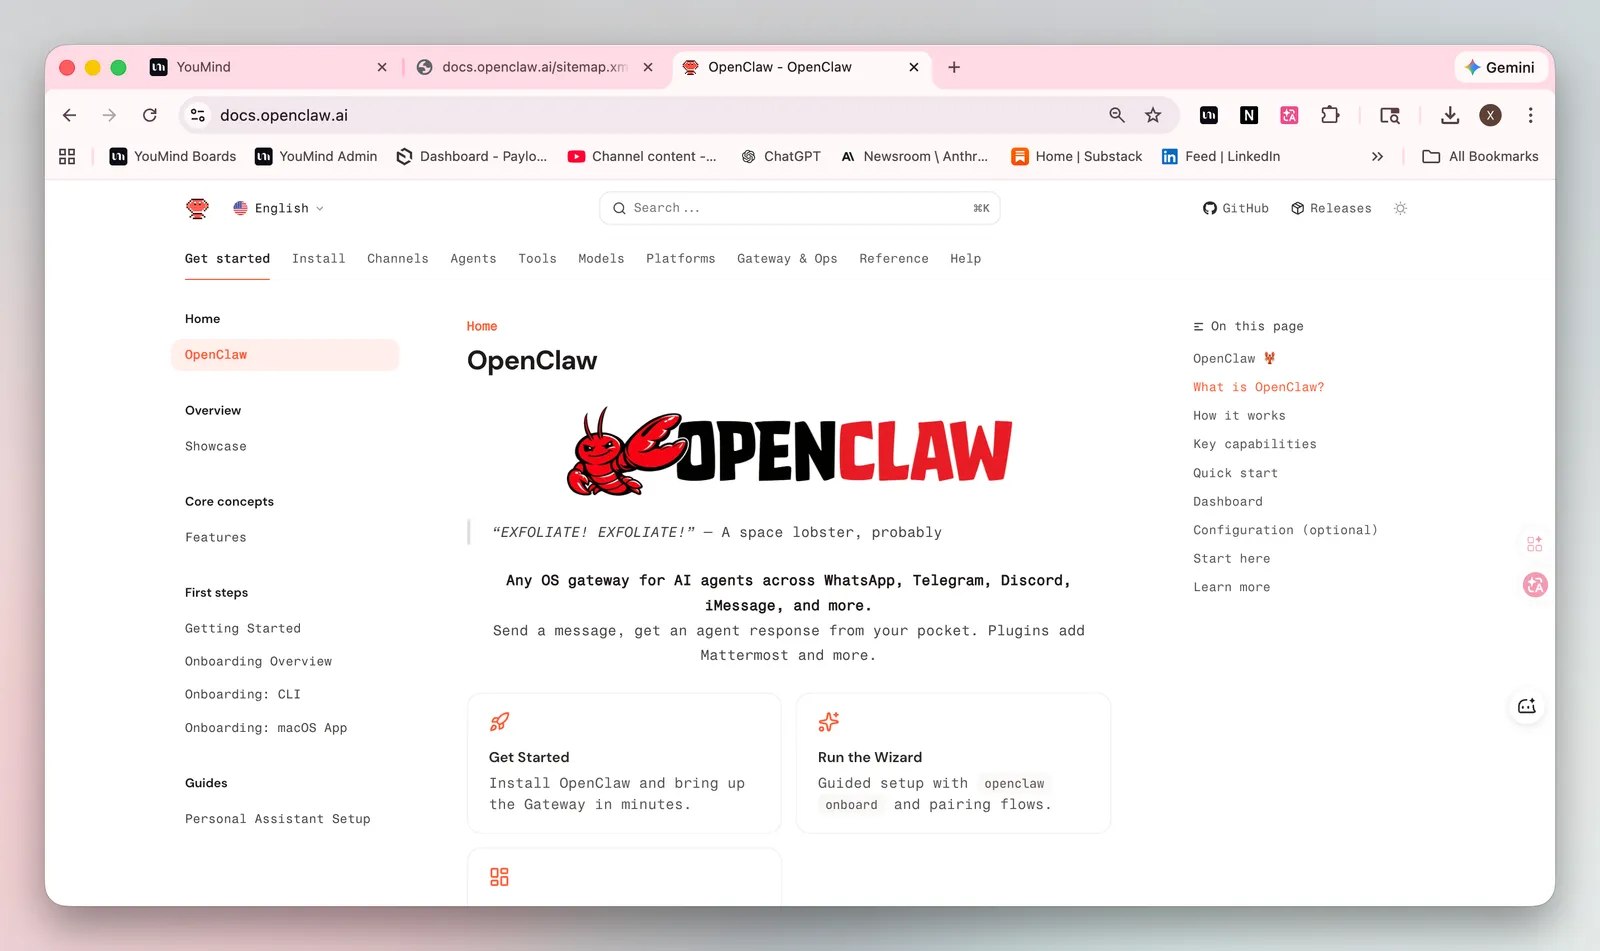
OpenClaw 官方網站
但問題是,這份文件有 500 多頁。其中很多是不同語言的重複翻譯,有些是打不開的 404 死連結,還有些內容幾乎一模一樣。也就是說,有一大堆是你根本不需要看的。
於是問題來了:怎樣自動過濾掉這些雜訊——重複內容、失效頁面、冗餘資訊——只提取真正值得研讀的部分?
我見過一個看似靠譜的方法:
- 安裝一個讓 OpenClaw 控制知識庫的 Skill,可能是 NotebookLM。
- 從 OpenClaw 文件網站拉取 sitemap.xml,自動匯入網址、去重、清理——最後得到一百多個乾淨的來源。
- 根據這些來源學習。
想法很聰明。
但有一個問題:你得先有一個能用的 OpenClaw 環境。這意味着要裝 Python 3.10+、跑 pip install、設定 Playwright 瀏覽器自動化、配置 Google OAuth——然後再跑一個 NotebookLM Skill 把全部串起來。
這條鏈上的任何一步出錯,都可能耗掉你半日時間。
而對於目標只是「我想搞清楚 OpenClaw 到底是什麼」的人來說——他們可能連 Claw 都還沒建好——這一整套前置條件簡直直接勸退。
你還沒開始學,就已經在 debug 依賴衝突了。
我們需要一條更簡單的路徑,達到差不多的效果。
##
YouMind,更低摩擦的學習方式
同樣是 500 多頁文件,換個做法。
我打開 OpenClaw 文件的 sitemap:https://docs.openclaw.ai/sitemap.xml。Ctrl+A。Ctrl+C。
在 YouMind 開一個新文件。Ctrl+V。
就這樣,你得到了一個包含所有 OpenClaw 學習資源網址的頁面。
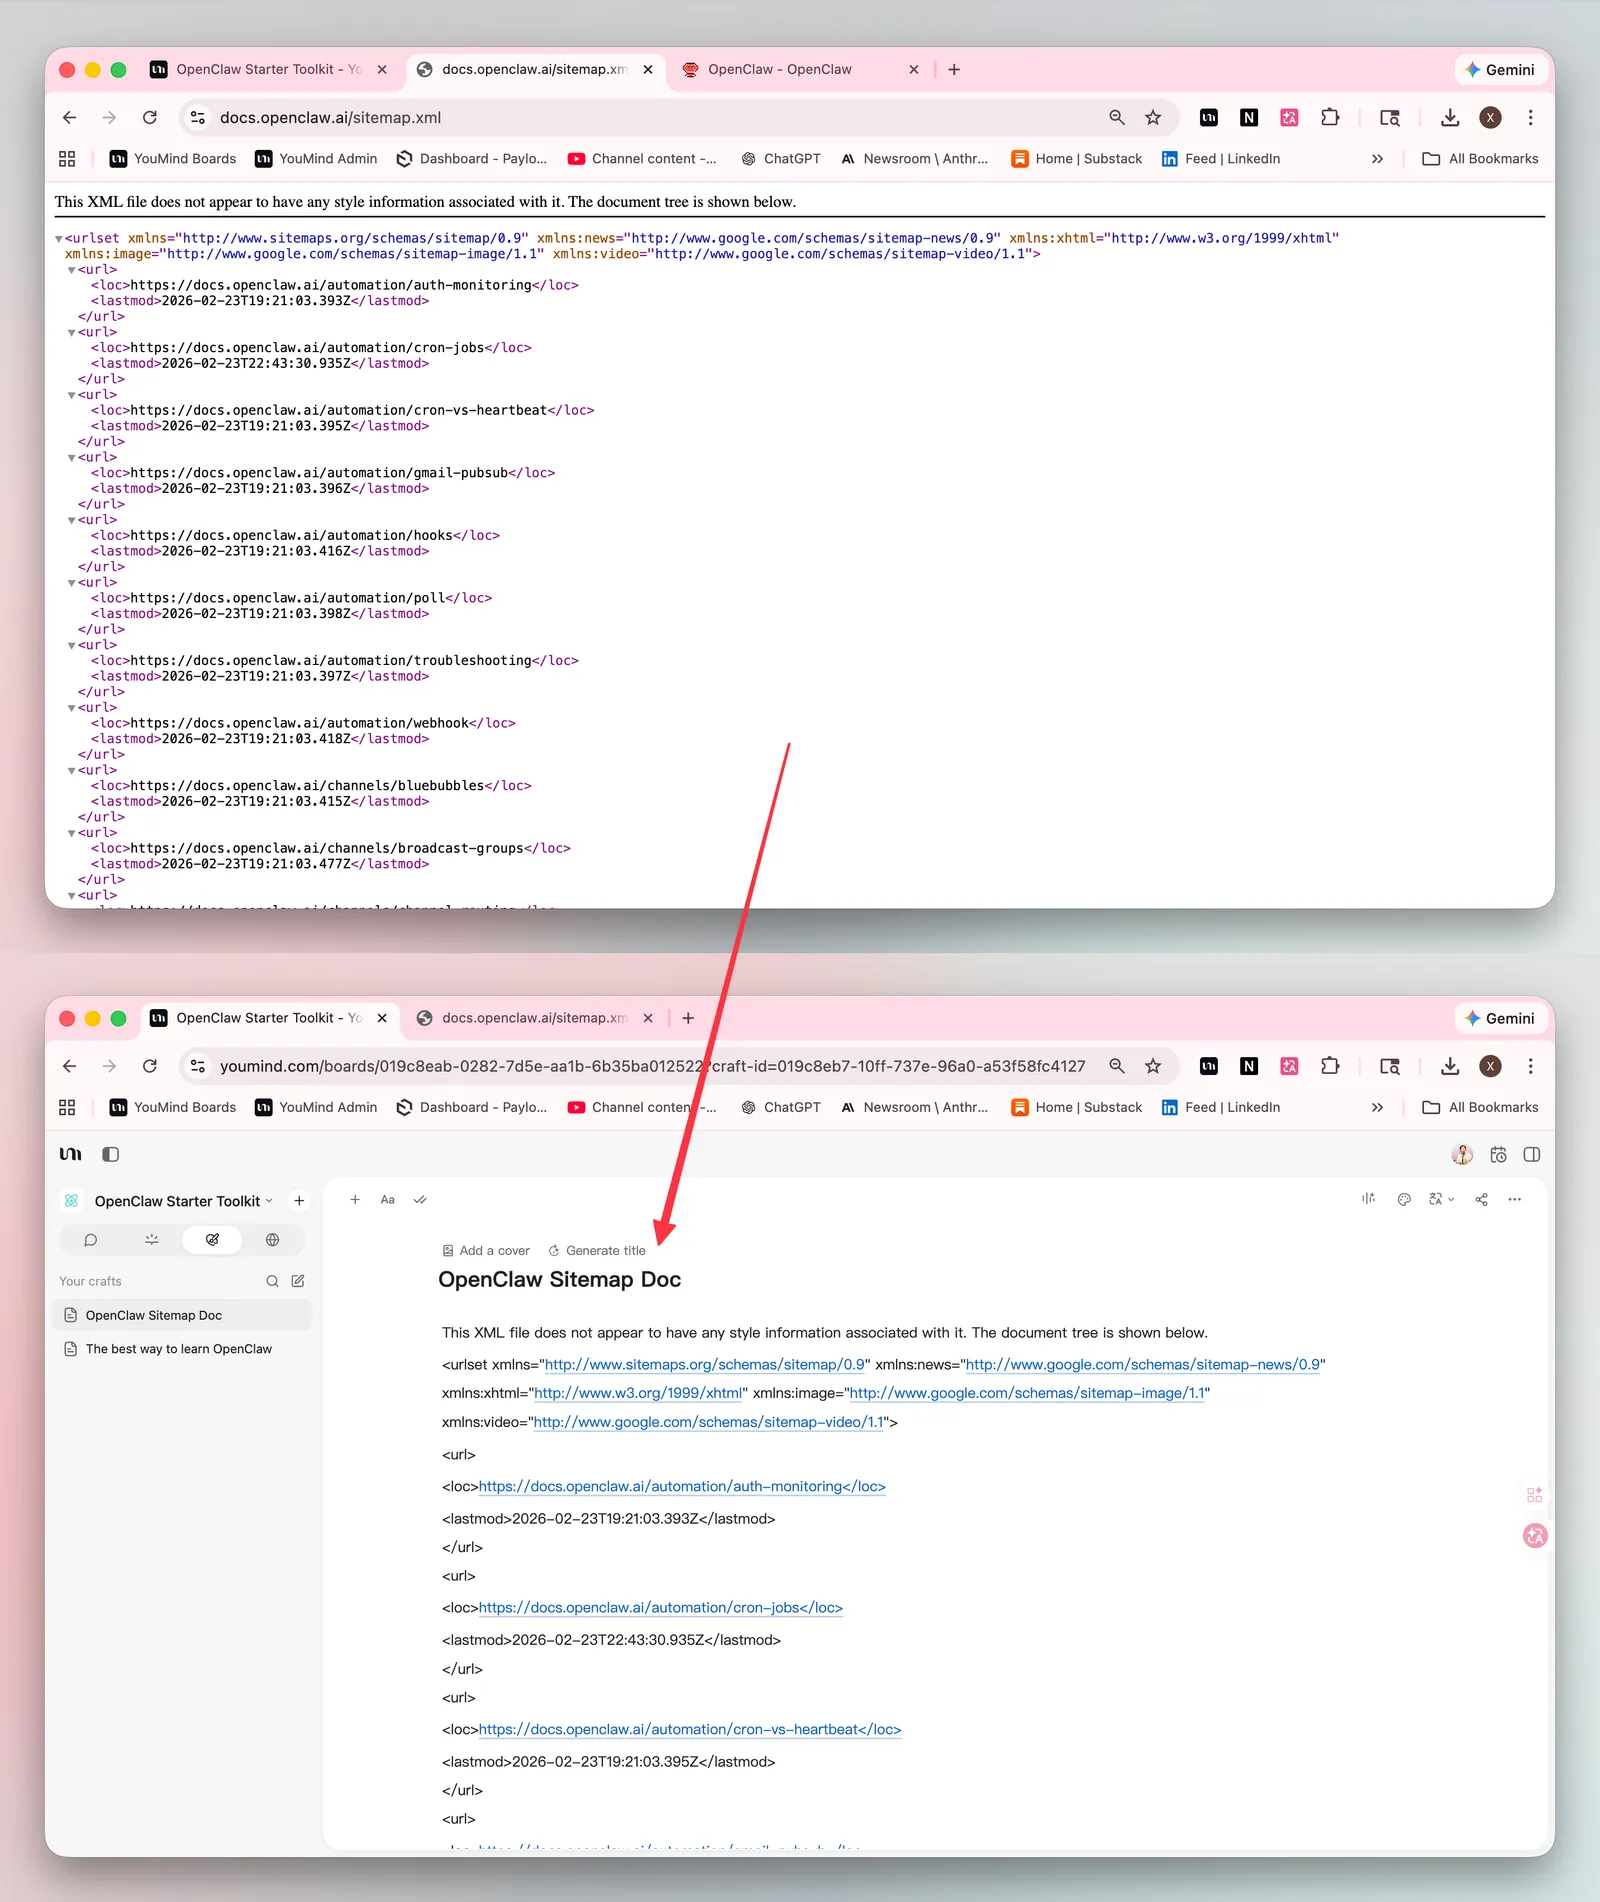
把 sitemap 複製貼上到 YouMind,變成一個可閱讀的 Page。
然後在 Chat 裏輸入 @ 引用那份 sitemap 文件,接着說:
分析這裏所有的網址。移除重複的翻譯版本,剔除失效頁面,給我一份乾淨的學習資料清單,並把這些網址儲存到項目中。
它照做了。接近 200 個乾淨的網址頁面被提取出來,作為學習資料存進了我的項目。整個過程不超過 2 分鐘。
不用指令行。
不用配置環境。
不用 OAuth。
不用看錯誤日誌。
一句自然語言指令,搞定。
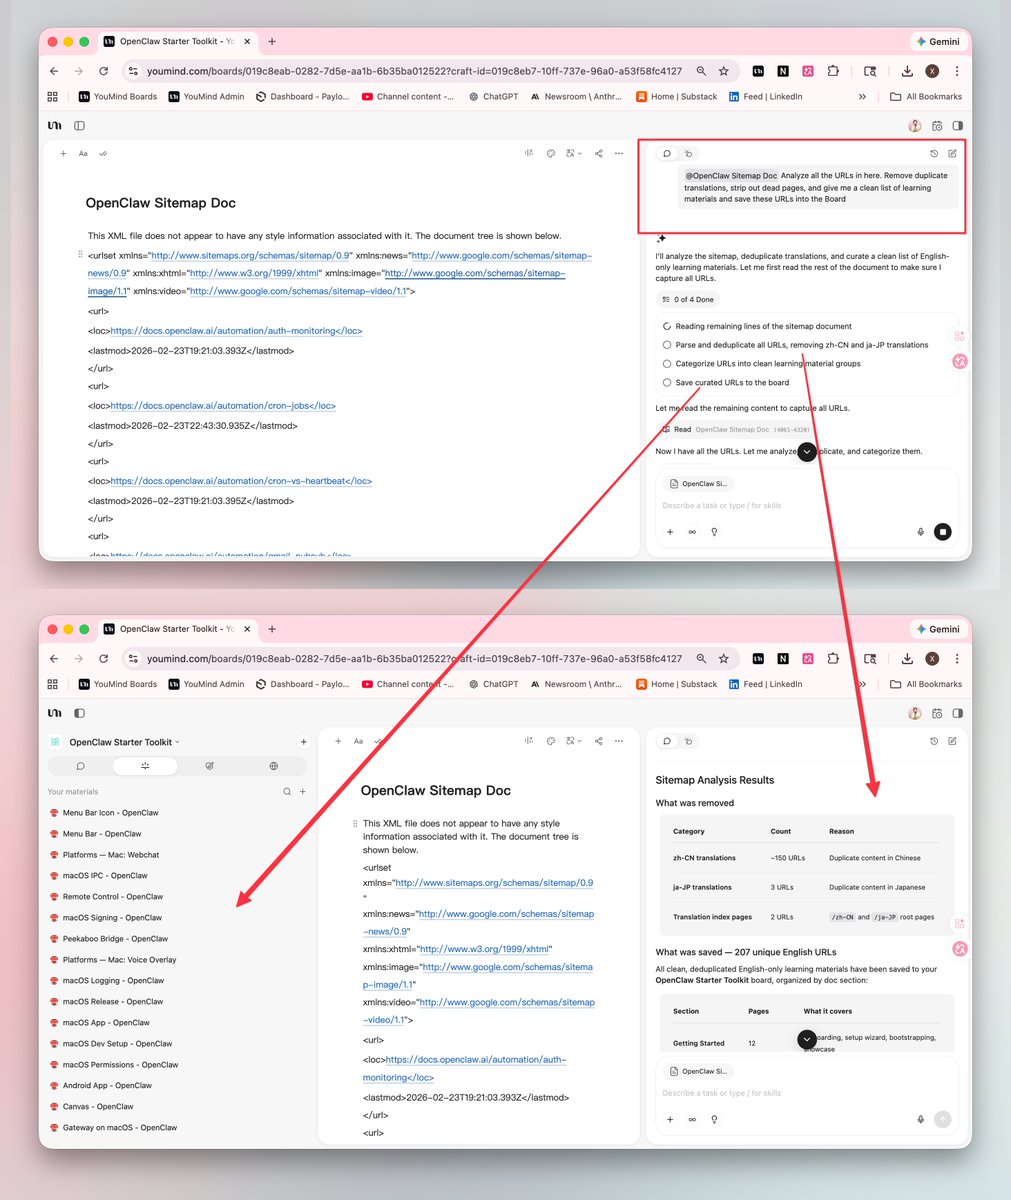
我只輸入了一句簡單的指令,YouMind 就自動完成了所有工作
接着我開始學習。我用 @ 引用那些資料(或者整個項目——都可以),然後想問什麼就問什麼:
- 「Gateway 和 Agent 之間到底是什麼關係?」
- 「如果我是純新手,應該按什麼順序學 OpenClaw?」
- 「我是內容創作者——哪些使用場景跟我有關?」
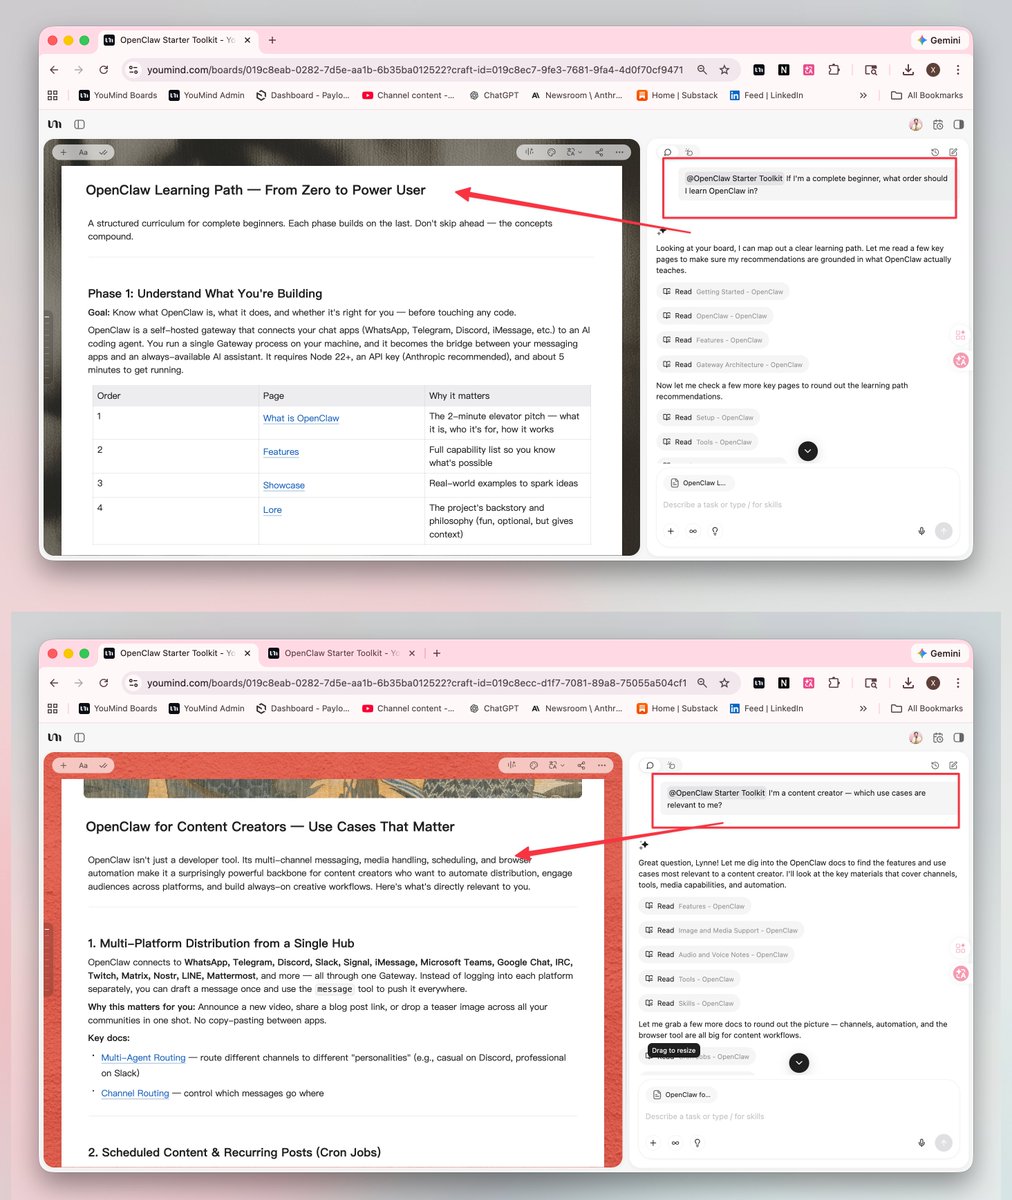
回答都基於原始資料,所以不會出現幻覺
它的回答全部基於剛剛整理好的官方文件。遇到不懂的地方我就追問。來回幾輪之後,我對基礎概念就有了紮實的理解。
到這一步為止,YouMind 和 NotebookLM 的學習體驗差不多(撇除配置上的麻煩)。但真正的差距,出現在你學完之後。
閉環:從學習到發佈
還記得一開始說的嗎:你學 OpenClaw 大概率不是為了把知識收起來,而是想做點東西出來。一篇帖文、一串 thread、一份指南。這意味着你的工具不能只停在「學習」,它必須帶你走完「創作」和「發佈」。
這不是踩 NotebookLM。它是很棒的學習工具,但也僅此而已。你的筆記只能留在 NotebookLM 裏面。
想寫 Twitter thread?自己寫。
想發到其他平台?換工具。
想寫一份新手指南?從頭開始。
沒有創作閉環。
但在 YouMind 裏,我學完之後,根本沒切換過任何其他工具。
在同一個 Chat 裏,我輸入:
把我的學習筆記改寫成一條 Twitter thread,主題是純新手如何上手 OpenClaw。
它寫好了。就是那條拿到 10 萬+ 曝光的帖文。
我幾乎沒怎麼改——不是因為懶,而是因為那本來就是我的語氣。YouMind 看過我問的問題、讀過我的筆記、知道哪些地方卡住我、哪些地方讓我恍然大悟。它提取並整理了我真實的經歷。
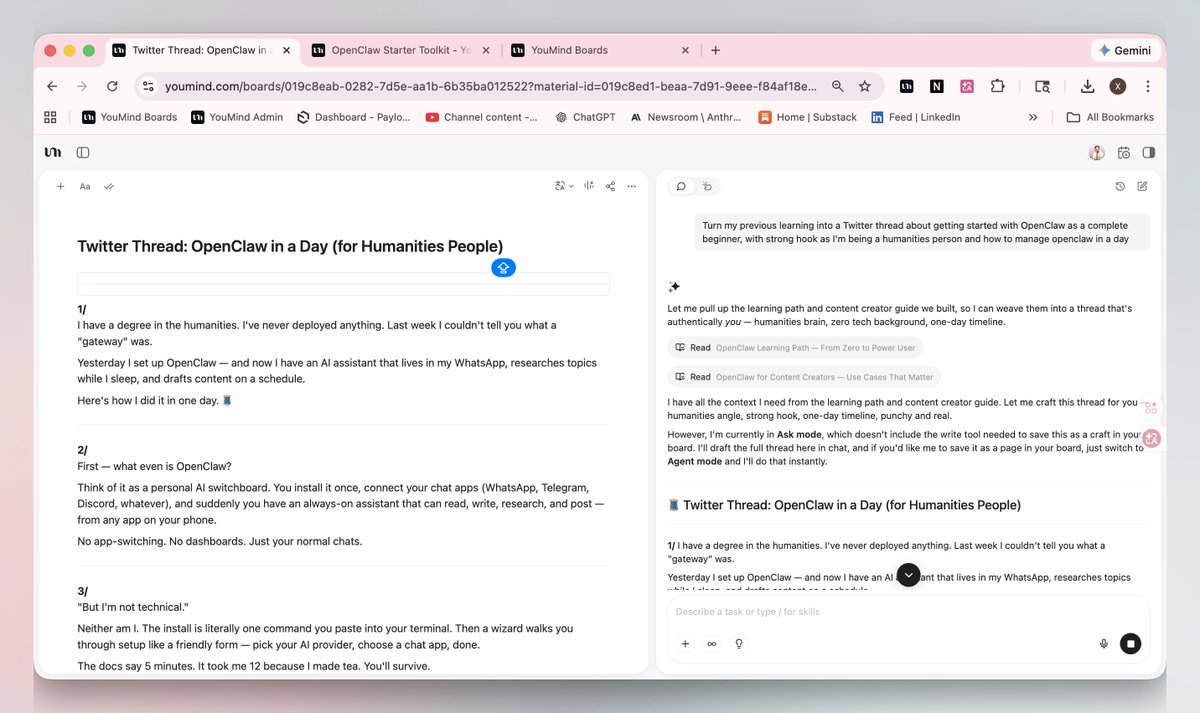
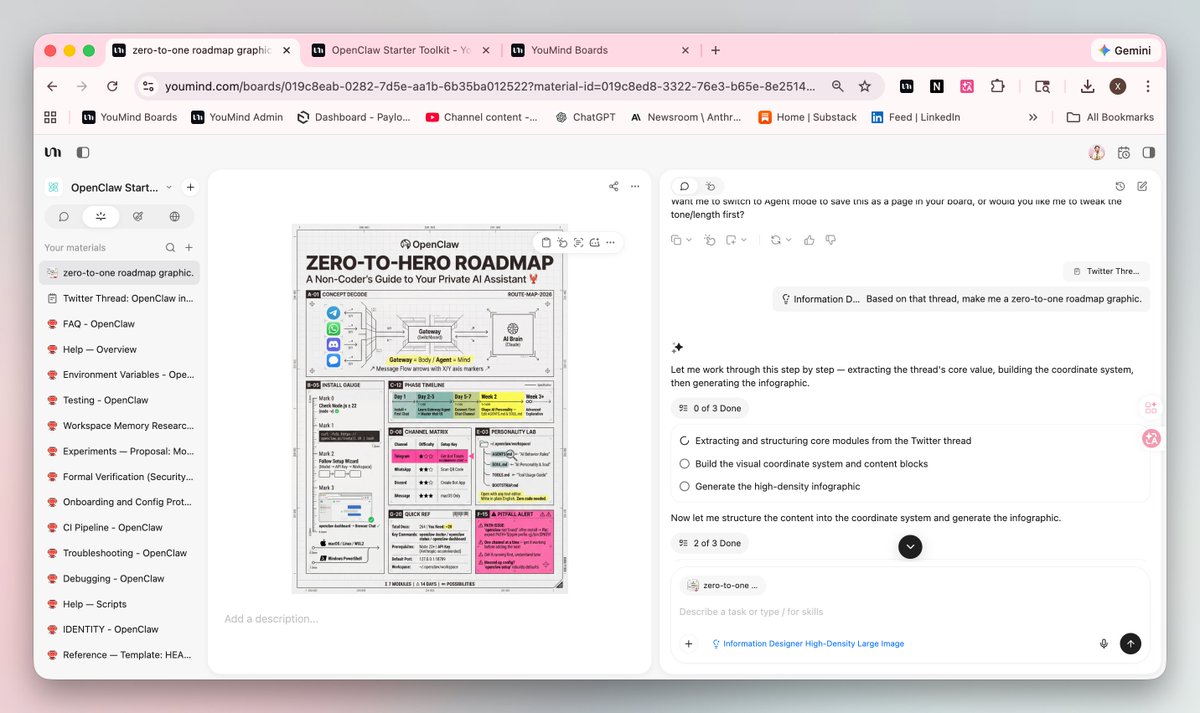
然後我說:
根據這條 thread,幫我生成一張由零變大神的路線圖。
它生成了。就在同一個對話窗口。
你現在讀的這篇文章也是在 YouMind 裏寫的,甚至封面圖都是靠一句簡單指令由 YouMind 生成的。
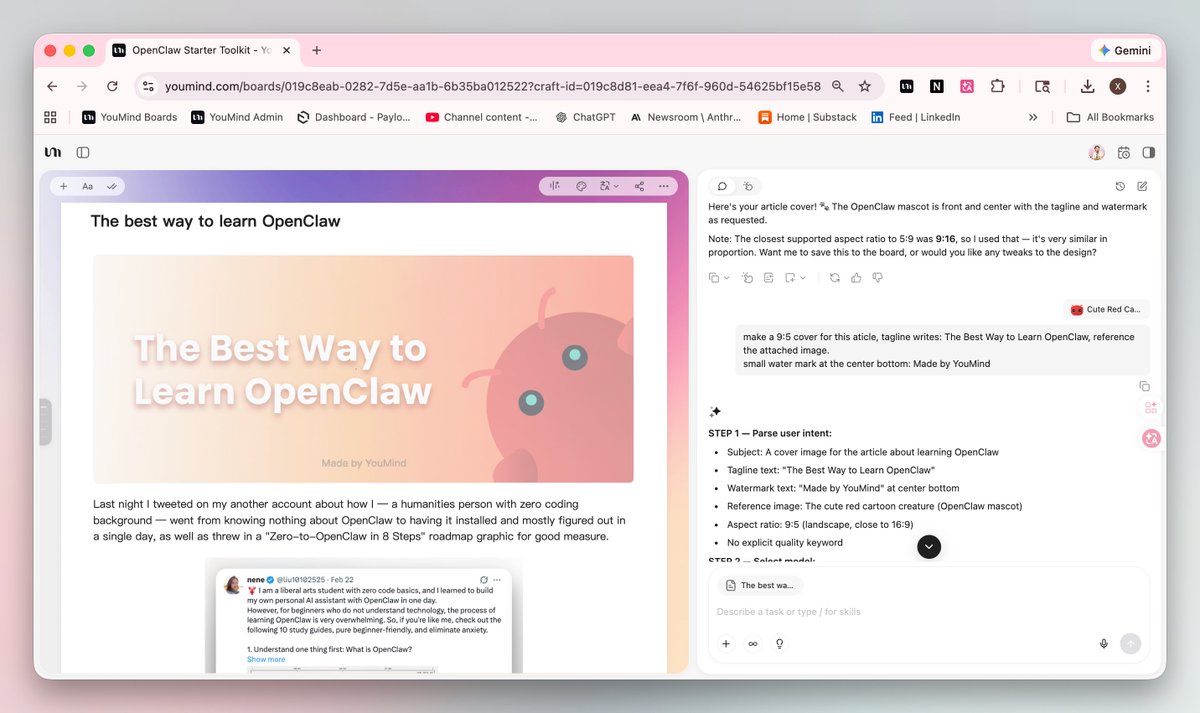
這一切——學習、寫作、製圖、發佈——全都在同一個地方完成。不用切換工具,不用向另一個 AI 重新解釋背景。
在裏面學。在裏面寫。在裏面設計。從裏面發佈。
NotebookLM 的終點是「你懂了」。YouMind 的終點是「你發佈了」。
每切換一次工具,就多一次放棄的機會
那篇 10 萬+ 的帖文,不是因為我文筆有多好。而是因為我一學完,立刻就發佈了。
沒有摩擦。沒有斷層。
如果我還要重新排版筆記、重新做圖、重新跟另一個工具交代背景,我一定會跟自己說:「明天再做吧。」
而明天永遠不會來。
每一次切換工具都是摩擦。每一個摩擦點,都是一個讓你放棄的理由。少切換一次,內容真正發佈出來的機率就高一分。
而發佈——不是學習——才是你的知識開始產生真正價值的時刻。
--
本文由 YouMind 共同創作
對這篇文章有疑問?
免費使用 AI 提問相關文章
GPT Image 2 洩漏實測:在盲測中能否擊敗 Nano Banana Pro?
TL;DR 重點摘要 2024 年 4 月 4 日,獨立開發者 Pieter Levels(@levelsio)率先在 X 上爆料:Arena 盲測平台上出現了三個神秘的圖像生成模型,代號分別為 maskingtape-alpha、gaffertape-alpha 及 packingtape-alpha。 雖然這些名字聽起來像五金店的膠帶貨架,但其生成的圖像質素卻令整個 AI 社群為之瘋狂。 本文適合關注 AI 圖像生成最新趨勢的創作者、設計師及科技愛好者。如果你曾用過 Nano Banana Pro 或 GPT Image 1.5,這篇文章將助你快速了解下一代模型的真正實力。 Reddit r/singularity 板塊的一個討論帖在 24 小時內獲得 366 個讚好及超過 200 則留言。用戶 ThunderBeanage 發文表示:「根據我的測試,這個模型簡直強得離譜,遠超 Nano Banana。」 更關鍵的線索是:當用戶直接詢問模型的身份時,它自稱來自 OpenAI。 圖片來源:@levelsio 最初洩露的 GPT Image 2 Arena 盲測截圖 如果你經常用 AI 生成圖像,一定深有體會:要模型正確渲染文字一直是一項令人抓狂的挑戰。拼寫錯誤、字體變形、排版混亂,幾乎是所有圖像模型的通病。而 GPT Image 2 在這方面的突破,正是社群討論的核心焦點。 @PlayingGodAGI 分享了兩張極具說服力的測試圖:一張是人體前側肌肉解剖圖,每一處肌肉、骨骼、神經及血管的標籤都達到教科書級別的精準度;另一張是 YouTube 首頁截圖,當中的 UI 元素、視頻縮略圖及標題文字均無任何變形。 他在推文中寫道:「這消除了 AI 生成圖像的最後一個缺陷。」 圖片來源:@PlayingGodAGI 展示的解剖圖與 YouTube 截圖對比 @avocadoai_co 的評價更為直接:「文字渲染能力簡直強得離譜。」 @0xRajat 亦指出:「這個模型的世界知識強得可怕,文字渲染近乎完美。只要你用過任何圖像生成模型,就會明白這個痛點有多深。」 圖片來源:日本博主 @masahirochaen 獨立測試的網站介面還原效果 日本博主 @masahirochaen 亦進行了獨立測試,證實該模型在真實場景描述及網站介面還原方面表現極為出色——連日文假名及漢字的渲染都十分準確。 Reddit 用戶也注意到這一點,並留言表示:「令我印象深刻的是,漢字和片假名都是正確的。」 這是大家最關心的問題:GPT Image 2 真的超越 Nano Banana Pro 了嗎? @AHSEUVOU15 進行了一項直觀的三圖對比測試,將 Nano Banana Pro、GPT Image 2(取自 A/B 測試)及 GPT Image 1.5 的輸出結果並排展示。 圖片來源:@AHSEUVOU15 的三圖對比;由右至左分別為:NBP、GPT Image 2、GPT Image 1.5 @AHSEUVOU15 的結論較為審慎:「在這個例子中,NBP 仍然較好,但 GPT Image 2 絕對比 1.5 有顯著提升。」這意味着兩個模型之間的差距已非常細微,勝負取決於具體的提示詞類型。 根據 OfficeChai 的深度報道,社群測試揭示了更多細節 : @socialwithaayan 分享的海灘自拍及 Minecraft 截圖進一步印證了這些發現,他總結道:「文字渲染終於能用了;世界知識和真實感更是提升到另一個層次。」 圖片來源:@socialwithaayan 分享的 GPT Image 2 Minecraft 遊戲截圖生成效果 [9](https://x.com/socialwithaayan/status/2040434305487507475) GPT Image 2 並非毫無弱點。OfficeChai 報道指出,該模型仍未能通過魔方反射測試。這是圖像生成領域的經典壓力測試,要求模型理解三維空間中的鏡像關係,並準確渲染魔方在鏡子中的倒影。 Reddit 用戶的反饋亦呼應了這一點。有人測試「設計一種能在真實生態系統中存在的全新生物」的提示詞時發現,雖然模型能生成視覺上複雜的圖像,但內部的空間邏輯並不總是合理。正如一位用戶所言:「文生圖模型本質上是視覺合成器,而非生物模擬引擎。」 此外,據 36Kr 早前報道,先前的盲測版本(代號 Chestnut 及 Hazelnut)曾因畫面「塑膠感太重」而受到批評。 不過,從社群對最新「膠帶」系列的反饋來看,這個問題似乎已得到顯著改善。 GPT Image 2 洩露的時間點耐人尋味。2024 年 3 月 24 日,OpenAI 宣布關閉旗下視頻生成應用 Sora,距離其推出僅六個月。據悉,Disney 在公告發布前不到一小時才得知消息。當時,Sora 每天燒掉約 100 萬美元,用戶數亦從高峰期的 100 萬跌至不足 50 萬。 關閉 Sora 釋放了龐大的算力。OfficeChai 的分析認為,下一代圖像模型是這批算力最合理的去向。OpenAI 的 GPT Image 1.5 早在 2025 年 12 月便已登上 LMArena 圖像排行榜榜首,超越 Nano Banana Pro。如果「膠帶」系列確實是 GPT Image 2,代表 OpenAI 正加倍押注圖像生成——這個「唯一仍有可能實現病毒式大規模普及的消費級 AI 領域」。 值得注意的是,這三個「膠帶」模型現已從 LMArena 下架。Reddit 用戶認為,這可能意味着官方發布在即。結合此前流傳的路線圖,新一代圖像模型極有可能與傳聞中的 GPT-5.2 同步推出。 雖然 GPT Image 2 尚未正式上線,但你現在就可以利用現有工具做好準備: 請注意,模型在 Arena 盲測中的表現可能與正式發布版本有所不同。處於盲測階段的模型通常仍在微調中,最終的參數設定及功能組合可能會有所變動。 問:GPT Image 2 何時會正式發布? 答:OpenAI 尚未正式確認 GPT Image 2 的存在。不過,三個「膠帶」代號模型從 Arena 下架,被社群普遍視為官方發布前 1 至 3 週的信號。結合 GPT-5.2 的發布傳聞,最早可能在 2024 年 4 月中下旬推出。 問:GPT Image 2 和 Nano Banana Pro 哪個更好? 答:目前的盲測結果顯示兩者各有優勢。GPT Image 2 在文字渲染、UI 還原及世界知識方面領先,而 Nano Banana Pro 在某些場景下的整體圖像質素依然更佳。最終結論有待正式版發布後進行更大規模的系統性測試。 問:maskingtape-alpha、gaffertape-alpha 和 packingtape-alpha 有何區別? 答:這三個代號很可能代表同一模型的不同配置或版本。從社群測試來看,maskingtape-alpha 在 Minecraft 截圖等測試中表現最為突出,但三者的整體水平相近。這種命名風格與 OpenAI 此前的 gpt-image 系列一致。 問:我在哪裏可以試用 GPT Image 2? 答:GPT Image 2 目前尚未公開發布,三個「膠帶」模型亦已從 Arena 下架。你可以關注 等待模型再次出現,或待 OpenAI 正式發布後透過 ChatGPT 或 API 使用。 問:為什麼文字渲染一直是 AI 圖像模型的難題? 答:傳統的擴散模型是在像素層面生成圖像,天生不擅長處理需要精確筆劃及間距的內容(如文字)。GPT Image 系列採用自回歸架構而非純擴散模型,因此能更好地理解文字的語義及結構,從而在文字渲染上取得突破。 GPT Image 2 的洩露標誌着 AI 圖像生成領域進入新的競爭階段。文字渲染、世界知識等長期痛點正被迅速攻克,Nano Banana Pro 不再是唯一的標杆。空間推理仍是所有模型的共同弱點,但進步速度已遠超預期。 對於 AI 圖像生成用戶而言,現在正是建立個人評估體系的最佳時機。使用同一組提示詞進行跨模型測試,記錄各模型的強項,這樣當 GPT Image 2 正式上線時,你就能立即作出準確判斷。 想系統化管理你的 AI 圖像提示詞及測試結果?試試 ,將不同模型的輸出結果保存至同一個項目,方便對比及回顧。 [1] [2] [3] [4] [5] [6] [7] [8] [9] [10]
黃仁勳宣布「AGI 已來臨」:真相、爭議與深度分析
TL;DR 重點摘要 2026 年 3 月 23 日,一則消息在社交媒體上引爆。NVIDIA CEO Jensen Huang 在 Lex Fridman 的 podcast 上說出這句話:「我認為我們已經實現了 AGI。」這條由 Polymarket 發佈的推文獲得超過 16,000 個讚好及 470 萬次瀏覽,The Verge、Forbes 和 Mashable 等主流科技媒體亦在數小時內密集報道。 本文寫給所有關注 AI 趨勢的讀者,無論你是技術人員、投資者,還是單純好奇的人。我們將完整還原這句話的語境,拆解圍繞 AGI 定義的「文字遊戲」,並分析它對整個 AI 行業意味着甚麼。 但如果你只看標題就下結論,就會錯過整件事最重要的部分。 要理解黃仁勳這句話的分量,必須先看它的前提。 Podcast 主持人 Lex Fridman 為 AGI 提供了一個非常具體的定義:AI 系統能否「做你的工作」,具體而言就是創辦、發展並營運一間價值超過 10 億美元的科技公司。他問黃仁勳,這樣的 AGI 還有多遠——5 年?10 年?20 年?黃仁勳的回答是:「我認為就是現在。」 Mashable 的深度分析指出了一個關鍵細節。黃仁勳對 Fridman 說:「你說的是十億,而且你沒說是永遠。」換言之,按照黃仁勳的解讀,如果 AI 能開發出一款爆紅應用程式,短暫賺取 10 億美元然後倒閉,也算「實現了 AGI」。 他以開源 AI Agent 平台 OpenClaw 為例。黃仁勳設想了一個場景:AI 創建了一項簡單的網絡服務,數十億人每人支付 50 美分使用,然後這項服務悄然消失。他甚至拿科網泡沫時代的網站作類比,暗示那些網站的複雜程度並不比現時 AI Agent 所能生成的內容高多少。 接着,他說出了那句被大多數標題黨忽略的話:「要 10 萬個這樣的 Agent 建立 NVIDIA 的機會率是零。」 這不是一個無關痛癢的註腳。正如 Mashable 所評論:「這不是一個小 caveat(附帶條件),而是整場比賽的關鍵。」 Jensen Huang 並非首位宣佈「AGI 已實現」的科技領袖。要理解這句話,必須將它放在更大的行業敘事之中。 2023 年,在《紐約時報》DealBook 峰會上,黃仁勳曾為 AGI 給出另一個定義:能夠以具競爭力的水平通過各種近似人類智能測試的軟件。當時他預測 AI 會在 5 年內達到這一標準。 2025 年 12 月,OpenAI CEO Sam Altman 表示「我們造出了 AGI」,並補充說「AGI 有點像呼嘯而過」,其社會影響遠低於預期,暗示行業正轉向定義「超級智能」。 2026 年 2 月,Altman 對 Forbes 表示:「我們基本上已經造出了 AGI,或者非常接近了。」但他後來補充,這是一種「精神層面」的表述,而非字面意義,並指出 AGI 仍需要「許多中等規模的突破」。 看出規律了嗎?每一次「AGI 已實現」的宣言,都伴隨着對定義的悄悄降級。 OpenAI 的創始章程將 AGI 定義為「在大多數具經濟價值的工作中表現超越人類的高度自主系統」。這個定義至關重要,因為 OpenAI 與 Microsoft 的合約中包含一項 AGI 觸發條款:一旦被認定實現了 AGI,Microsoft 對 OpenAI 技術的使用權將發生重大變化。據 Reuters 報道,新協議規定必須由獨立專家小組核實是否已實現 AGI,而 Microsoft 將保留 27% 的股份,並在 2032 年前享有特定技術使用權。 當數百億美元與一個模糊的概念掛鈎時,「誰來定義 AGI」就不再是學術問題,而是一場商業權力博弈。 雖然科技媒體的報道相對克制,但社交媒體上的反應卻呈現出截然不同的光譜。 Reddit 上的 r/singularity、r/technology 和 r/BetterOffline 等社群迅速湧現大量討論帖。一位 r/singularity 用戶的評論獲得了高度認同:「AGI 不只是『能做你工作的 AI 系統』。它的名字本身就說明了一切:人工『通用』智能(Artificial GENERAL Intelligence)。」 在 r/technology 上,一位自稱正在開發自動化桌面任務 AI Agent 的開發者寫道:「我們離 AGI 還差得遠。目前的模型在結構化推理方面表現出色,但仍然無法處理初級開發者憑直覺就能完成的開放式解難工作。不過 Jensen 是要賣 GPU 的,所以這種樂觀也說得通。」 中文 Twitter/X 上的討論同樣熱烈。用戶 @DefiQ7 發佈了一篇詳細的科普長帖,清晰區分了 AGI 與目前的「專用 AI」(如 ChatGPT 或文心一言),該帖被廣泛轉發。帖文提到:「這對科技界來說是核彈級新聞」,但同時強調 AGI 意味着「跨領域、自主學習、推理、規劃以及適應未知場景」,這超出了目前 AI 的能力範圍。 r/BetterOffline 上的討論則更加尖銳。一位用戶評論道:「哪一個次數更多?Trump 在伊朗取得『全面勝利』的次數,還是 Jensen Huang 實現『AGI』的次數?」另一位用戶指出了學術界長期存在的問題:「人工智能作為一個學術領域,自誕生之初就一直存在這個問題。」 面對科技巨頭不斷變化的 AGI 定義,普通人該如何判斷 AI 實際走到了哪一步?以下是一個實用的思考框架。 第一步:區分「能力演示」與「通用智能」。 目前最先進的 AI 模型確實在許多特定任務上表現驚人。GPT-5.4 能寫出流暢的文章,AI Agents 也能自動化複雜的工作流程。然而,「在特定任務上表現出色」與「具備通用智能」之間存在着巨大鴻溝。一個能在國際象棋中擊敗世界冠軍的 AI,可能連「把桌上的杯子遞給我」都做不到。 第二步:留意限定詞,而非標題。 黃仁勳說的是「我認為」,而不是「我們已經證明」。Altman 說的是「精神層面」,而不是「字面意義」。這些限定詞不是謙虛,而是精確的法律與公關策略。當涉及數百億美元的合約條款時,每一個字都經過仔細斟酌。 第三步:看行動,而非宣言。 在 GTC 2026 上,NVIDIA 發佈了七款新晶片,並推出了 DLSS 5、OpenClaw 平台以及 NemoClaw 企業級 Agent 堆疊。這些都是實實在在的技術進步。然而,黃仁勳在演講中提到「推理」(inference)近 40 次,而「訓練」(training)只提及約 10 次。這表明行業重心正從「打造更聰明的 AI」轉向「讓 AI 更高效地執行任務」。這是工程上的進步,而非智能的突破。 第四步:建立自己的資訊追蹤系統。 AI 行業的資訊密度極高,每週都有重大發布和聲明。單靠標題黨新聞推送很容易被誤導。建議養成閱讀一手資料(例如公司官方網誌、學術論文和 podcast 文字記錄)的習慣,並善用工具系統化地儲存和整理這些數據。例如,你可以使用 的項目功能儲存關鍵資訊來源,隨時利用 AI 提問並交叉驗證數據,避免被單一敘事誤導。 問:Jensen Huang 所說的 AGI 與 OpenAI 定義的 AGI 一樣嗎? 答:不一樣。黃仁勳是根據 Lex Fridman 提出的狹窄定義(AI 能創辦一間價值 10 億美元的公司)作答,而 OpenAI 章程中的 AGI 定義是「在大多數具經濟價值的工作中表現超越人類的高度自主系統」。兩者標準差距巨大,後者所需的能力範圍遠超前者。 問:目前的 AI 真的能獨立營運一間公司嗎? 答:目前不能。黃仁勳本人也承認,雖然 AI Agent 或許能開發出一款曇花一現的爆紅應用程式,但「要建立 NVIDIA 的機會率是零」。目前的 AI 擅長結構化任務執行,但在需要長期戰略判斷、跨領域協調及應對未知情況的場景中,仍然高度依賴人類指導。 問:AGI 的實現會對日常工作帶來甚麼影響? 答:即使按照最樂觀的定義,目前 AI 的影響主要體現在提升特定任務的效率,而非完全取代人類工作。Sam Altman 在 2025 年底也承認,AGI 的「社會影響遠低於預期」。短期內,AI 更有可能作為強大的輔助工具改變我們的工作方式,而非直接取代職位。 問:為甚麼科技公司的 CEO 如此急於宣佈 AGI 已經實現? 答:原因是多方面的。NVIDIA 的核心業務是銷售 AI 運算晶片;AGI 的敘事能維持市場對 AI 基礎設施投資的熱情。OpenAI 與 Microsoft 的合約包含 AGI 觸發條款,AGI 的定義直接影響數百億美元的分配。此外,在資本市場上,「AGI 即將來臨」的敘事是支撐 AI 公司高估值的重要支柱。 問:中國的 AI 發展距離 AGI 還有多遠? 答:中國在 AI 領域已取得顯著進展。截至 2025 年 6 月,中國生成式 AI 用戶數量達 5.15 億,DeepSeek 和 Qwen 等大模型在各項基準測試中表現優異。然而,AGI 是全球性的技術挑戰,目前尚未有獲全球學術界廣泛認可的 AGI 系統。預計 2025 年至 2035 年間,中國 AI 產業的市場規模複合年增長率將達 30.6%–47.1%,展現強勁勢頭。 Jensen Huang 的「AGI 已實現」言論,本質上是基於一個極其狹窄定義的樂觀表述,而非經證實的技術里程碑。他本人也承認,目前的 AI Agents 距離建立真正複雜的企業仍有天壤之別。 AGI 定義被反覆「移動龍門」的現象,揭示了科技行業中技術敘事與商業利益之間的微妙互動。從 OpenAI 到 NVIDIA,每一句「我們實現了 AGI」都伴隨着標準的悄悄降低。作為資訊消費者,我們需要的不是追逐標題,而是建立自己的判斷框架。 AI 技術無疑正在快速進步。GTC 2026 上發佈的新晶片、Agent 平台和推理優化技術都是實實在在的工程突破。但將這些進展包裝成「AGI 已實現」,更多是一種市場敘事策略,而非科學結論。保持好奇心、維持批判思維,並持續追蹤一手資料,才是在這個 AI 加速時代避免被資訊洪流淹沒的最佳策略。 想系統化地追蹤 AI 行業趨勢?試試 ,將關鍵資訊來源儲存到你的個人知識庫,讓 AI 協助你整理、查詢和交叉驗證。 [1] [2] [3] [4] [5] [6]
AI 網紅的崛起:創作者必備趨勢與機遇
重點摘要(TL;DR) 2026 年 3 月 21 日,Elon Musk 在 X 上發了一則只有八個字的帖文:「AI bots will be more human than human.」(AI 機械人將會比人類更有人性。)這則帖文在 72 小時內獲得超過 6,200 萬次瀏覽及 58 萬個讚好。他是在回應一張 AI 生成的「完美網紅臉」圖片時寫下這句話的。 這不是科幻預言。如果你是內容創作者、博主或社交媒體管理員,你大概已經在動態消息中滑過那些「太過完美」的面孔,甚至分不清他們是真人還是 AI。本文將帶你了解 AI 虛擬網紅的現況、頂尖案例的收入數據,以及作為真人創作者的你該如何應對這場變革。 本文適合內容創作者、社交媒體營運人員、品牌營銷人員,以及所有對 AI 趨勢感興趣的讀者。 首先,來看一組會讓你坐直身子的數字。 全球虛擬網紅市場規模在 2024 年達到 60.6 億美元,預計 2025 年將增長至 83 億美元,年增長率超過 37%。根據 Straits Research 的資料,這個數字預計到 2033 年將飆升至 1,117.8 億美元。 同時,整個網紅營銷產業在 2025 年達到 325.5 億美元,預計 2026 年將突破 400 億美元大關。 具體到個人,有兩個代表性案例值得細看。 Lil Miquela 被公認為「初代 AI 網紅」。這個誕生於 2016 年的虛擬角色在 Instagram 擁有超過 240 萬粉絲,曾與 Prada、Calvin Klein 及 Samsung 等品牌合作。她的團隊(隸屬 Dapper Labs)每篇品牌帖文的收費高達數萬美元。單計她在 Fanvue 平台的訂閱收入,每月就達 4 萬美元,加上品牌合作,月收入可超過 10 萬美元。據估計,她自 2016 年以來的平均年收入約為 200 萬美元。 Aitana López 則代表了「個人創業者也能打造 AI 網紅」的可能性。這位由西班牙創意公司 The Clueless 創造的粉髮虛擬模特兒,在 Instagram 擁有超過 37 萬粉絲,每月收入介乎 3,000 至 10,000 歐元。創造她的原因很實際:創辦人 Rubén Cruz 厭倦了真人模特的不可控因素(遲到、取消、檔期衝突),於是決定「創造一個永遠不會放飛機的網紅」。 公關巨頭 Ogilvy 在 2024 年作出的一項預測震撼了整個業界:到 2026 年,AI 虛擬網紅將佔據網紅營銷預算的 30%。 一項針對英美 1,000 名高級營銷人員的調查顯示,79% 的受訪者表示正在增加對 AI 生成內容創作者的投資。 要看清這場變革背後的推動力,你必須理解品牌的邏輯。 零風險,完全掌控。 真人網紅最大的風險就是「醜聞」。一句不當言論或一宗私人醜聞,就能讓品牌數以百萬計的投資付諸流水。虛擬網紅沒有這個問題。他們不會疲倦、不會衰老,也不會在凌晨三點發出一則令公關團隊崩潰的帖文。正如 The Clueless 創辦人 Rubén Cruz 所說:「很多項目因為網紅本身的問題而暫停或取消;這不是設計缺陷,而是人性的不可預測。」 全天候內容輸出。 虛擬網紅可以每日發文、實時緊貼潮流,並能「現身」於任何場景,成本遠低於真人拍攝。根據 BeyondGames 的估算,如果 Lil Miquela 每天在 Instagram 發文一次,她在 2026 年的潛在收入可達 470 萬英鎊。 這種輸出效率是任何真人創作者都無法匹敵的。 精準的品牌一致性。 Prada 與 Lil Miquela 的合作,互動率比一般營銷活動高出 30%。 虛擬網紅的每一個表情、每一套服裝、每一句文案都可以經過精準設計,確保與品牌調性完美契合。 不過,凡事都有兩面。Business Insider 在 2026 年 3 月的報道指出,消費者對 AI 帳戶的反感正在上升,部分品牌已開始從 AI 網紅策略中退場。YouGov 的一項調查顯示,超過三分之一的受訪者對 AI 技術表示擔憂。 這意味着虛擬網紅並非萬靈丹;真實感對消費者而言依然重要。 面對 AI 虛擬網紅的衝擊,恐慌無用,行動才有價值。以下是四個經證實有效的應對策略。 策略一:深化真實體驗,做 AI 做不到的事。 AI 可以生成完美的面孔,卻無法真正品嚐一杯咖啡,也感受不到行山後的疲憊與滿足。在 Reddit 的 r/Futurology 討論區中,一位用戶的留言獲得了高度認同:「AI 網紅可以賣產品,但人們依然渴望真實的連結。」 將你的真實生活經歷、獨特視角和不完美時刻,轉化為內容護城河。 策略二:用 AI 工具武裝自己,而非與 AI 對抗。 聰明的創作者早已在用 AI 提升效率。Reddit 上有創作者分享了完整的工作流程:用 ChatGPT 寫腳本、ElevenLabs 配音、HeyGen 製作視頻。 你不需要成為 AI 網紅,但你需要讓 AI 成為你的創作助手。 策略三:系統化追蹤行業趨勢,建立資訊優勢。 AI 網紅領域發展極快,每週都有新工具、新案例和新數據出現。隨便刷刷 Twitter 和 Reddit 遠遠不夠。你可以使用 系統化管理散落在各處的行業資訊:將關鍵文章、帖文和研究報告儲存到項目中,利用 AI 自動整理和檢索,隨時向你的素材庫提問,例如「2026 年虛擬網紅領域最大的三筆融資是什麼?」。當你需要撰寫行業分析或拍攝視頻時,素材早已準備就緒,不用從零開始。 策略四:探索「人機協作」的內容模式。 未來不是「人類 vs. AI」的零和遊戲,而是「人類 + AI」的協作共生。你可以用 AI 生成視覺素材,再用真人的聲音和視角賦予它靈魂。 的分析指出,AI 網紅適合實驗性、突破邊界的概念,而真人網紅在建立深度受眾連結和鞏固品牌價值方面依然無可取代。 追蹤 AI 虛擬網紅趨勢的最大挑戰,不是資訊太少,而是資訊太多且太分散。 典型場景是這樣的:你在 X 上看到 Musk 的帖文,在 Reddit 讀到一篇關於某 AI 網紅月入 1 萬美元的拆解文章,在 Business Insider 找到一份關於品牌退場的深度報告,然後又在 YouTube 滑過一條教學片。這些資訊散落在四個平台、五個瀏覽器分頁中。三天後,當你想寫一篇文章時,卻找不到那條關鍵數據。 這正是 要解決的問題。你可以使用 ,一鍵將任何網頁、帖文或 YouTube 視頻剪輯到你的專屬項目中。AI 會自動提取關鍵資訊並建立索引,讓你隨時用自然語言搜尋和提問。例如,建立一個「AI 虛擬網紅研究」項目,集中管理所有相關素材。當你需要產出內容時,直接向項目提問:「Aitana López 的商業模式是什麼?」或「哪些品牌已開始退出 AI 網紅策略?」,答案便會連同原始來源連結一併呈現。 需要留意的是,YouMind 的強項在於資訊整合與研究輔助,並非 AI 網紅生成工具。如果你的需求是創造虛擬角色圖像,仍然需要使用 Midjourney、Stable Diffusion 或 HeyGen 等專業工具。但在「研究趨勢 → 累積素材 → 產出內容」這個核心創作流程中, 能大幅縮短由靈感到成品的距離。 問:AI 虛擬網紅會完全取代真人網紅嗎? 答:短期內不會。虛擬網紅在品牌可控性和內容輸出效率上具有優勢,但消費者對真實感的需求依然強烈。Business Insider 2026 年的報告顯示,部分品牌已因消費者的反感而減少對 AI 網紅的投資。兩者更可能形成互補關係,而非取代關係。 問:普通人可以打造自己的 AI 虛擬網紅嗎? 答:可以。Reddit 上有不少創作者分享了從零開始的經驗。常用工具包括用 Midjourney 或 Stable Diffusion 生成風格一致的圖像、用 ChatGPT 撰寫文案,以及用 ElevenLabs 生成語音。初期投入可以很低,但需要持續營運 3 至 6 個月才能看到顯著增長。 問:AI 虛擬網紅的收入來源有哪些? 答:主要分為三類:品牌贊助帖文(頂級虛擬網紅每篇收費數千至數萬美元)、訂閱平台收入(如 Fanvue),以及衍生品與音樂版權。Lil Miquela 單靠訂閱收入每月平均就有 4 萬美元,品牌合作收入更高。 問:中國 AI 虛擬偶像市場的現況如何? 答:中國是全球虛擬偶像發展最活躍的市場之一。根據業界預測,中國虛擬網紅市場到 2030 年將達到 2,700 億元人民幣。由初音未來、洛天依到超寫實虛擬偶像,中國市場經歷了多個發展階段,目前正向 AI 驅動的實時互動方向演進。 問:品牌選擇與虛擬網紅合作時應注意什麼? 答:評估三點至關重要:目標受眾對虛擬形象的接受度、平台對 AI 內容的披露政策(TikTok 和 Instagram 正加強相關要求),以及虛擬網紅與品牌調性的契合度。建議先以小額預算測試,再根據數據決定是否加大投入。 AI 虛擬網紅的崛起不是遙遠的預言,而是正在發生的現實。市場數據清楚顯示,虛擬網紅的商業價值已得到驗證——由 Lil Miquela 的 200 萬美元年收入,到 Aitana López 的 1 萬歐元月收入,這些數字不容忽視。 但對真人創作者而言,這不是一個「被取代」的故事,而是一次「重新定位」的機會。你的真實經歷、獨特視角,以及與受眾的情感連結,都是 AI 無法複製的核心資產。關鍵在於善用 AI 工具提升效率、以系統化方法追蹤趨勢,並用真實感築起無可取代的競爭護城河。 想系統化追蹤 AI 網紅趨勢、累積創作素材?立即試用 建立你的專屬研究空間,免費開始。 [1] [2] [3] [4] [5] [6] [7] [8] [9] [10] [11]