零代碼打造 Karpathy 風格 AI 知識庫
Karpathy 剛剛用一個極客梗把整個 AI 圈子耍得團團轉——而你還真的上當了。
上星期,Andrej Karpathy 在 X 上發文,說自己不再把大部分 AI token 用來寫程式碼,而是用來建立個人知識庫。這條帖文獲得 1,200 萬次瀏覽,半個互聯網的人突然覺得自己必須要有個 Markdown wiki 才算有效率。
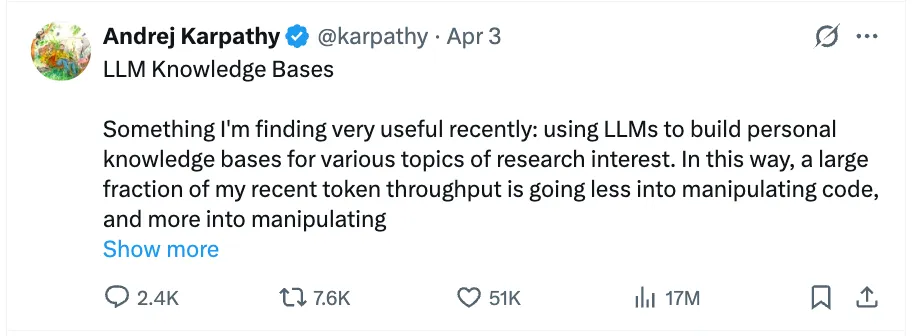
聽起來很熟悉?這就是「Karpathy 效應」:拋出一個看似簡單卻暗藏玄機的想法,然後看着所有人爭相模仿。
如果你真的試過跟隨他的方法,就會發現當中漏洞不少。不是理論有問題,而是實踐上行不通。這篇指南會教你如何在完全不碰命令列的情況下,達到同樣的效果。
設置成本是真實存在的
Karpathy 的方法在紙面上很優雅:把原始素材餵給 LLM,跳過 RAG,跳過向量數據庫,讓模型自動把所有內容整理成結構化的 Markdown wiki,包含摘要、反向連結和概念索引。
他的帖文大約 600 字。對於長年活在終端機裏的人來說,這個工作流程確實不複雜。
但 Karpathy 是全球頂尖的 AI 工程師之一。在他眼中「幾個簡單步驟」,其實充滿了隱性知識——專家覺得理所當然,其他人卻完全看不到的東西。這正是為什麼他的帖文發出後幾天內,就湧現了幾十篇手把手教學。
不過,隨便打開其中一篇,你就會發現一個規律:全都是工程師寫給工程師看的。建立 raw/、wiki/ 和 outputs/ 目錄;安裝 Node.js;在終端機配置 Claude Code;寫一段系統提示詞,強迫 LLM 輸出格式正確的 Markdown。
問題在於:真正需要這套方法的人之中,工程師只佔極少數。
內容創作者、營銷人員、研究生、編寫教材的老師、追蹤行業趨勢的分析師——這些人每天都在經歷「收集 → 理解 → 產出」的循環。可以說,他們比工程師更需要一套 AI 驅動的知識系統。但要他們配置終端機環境、手寫 Markdown、除錯提示詞模板?
根本行不通。
工具應該服務用戶,而不是要用戶遷就工具。
更大的問題:知識庫是一條死胡同
先暫時放下設置成本不談。即使你順利跑通了所有流程,整套方法背後還有一個更深層的問題。
Karpathy 的方法大幅降低了整理資訊的成本。以前你要自己寫摘要、自己加標籤、自己建立連結,現在 LLM 全包了。對打造「第二大腦」而言,這確實是一大進步。
但終點沒有變。知識庫依然是用來閱讀的東西。
如果你的目標純粹是研究和學習,一個自動整理好的精美 wiki 已經綽綽有餘。但大多數知識工作者不是靠理解事物來賺錢,而是靠產出事物。
知識工作者真正的任務不是收集知識,而是把知識轉化為成果。 你讀過的每一篇文章、收藏的每一集 Podcast、標記過的每一篇論文,都是為了服務你需要撰寫、演示、發佈或交付的東西。
精美的 wiki 無法帶你走到那一步。它只是把你送到起跑線,然後讓你呆站在那裏。
我稱之為生產力劇場——完美模擬了「正在進步」的感覺,卻交不出實際成果。你得到了「看我多麼有條理」的多巴胺,卻換不來「看我做出了什麼」的回報。
一個真實例子
讓我具體說明一下。就用 Karpathy 自己的帖文作為場景。
假設你是某間 AI 公司的營銷人員。你看到他的帖文爆紅,想趁勢追擊——寫篇網誌文章、擬幾條社交媒體帖文串,或者為團隊快速做一份簡報。標準的內容操作。
如果按照 Karpathy 的方法,你需要這樣做:
- 抓取他的帖文、想法文件和相關評論文章,全部下載到
raw/資料夾。 - 安裝 Node.js,在終端機設置 Claude Code,編寫指令檔案,讓 Claude Code 把原始素材整理成 wiki 條目。
- 下載 Obsidian 或其他 Markdown 編輯器,才能真正查看你閃亮亮的「LLM 知識庫」。
- 打開空白文件……然後從零開始寫作。
先別管第 4 步。光是第 1 到第 3 步,就要你使用終端機、安裝 Node.js、配置 API 密鑰、編寫提示詞指令,還要設置 Obsidian。對大部分人來說,這條工具鏈會在項目開始之前就把它扼殺掉。
就算你硬着頭皮全部搞定,第 4 步又會把你打回原形。沒錯,知識庫幫你理解了這個主題。但寫作、配圖、發佈——全都還是要你從零開始親手完成。
所以問題來了:有沒有辦法一次過解決這兩個難題——既容易搭建,又能真正產出成品?
有。 你正在閱讀的這篇文章,就是這樣做出來的。整個過程我只用了一個工具:YouMind。以下是具體做法。
實際操作方式(無需寫代碼)
第一步:收集素材來源
在瀏覽器中打開 YouMind。建立一個新 Board(你可以把它當成專屬的項目工作區),然後開始儲存所有相關內容:
- 網頁文章:貼上網址,自動擷取全文
- YouTube 視頻:貼上連結,自動提取字幕和內容
- PDF 和論文:直接上傳
- Podcast:貼上連結,自動解析音頻
- 你自己的筆記:隨時記錄靈感
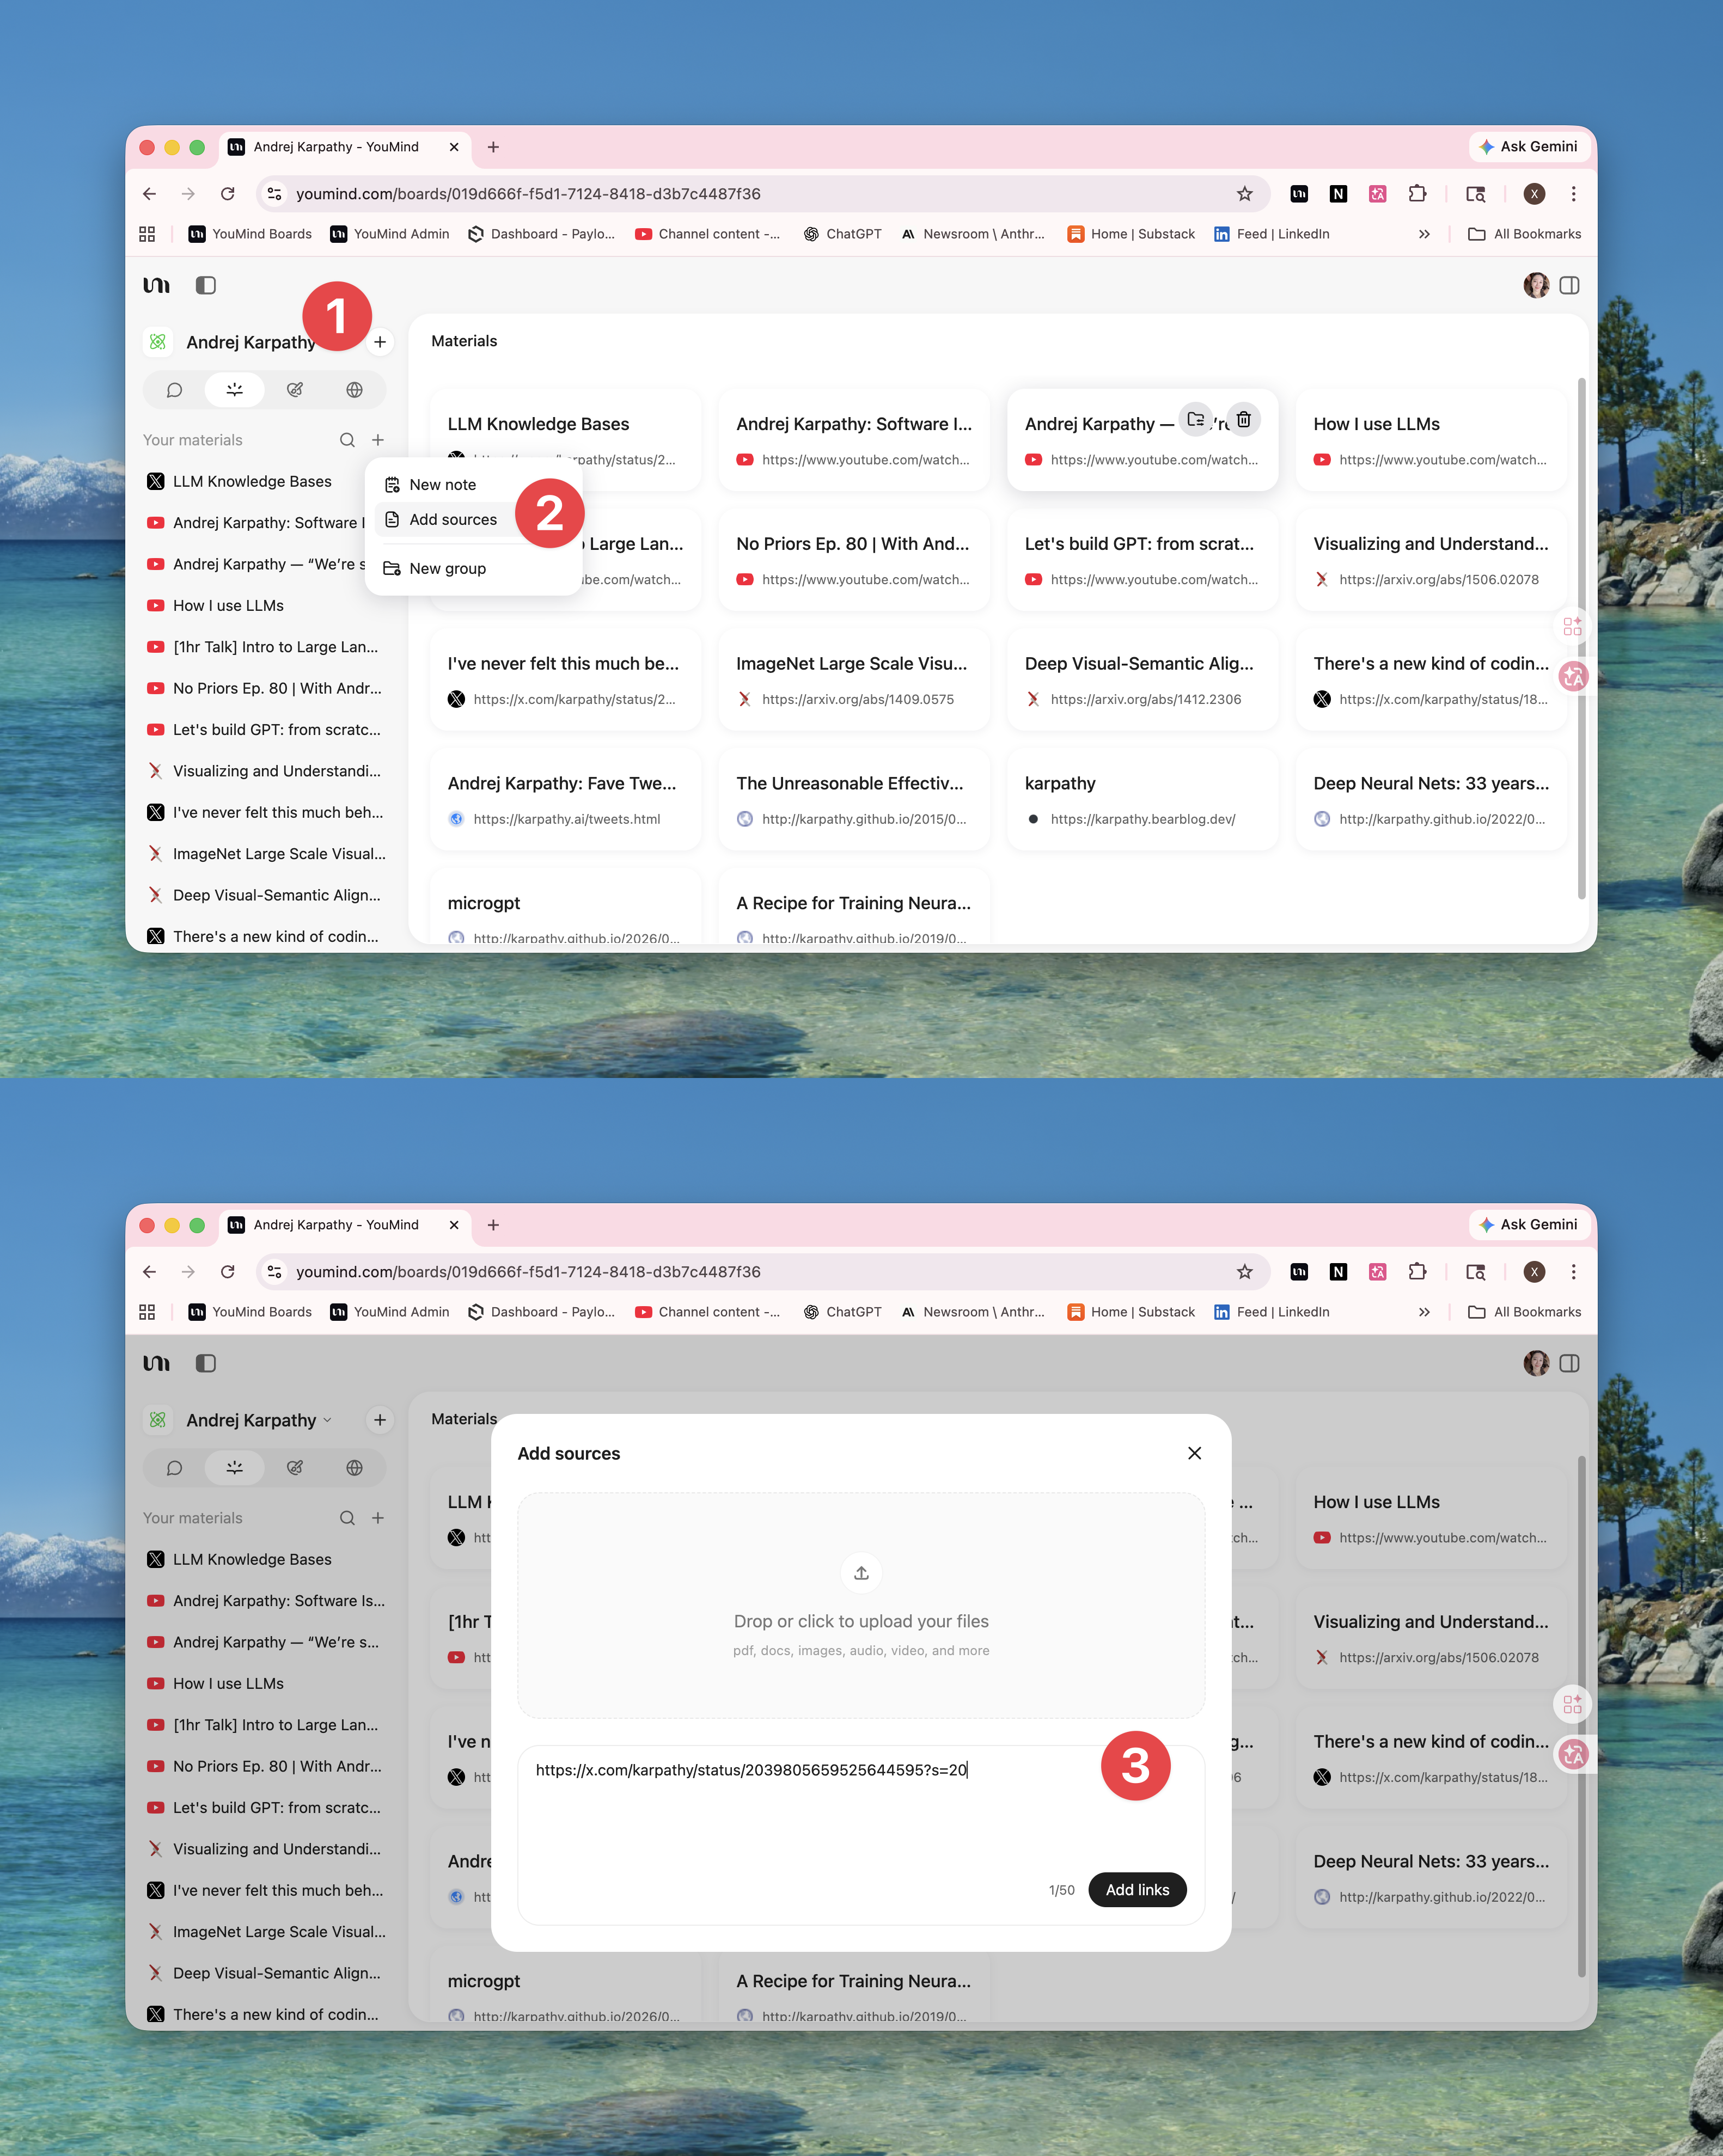
這就是 Karpathy 的 raw/ 資料夾——不用手動下載,不用管理檔案系統,不用開終端機。
第二步:與你的素材對話
素材儲存好之後,你可以直接在 Board 內與 AI 對話。關鍵分別在於:AI 的上下文是你為這個項目精心挑選的第一手素材,而不是泛泛的互聯網雜訊。
你可以問這類問題:
- 「這些文章之間有哪些主要異同?」
- 「Karpathy 的方法和 Tiago Forte 的 PARA 法相比如何?」
- 「根據這些素材,寫網誌文章最有說服力的三個切入角度是什麼?」

這相當於 Karpathy 的 wiki 整理步驟。但你不必等 LLM 自動生成整個 wiki,而是主動引導對話,直奔你真正需要的理解。
第三步:從理解走向產出
兩種方法在這裏徹底分道揚鑣。Karpathy 的工作流到第二步就結束了。而在 YouMind,你可以繼續:
- 根據素材和對話生成完整的網誌草稿
- 從核心觀點中提取適合 Twitter/X 的精煉帖文串
- 把核心論點轉化成視覺化資訊圖
- 直接製作簡報投影片
你產出的所有內容都與原始素材和對話紀錄存在同一個 Board 內。沒有任何東西被孤立。一切都屬於同一條互聯互通的知識流水線。

第四步:持續增長
Board 不是一次性的。你可以設定排程任務,讓 YouMind 自動拉取最新資訊——例如 Karpathy 的最新帖文——並隨時間存入同一個 Board。你的知識會不斷累積增值,而不會過時。

這才是「第二大腦」應有的模樣。不只是堆積——而是產出。
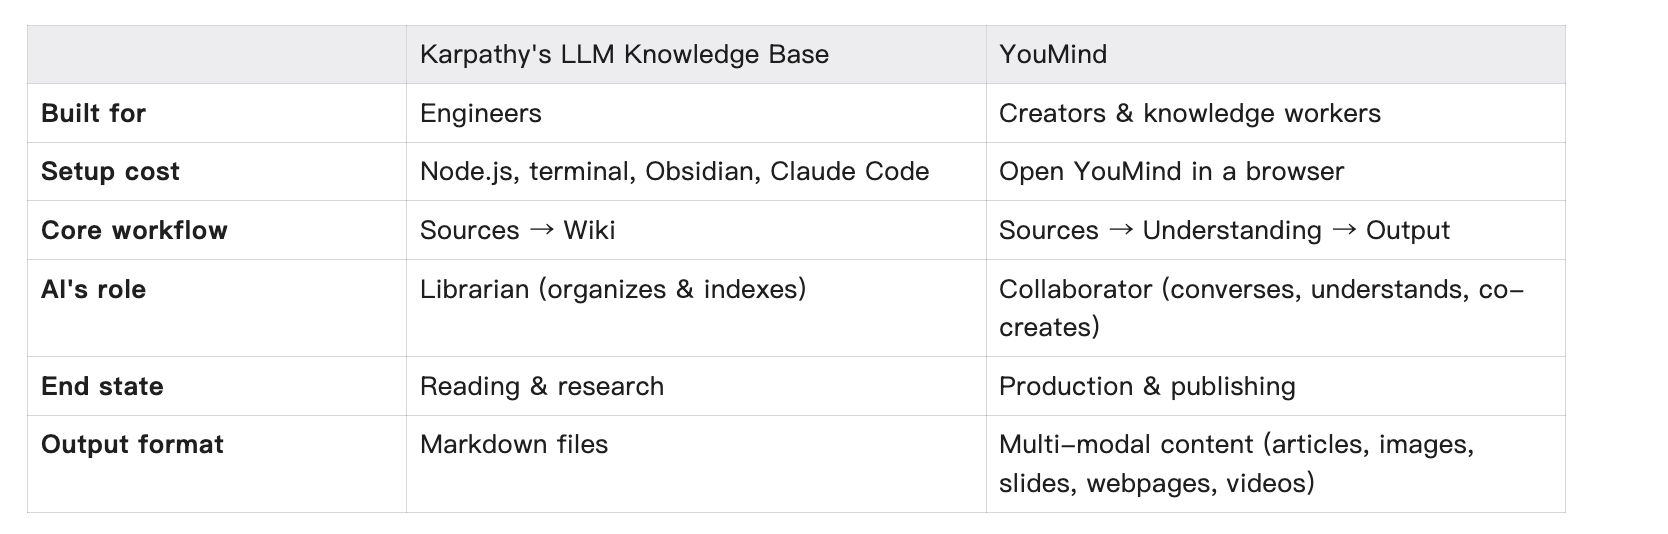
把 Karpathy 的方法和 YouMind 放在一起比較,它們代表了兩種不同的「AI 第二大腦」理念:
資訊焦慮的真正解藥
這裏有個沒人討論的諷刺之處。
Karpathy 建了一個 40 萬字的 wiki。但這個世界真正引用的是什麼?不是那個 wiki。是他的帖文、他的 YouTube 講座、他的網誌文章。他的 Markdown 檔案只有他自己一個讀者,而他公開發佈的內容觸及了 1,200 萬人。
真正的知識庫不是一套系統,而是一個人。
當你寫出一篇文章,把一件事解釋得清清楚楚,讓人忍不住收藏、引用、分享——你就成了他們的知識庫。
這才是知識焦慮的真正解藥。焦慮的人把資訊倒進系統,指望系統替他們理解。而真正有影響力的人,會把理解推向世界,讓自己成為別人依賴的源頭。
第一類人永遠焦慮,因為資訊無窮無盡。第二類人毫不焦慮,因為表達想法的過程,正是你完成理解的過程。
問題從來不是「我該如何建立更好的知識庫」,而是「我該如何成為知識庫」。答案很簡單:持續發佈。
YouMind 的存在,就是為了把你從資訊的消費者,變成資訊的源頭。
本文及其插圖由編輯與 YouMind 共同創作。