画面灵感导演|让AI帮你把脑海中的画面表达出来
把脑中的感觉,一步步变成看得见的画面
画面灵感导演|让AI帮你把脑海中的画面表达出来
把脑中的感觉,一步步变成看得见的画面
展示内容
描述
把脑中的模糊画面变成图片或单镜头视频:逐题采访、整理画面蓝图与完整提示词,并对照实际结果定向修正。适合“有感觉但不会描述”、已有完整画面需求,或生成结果不符合预期的情况。
推荐自
Dancang
为什么我们推荐这个技能
它把模糊感受转译为可检查的视觉决策,按用户当前阶段灵活推进采访、蓝图、生成与校准。独特之处在于坚持单步提问、保留已定内容,并以真实结果为依据进行最小改动,避免提示词堆砌与无效重做。
相关技能
查看全部
AI视频与分镜提示词生成
把剧情、角色设定或已有视频提示词,转化为适合 AI 视频生成的专业短剧分镜与可直接使用的镜头提示词。无论是都市、古装、悬疑、情感还是爽剧场景,都能围绕人物关系、剧情节奏和情绪钩子,明确景别、机位、视角、运镜、构图、光影、环境音与台词,让每个镜头具备清晰的视觉重点和可执行动作。 技能会特别关注角色一致性与场景连续性,帮助锁定人物外观、服装逻辑、身份状态和标志性细节,降低换脸、漂移、空间错乱及动作含糊等生成风险。角色的眼神、表情、呼吸、手部和身体反应也会被转化为可见的表演变化,增强短剧的冲突、压迫感、反转与情绪递进。 你可以从完整剧情开始,也可以提供已有角色资产、分镜或提示词进行定向优化;已有稳定人设时可直接沿用,避免重复设计。最终还能将完整镜头整理为适合主流 AI 视频模型逐段生成的 15 秒以内片段,并保留画面、声音和时长信息,便于复制使用与后续剪辑。
 图片
AI人物精准出图
把脑海中的人物形象变成可直接使用的提示词与成品图,从一句种子描述或一个题材方向出发,逐步明确发型、发饰、服饰、表情、姿态、镜头、光影和场景等关键细节。无论是古风仕女、赛博少女、日系角色、写实人像,还是自定义人物设定,都能根据整体气质获得协调统一的视觉方案。 你可以选择快速出图,让 AI 自动补全人物设定;也可以进行精细控制,通过点选或自定义逐项调整。生成结果会包含中英双语结构化提示词和匹配画风的 Negative Prompt,方便理解、复用,并适配 FLUX、Midjourney、SDXL 等主流模型使用,同时通过 AI 图像生成获得人物成图。 出图后还能按维度继续微调,例如更换发型、表情、姿态、机位、光影、场景或画风,在保留其他设定的基础上重新生成,并清楚标注本次修改内容。适合角色设计、人物概念图、头像创作、插画构思和视觉设定探索。
 视频
火种|视频图解生成器
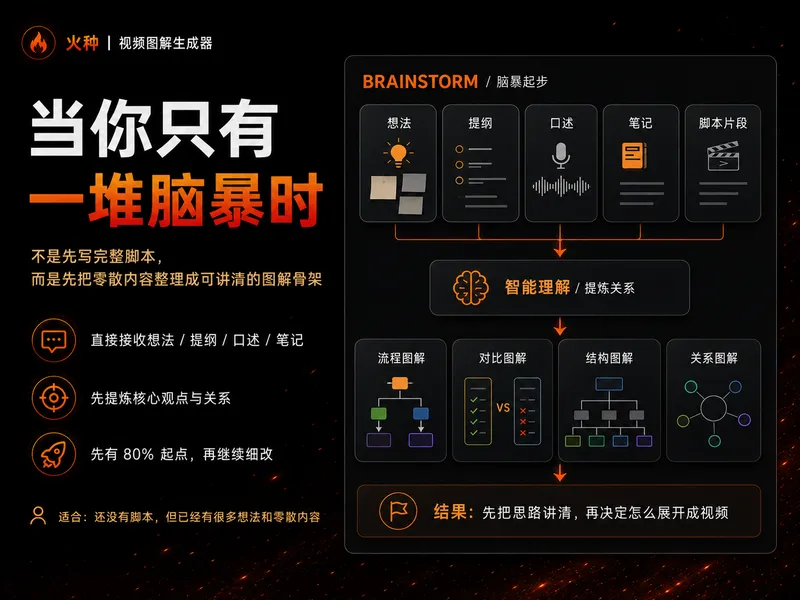
很多视频不是“没有内容”,而是内容太抽象、太密,观众听懂了前一句,下一句就忘了。 「火种|视频图解生成器」会把你的想法、脑暴、提纲、脚本、逐字稿或文章,先拆成真正值得视觉化的概念,再判断它更适合用流程、对比、架构、层级、循环、分支、决策树还是其他图解结构表达。 它不会为了凑数量硬画,也不会把复杂内容塞成一张密密麻麻的信息图。多张图会保持同一套视觉语言、命名和语义色,方便直接插入视频作为讲解骨架。 特别适合: 解释复杂概念 拆解工作流 对比两种方法 展示系统结构 讲清因果关系 把长篇脑暴整理成一组视频视觉节点 默认输出为 16:9 静态图解。若运行环境无法提供可编辑 Excalidraw 源文件,会明确说明,不会把静态图片冒充 .excalidraw。 适用场景 场景 1|把脑暴变成图解 只有一大段口述想法,没有完整脚本。技能会从中找出最值得画的观点,整理成一组有讲述顺序的图解。 场景 2|把脚本变成视频视觉节点 已有完整脚本,但不知道哪里该加画面。技能会判断哪些段落值得视觉化,并选择合适的图型。 场景 3|解释复杂概念 例如 AI Agent 如何工作、为什么工作流比单次演示重要、商业模式如何运转、产品架构包含哪些层。 场景 4|拆工作流 / 流程 例如:选题池 → 研究 → Hook → 脚本 → 制作 → 复盘。 场景 5|做对比 例如:没有工作流 vs 有工作流;传统方式 vs AI 方式;单次成功 vs 稳定可复制。
信息
- 版本
- v6
- 更新时间
- 运行积分
- 按实际用量
- 模型
- 自动选择