วิธีเปลี่ยน PDF, หน้าเว็บ และบันทึกเป็น Client Deck ด้วย YouMind (คู่มือฉบับเต็ม)
เกี่ยวข้อง: การเลือก Skill สำหรับงานนำเสนอ → 10 Skills สำหรับสไลด์ระดับมืออาชีพ การทำสไลด์ให้จบจากวัสดุที่คุณมี → บทความนี้
คู่มือนี้แก้ปัญหาอะไร (อ่าน 30 วินาที)
คุณมีรายงาน PDF, หน้าอ้างอิงสองหน้า และโน้ตของคุณเองอยู่แล้ว คุณต้องการสไลด์สรุปงานที่ส่งมอบได้จริงภายในไม่กี่ชั่วโมง—ไม่ใช่ภาพรวมห้าขั้นตอนแบบเดิม ๆ ที่บอกว่า “รวบรวม → วางโครงร่าง → สร้าง → แก้ไข → ส่งออก”
บทความนี้จะพาไปดู เคสจริงของ YouMind ตั้งแต่ต้นจนจบ: รายการแหล่งข้อมูล, สิ่งที่เราตัดทิ้ง, สิ่งที่ร่างแรกทำพลาด, การแก้ไขระดับหน้า, สไตล์ที่เราปฏิเสธ และข้อจำกัดในการส่งออกที่คุณควรรู้ก่อนจะรับปากใครว่า “PowerPoint แก้ไขได้” เมื่ออ่านจบ คุณจะสามารถทำตามเส้นทางนี้ใหม่ด้วย PDF และโน้ตของ คุณ เอง—และรู้ว่าจะต้องแก้อะไรบ้างหลังสร้างเสร็จ
ฉาก (กำหนดตายตัว): การสรุปข้อมูลภายในสไตล์พนักงานสายความรู้ / ที่ปรึกษา ในเดโมนี้ การสรุปจะถามว่าทีมคอนเทนต์ขนาดเล็กควรทดสอบ เวิร์กโฟลว์ AI สองรูปแบบ อะไรในเดือนหน้า เราจะไม่ขยายไปถึงกรณีใช้งานของนักเรียน งานพิตช์ หรือการฝึกอบรมในที่นี่ หากต้องการเลือก Skill/สไตล์ ให้ใช้คอลเลกชันที่ลิงก์ไว้ด้านบน
การตั้งค่าเคสและรายการแหล่งข้อมูล
- **เป้าหมาย** — เสนอโครงการนำร่องเวิร์กโฟลว์ AI ระยะสี่สัปดาห์สองโครงการต่อหัวหน้าทีมคอนเทนต์และบรรณาธิการ ชี้แจงให้ชัดว่าคนรับผิดชอบส่วนไหน และคุณจะตัดสินใจอย่างไรว่าจะทำต่อหรือไม่
- **กลุ่มผู้ชม — ทีมคอนเทนต์ขนาดเล็ก · ~10 นาที · 8 สไลด์ภาษาอังกฤษ**
- **มาตรฐาน** — ควบคุมความยาวได้ ข้อกล่าวอ้างพร้อมขึ้นเวที ทุกตัวเลขสำคัญตรวจสอบย้อนกลับไปยังแหล่งข้อมูลได้—ไม่มีการกุเรื่องลูกค้า จำนวนคน งบประมาณ หรือ “เวลาที่ประหยัดได้” ขึ้นมา
- **ป้ายกำกับ** — การสาธิตบทเรียนจากแหล่งข้อมูลสาธารณะ—ไม่ใช่งานของลูกค้า ไม่ใช่แผนภายในที่ได้รับอนุมัติ
แหล่งข้อมูล
- แหล่งข้อมูล: Microsoft 2026 Work Trend Index (PDF) · บทบาท: หลัก · ผลลัพธ์: เก็บไว้ ใช้เลขหน้าที่พิมพ์ออกมาเพื่อตรวจสอบ
- แหล่งข้อมูล: Anthropic Economic Index: Cadences (เว็บ) · บทบาท: สนับสนุน · ผลลัพธ์: เก็บไว้ อ้างอิงตามบท
- แหล่งข้อมูล: Stanford 2026 AI Index — Economy (เว็บ) · บทบาท: ตั้งใจจะใช้สนับสนุน · ผลลัพธ์: ตัดออก—ข้อมูลที่ดึงมามีแค่ navigation/CSS ไม่มีเนื้อหาหลัก
- แหล่งข้อมูล: Project Brief / Research Notes / Original Brief · บทบาท: ข้อกล่าวอ้าง สิ่งที่ต้องห้าม กลุ่มผู้ชม · ผลลัพธ์: เก็บไว้ การตั้งค่าเริ่มต้นเป็นภาษาจีน แต่ล็อกภาษาที่ใช้ส่งมอบเป็นภาษาอังกฤษก่อนสร้างสไลด์
สามคำถามก่อนเริ่มสร้าง (การตัดสินใจ #0)
เขียนสิ่งเหล่านี้ลงมาก่อน การตัดต่อทุกอย่างหลังจากนี้จะยึดตามนี้
- ผู้ชมต้องตัดสินใจเรื่องอะไร? อนุมัติโครงการนำร่องระยะสี่สัปดาห์สองโครงการ—รวมถึงกฎการหยุด—ก่อนที่ใครจะเริ่มลงมือ
- เรากำลังปกป้องข้อกล่าวอ้างอะไร? ข้อมูลการใช้งานคือเหตุผลในการทำทดสอบขนาดเล็ก ไม่ใช่การพยากรณ์ว่าจะประหยัดได้เท่าไร ทั้งสองเวิร์กโฟลว์เป็นเพียงข้อเสนอ ยังไม่มีอะไรถูกวัดผลจริง
- อะไรคือสิ่งที่ห้ามทำ? กุเรื่องลูกค้า จำนวนคน งบประมาณ หรือประสิทธิภาพที่เพิ่มขึ้นขึ้นมา นำผู้ใช้ของผลิตภัณฑ์หนึ่งไปเหมารวมทั้งอุตสาหกรรม ตัวเลขใด ๆ ที่ไม่มีแหล่งข้อมูล ประชากร และตัวส่วน
อีกหนึ่งการตัดสินใจในรอบนี้: โน้ตงานเดิมและโครงร่างเบื้องต้นเป็นภาษาจีน ก่อนสร้างสไลด์ ภาษาที่ใช้ส่งมอบถูกล็อกเป็น ภาษาอังกฤษ แล้ว Project Brief ฉบับภาษาอังกฤษจึงมีผลเหนือกว่าโน้ตก่อนหน้านี้
จากแหล่งข้อมูลสู่โครงร่าง: อะไรอยู่ อะไรถูกโยนทิ้ง
การเอา PDF หน้าเว็บ และโน้ตมารวมไว้ใน Board เดียวกันนั้นเป็นเรื่องง่าย ส่วนที่กินเวลาคือโครงร่าง—อยู่ที่ การคัดเลือก ไม่ใช่การจัดวาง
สิ่งที่ตัดทิ้ง (ตั้งใจทิ้ง พร้อมบันทึกไว้)
- บท Economy ของ Stanford: เนื้อหาหลักอ่านไม่ได้ → ตัดออกจากข้อโต้แย้ง และติดป้ายว่าเป็นข้อจำกัดของการนำเข้าทั้งบนสไลด์และใน Research Notes ไม่มีการเดาสุ่ม
- เปอร์เซ็นต์อีกสิบกว่าตัวที่ “มีอยู่แต่ไม่จำเป็น” (สัดส่วนผลลัพธ์ ผลประโยชน์ที่รายงานด้วยตัวเอง การเปรียบเทียบค่าจ้าง ฯลฯ) → ลบออกเพื่อไม่ให้สไลด์กลายเป็นพิพิธภัณฑ์สถิติ
- ช่วงเวลาเก็บข้อมูลสำรวจที่ระบุเป๊ะ ๆ → โน้ตแหล่งข้อมูลขัดแย้งกันเอง สไลด์จึงระบุแค่ “2026 survey”
- การจัดกรอบ Pilot 1 เป็นการ “มอบหมายงาน” แบบไม่ต้องตรวจทาน และ Pilot 2 เป็นการเขียนบทความต้นฉบับใหม่เป็น “ร่างที่สอง” → แก้ไขแล้ว: โครงการนำร่อง ทั้งสอง ต้องผ่านการตรวจทานจากบรรณาธิการ Pilot 2 เริ่มจาก ข้อความที่อนุมัติแล้ว และไม่เขียนบทความต้นทางใหม่เด็ดขาด
- การระบุว่า 49% คือ “ของบทสนทนาทั้งหมด” → แก้ไขตามหมายเหตุของตัวเลข: เป็นสัดส่วนของ เป้าหมายผู้ใช้ที่ถูกจัดหมวดหมู่แล้ว (Microsoft WTI, p.08 ฉบับพิมพ์)—ไม่ใช่เวลา ไม่ใช่จำนวนเซสชัน
มีเพียงสองข้อเท็จจริงที่รอดมาอยู่บนสไลด์
- F1: ในบทสนทนา Copilot ที่สุ่มตัวอย่างมา 49% ของเป้าหมายผู้ใช้ที่ถูกจัดหมวดหมู่แล้วสนับสนุนงานด้านความคิด (การวิเคราะห์ การแก้ปัญหา การประเมิน ความคิดสร้างสรรค์ และที่เกี่ยวข้อง) แหล่งข้อมูล: Microsoft 2026 Work Trend Index, p.08 ตัวส่วน: เป้าหมายผู้ใช้ที่ถูกจัดหมวดหมู่แล้ว
- F2: ในบทสนทนา Claude ที่ถูกจัดว่าเกี่ยวข้องกับงาน เอกสารและรายงานเป็นสิ่งประดิษฐ์ (artifact) ที่พบมากที่สุดที่ประมาณ 20% แหล่งข้อมูล: Anthropic Cadences, บทที่ 2 ตัวส่วน: บทสนทนาที่ถูกจัดว่าเกี่ยวกับงาน
ตัวส่วนที่ต่างกันต้องอยู่บนแผงที่แยกกัน เราไม่เคยนำมารวมกันเป็นข้อกล่าวอ้างเรื่องการประหยัด
เกณฑ์ผ่านของโครงร่าง: หนึ่งข้อกล่าวอ้างต่อหนึ่งสไลด์ ติดธงจุดที่ขาดหลักฐาน จำกัดไว้ที่แปดสไลด์สำหรับการพูดสิบนาที
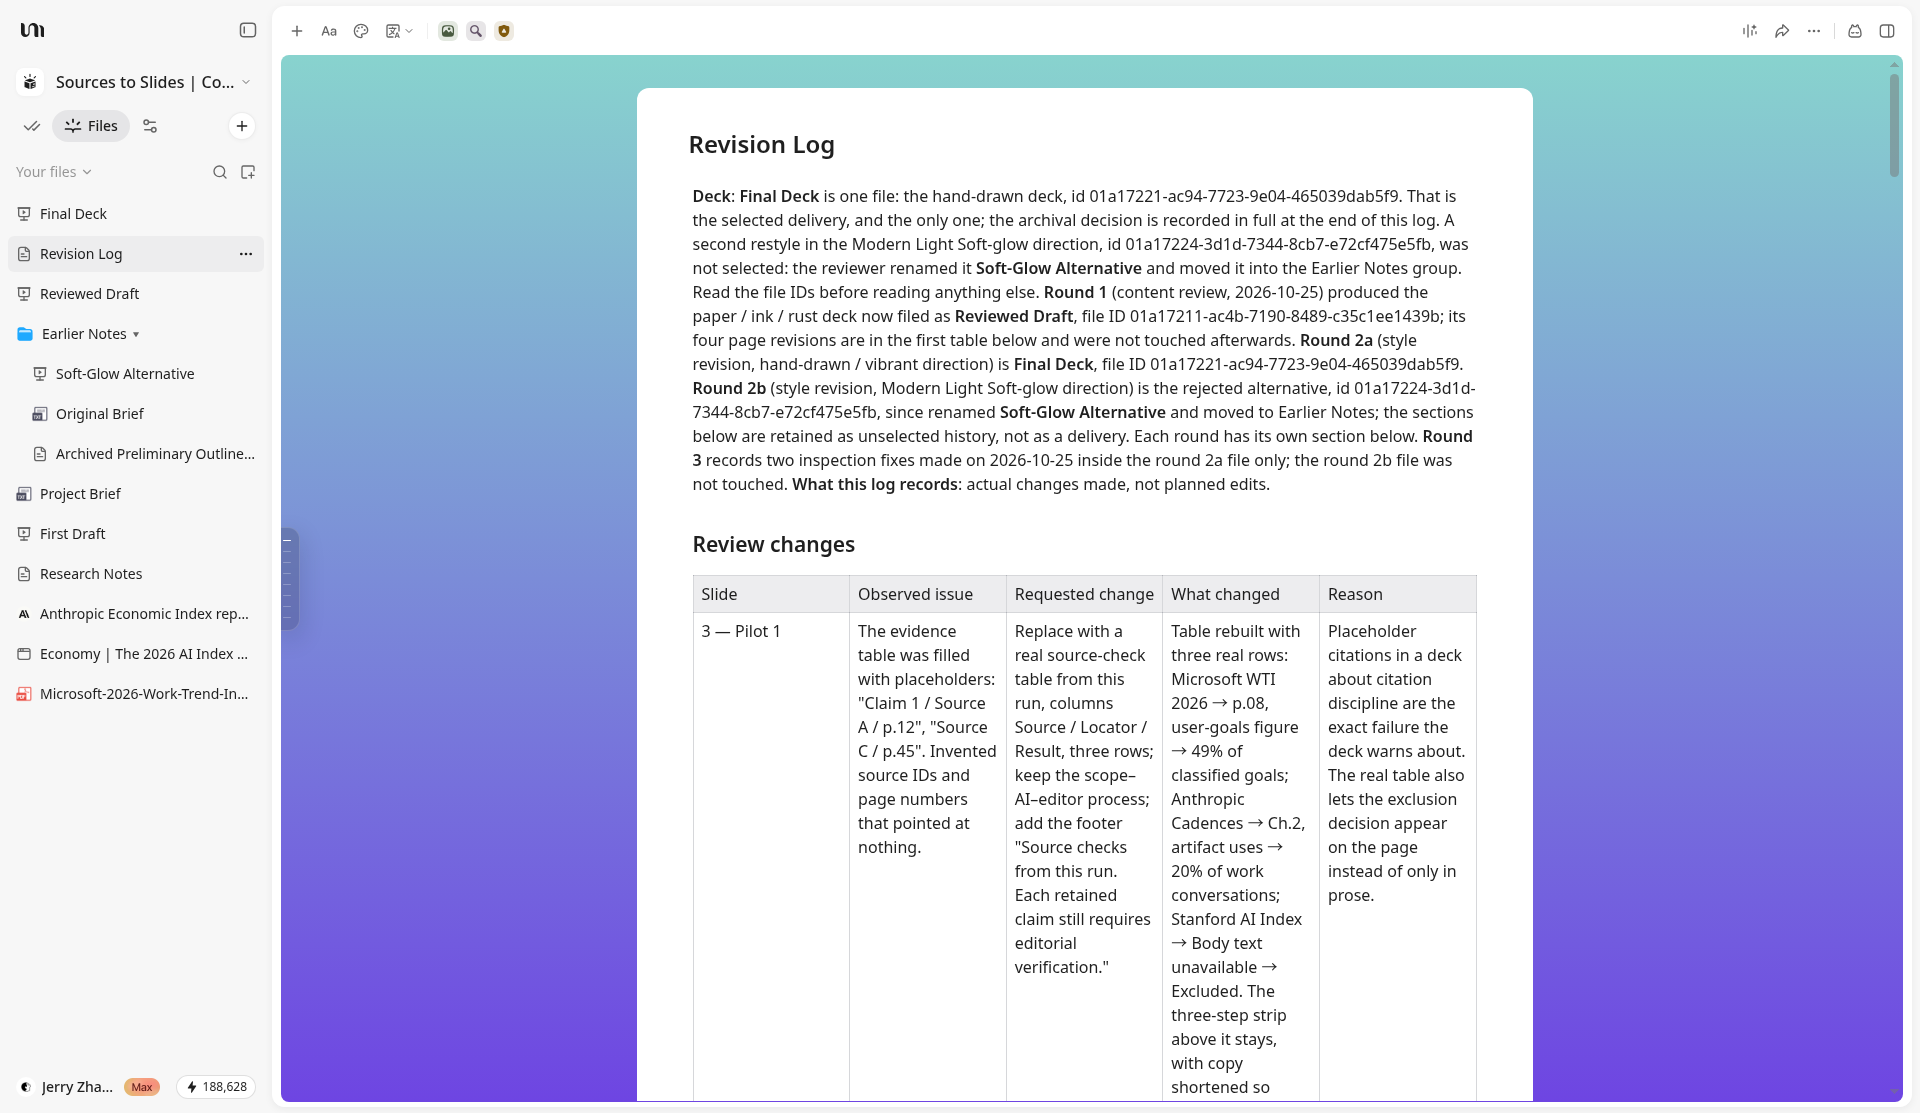
เคสนี้สร้างสไลด์ขึ้นมาจริง ๆ อย่างไร
- ขั้น: ร่างแรก · สิ่งที่เราทำ: การสนทนาใน Board ชื่อ “Build the Content Team Pilot Deck” (ไม่ใช่ Skill แยกชื่อ “Architect PRO”—อย่าใส่ชื่อนั้นตรงนี้)
- ขั้น: ปรับแก้เนื้อหา · สิ่งที่เราทำ: รอบ 1 → Reviewed Draft (แก้ไขเนื้อหาระดับหน้า)
- ขั้น: ภาพสุดท้าย · สิ่งที่เราทำ: ปรับสไตล์ใหม่ทั้งหมดด้วย Vibrant handdrawn for young professional Skill (v1) → Final Deck
- ขั้น: ทางเลือกที่ถูกปฏิเสธ · สิ่งที่เราทำ: Modern Light Soft-glow Skill (v9) → เปลี่ยนชื่อเป็น Soft-Glow Alternative ย้ายไปที่ Earlier Notes
หากคุณยังต้องเลือกสไตล์หรือ Skill สำหรับงานอื่น ให้ใช้ คอลเลกชัน Skills และ แกลเลอรี Skills Scheduled Tasks และ “Board เดิม รูปแบบอื่น” จะถูกกล่าวถึงอย่างมากแค่ประโยคเดียวในบทความนี้—เพราะมันไม่ใช่แกนหลัก
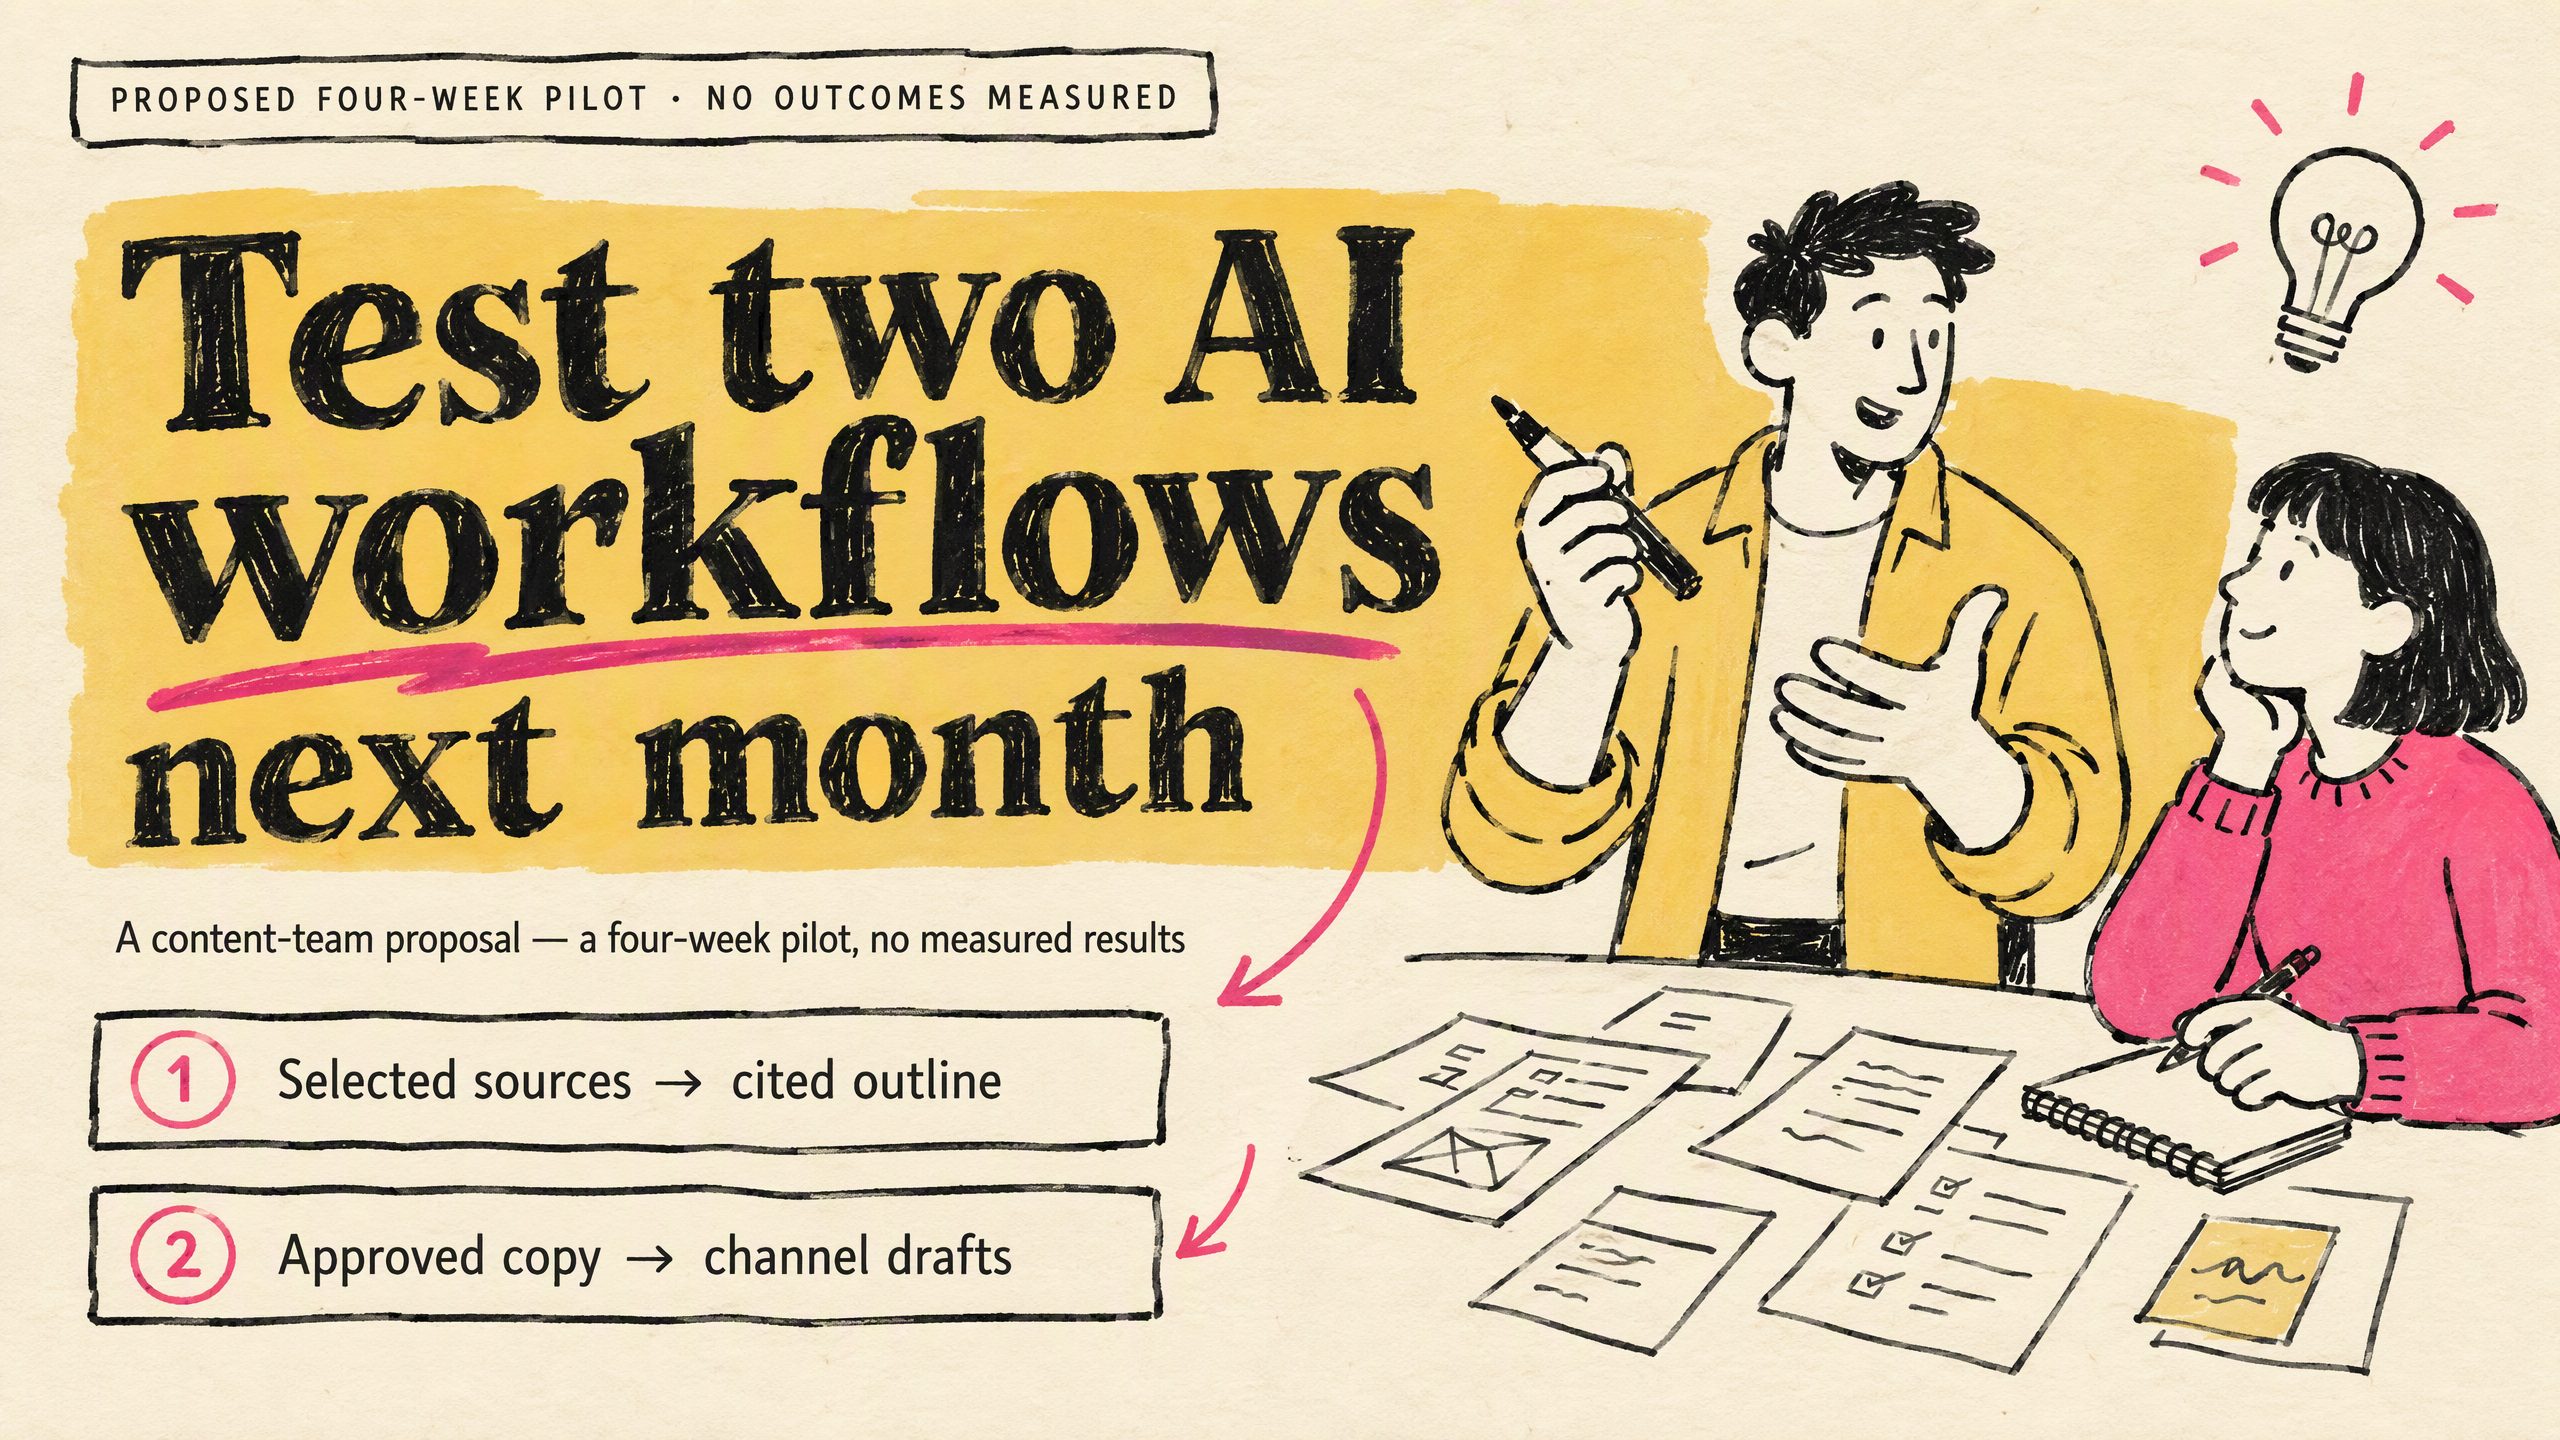
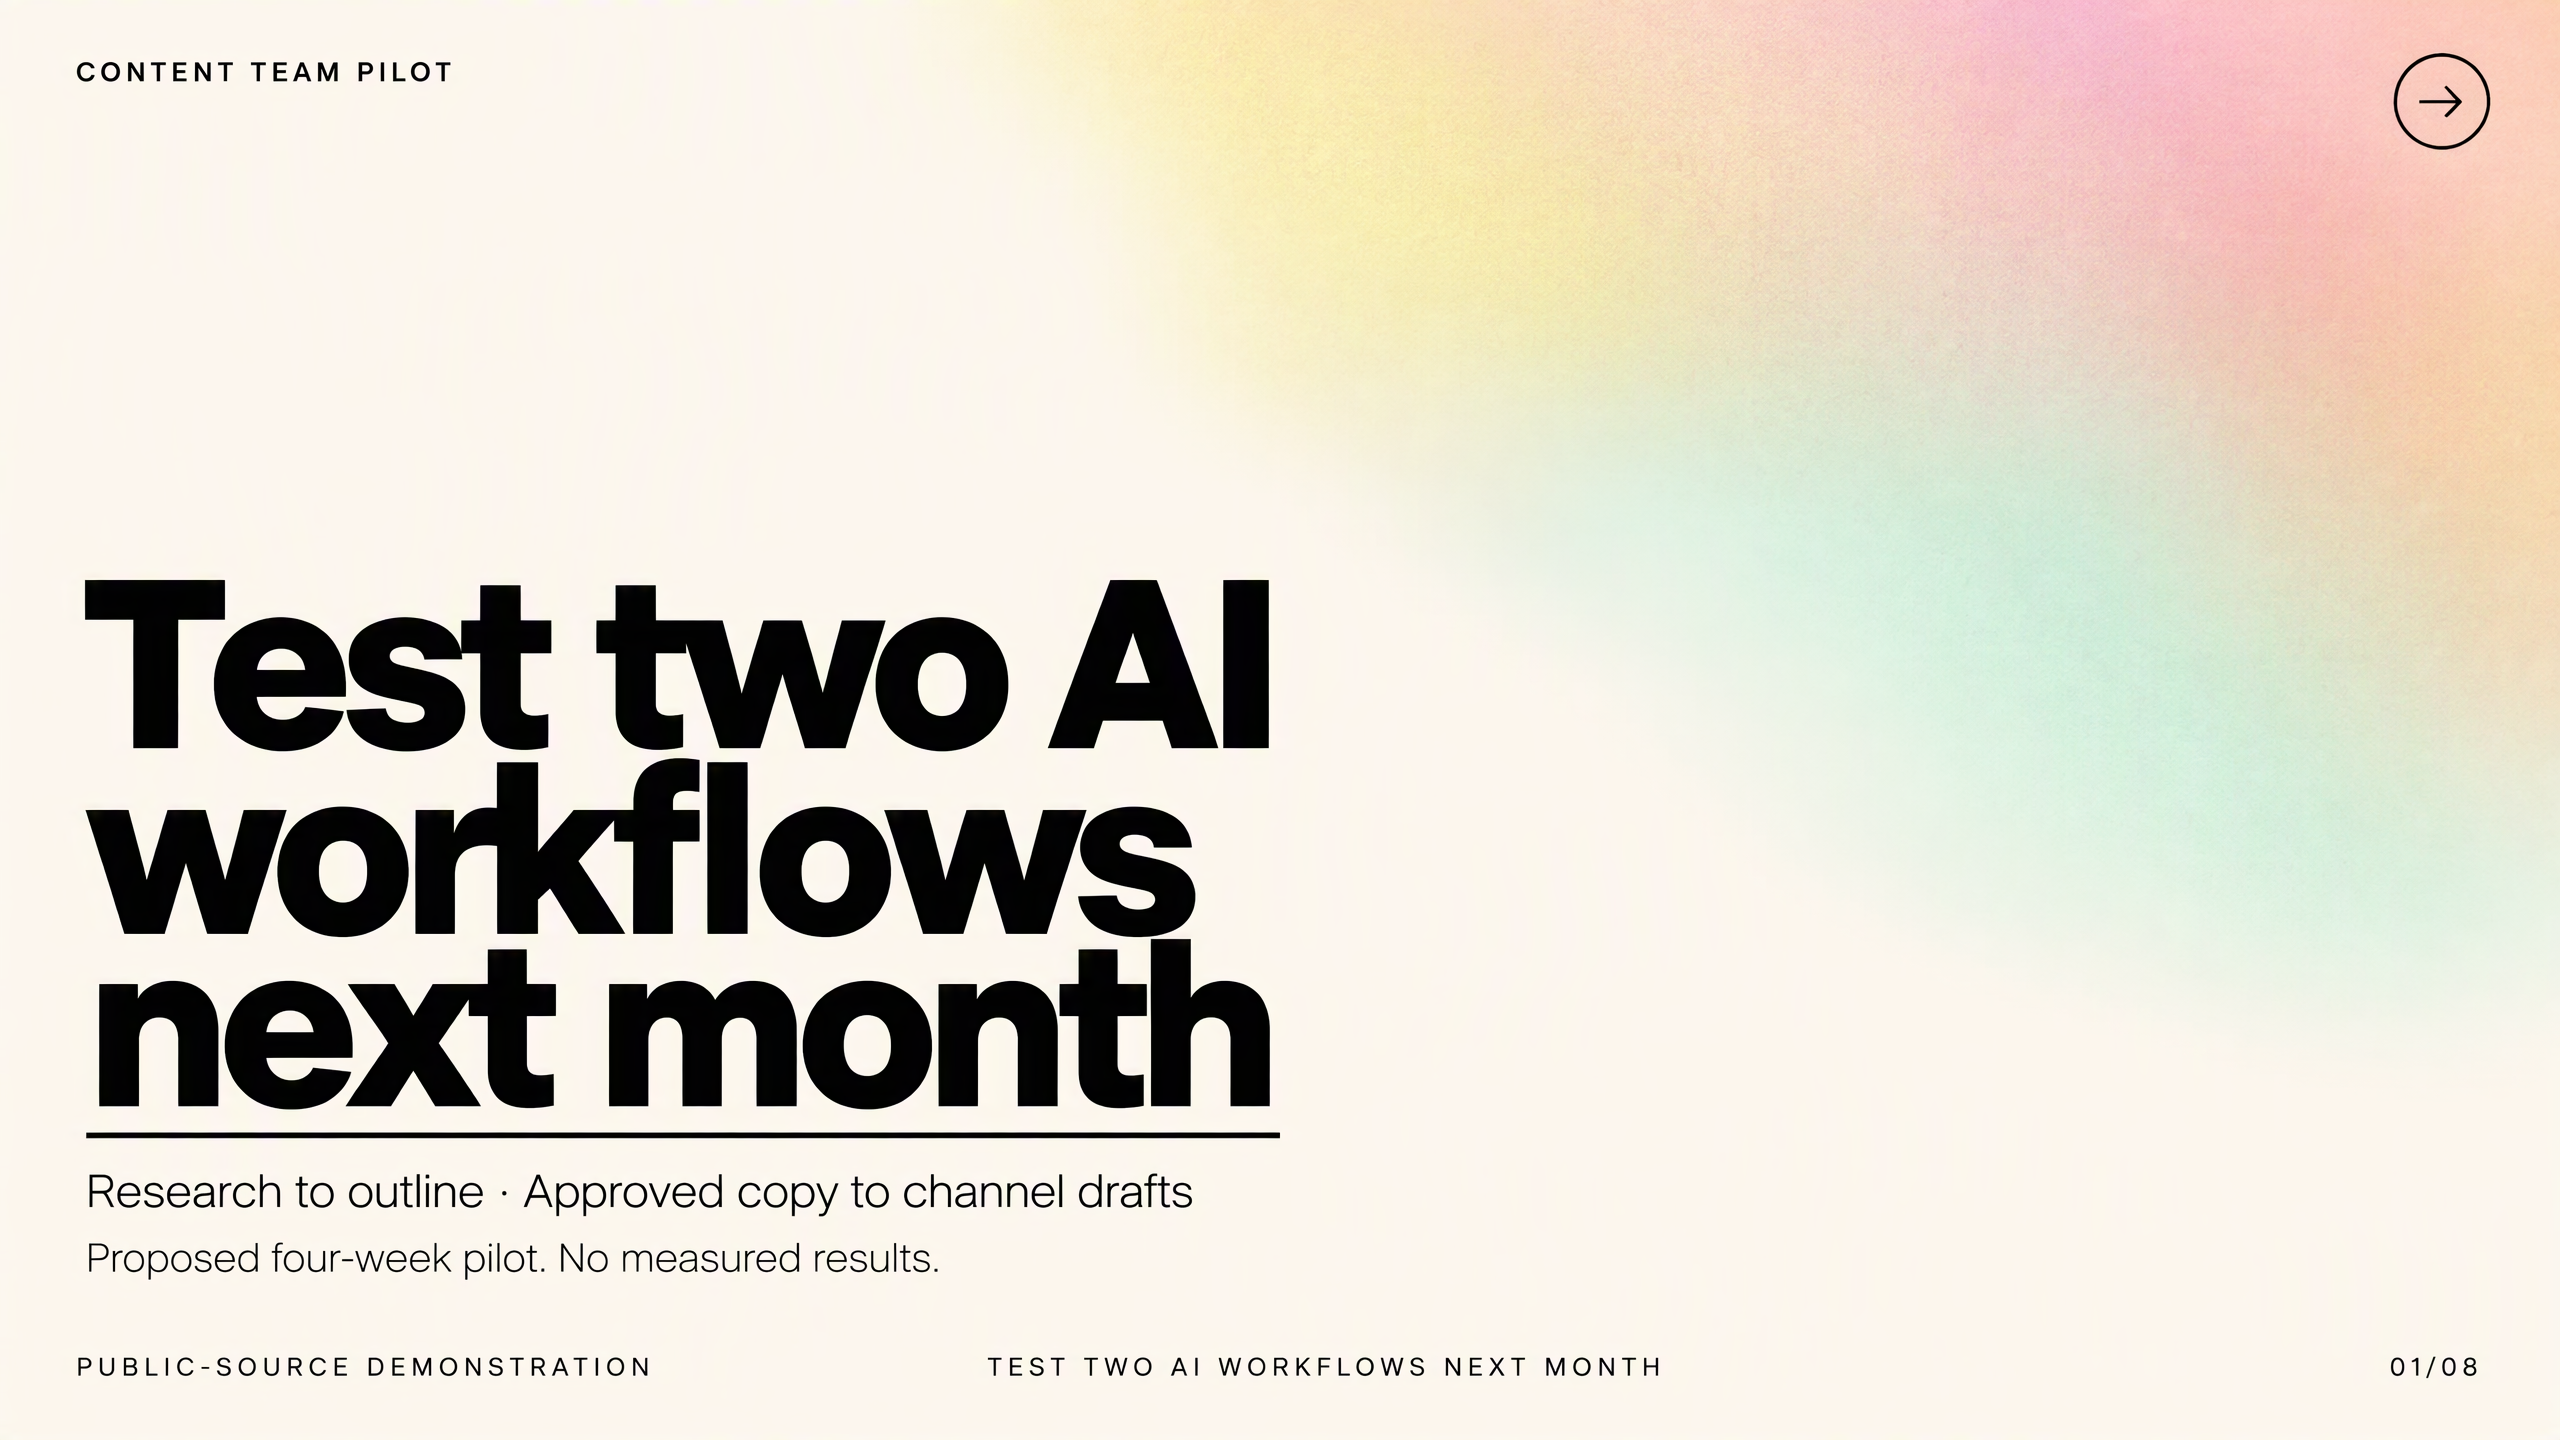
ร่างแรกหน้าตาเป็นอย่างไร
First Draft มีโครงสร้างหลักภาษาอังกฤษครบแปดหน้าแล้ว—แต่ก็ยังส่งมอบไม่ได้
- หน้าปกและหน้าคำแนะนำดูค่อนข้างสะอาด
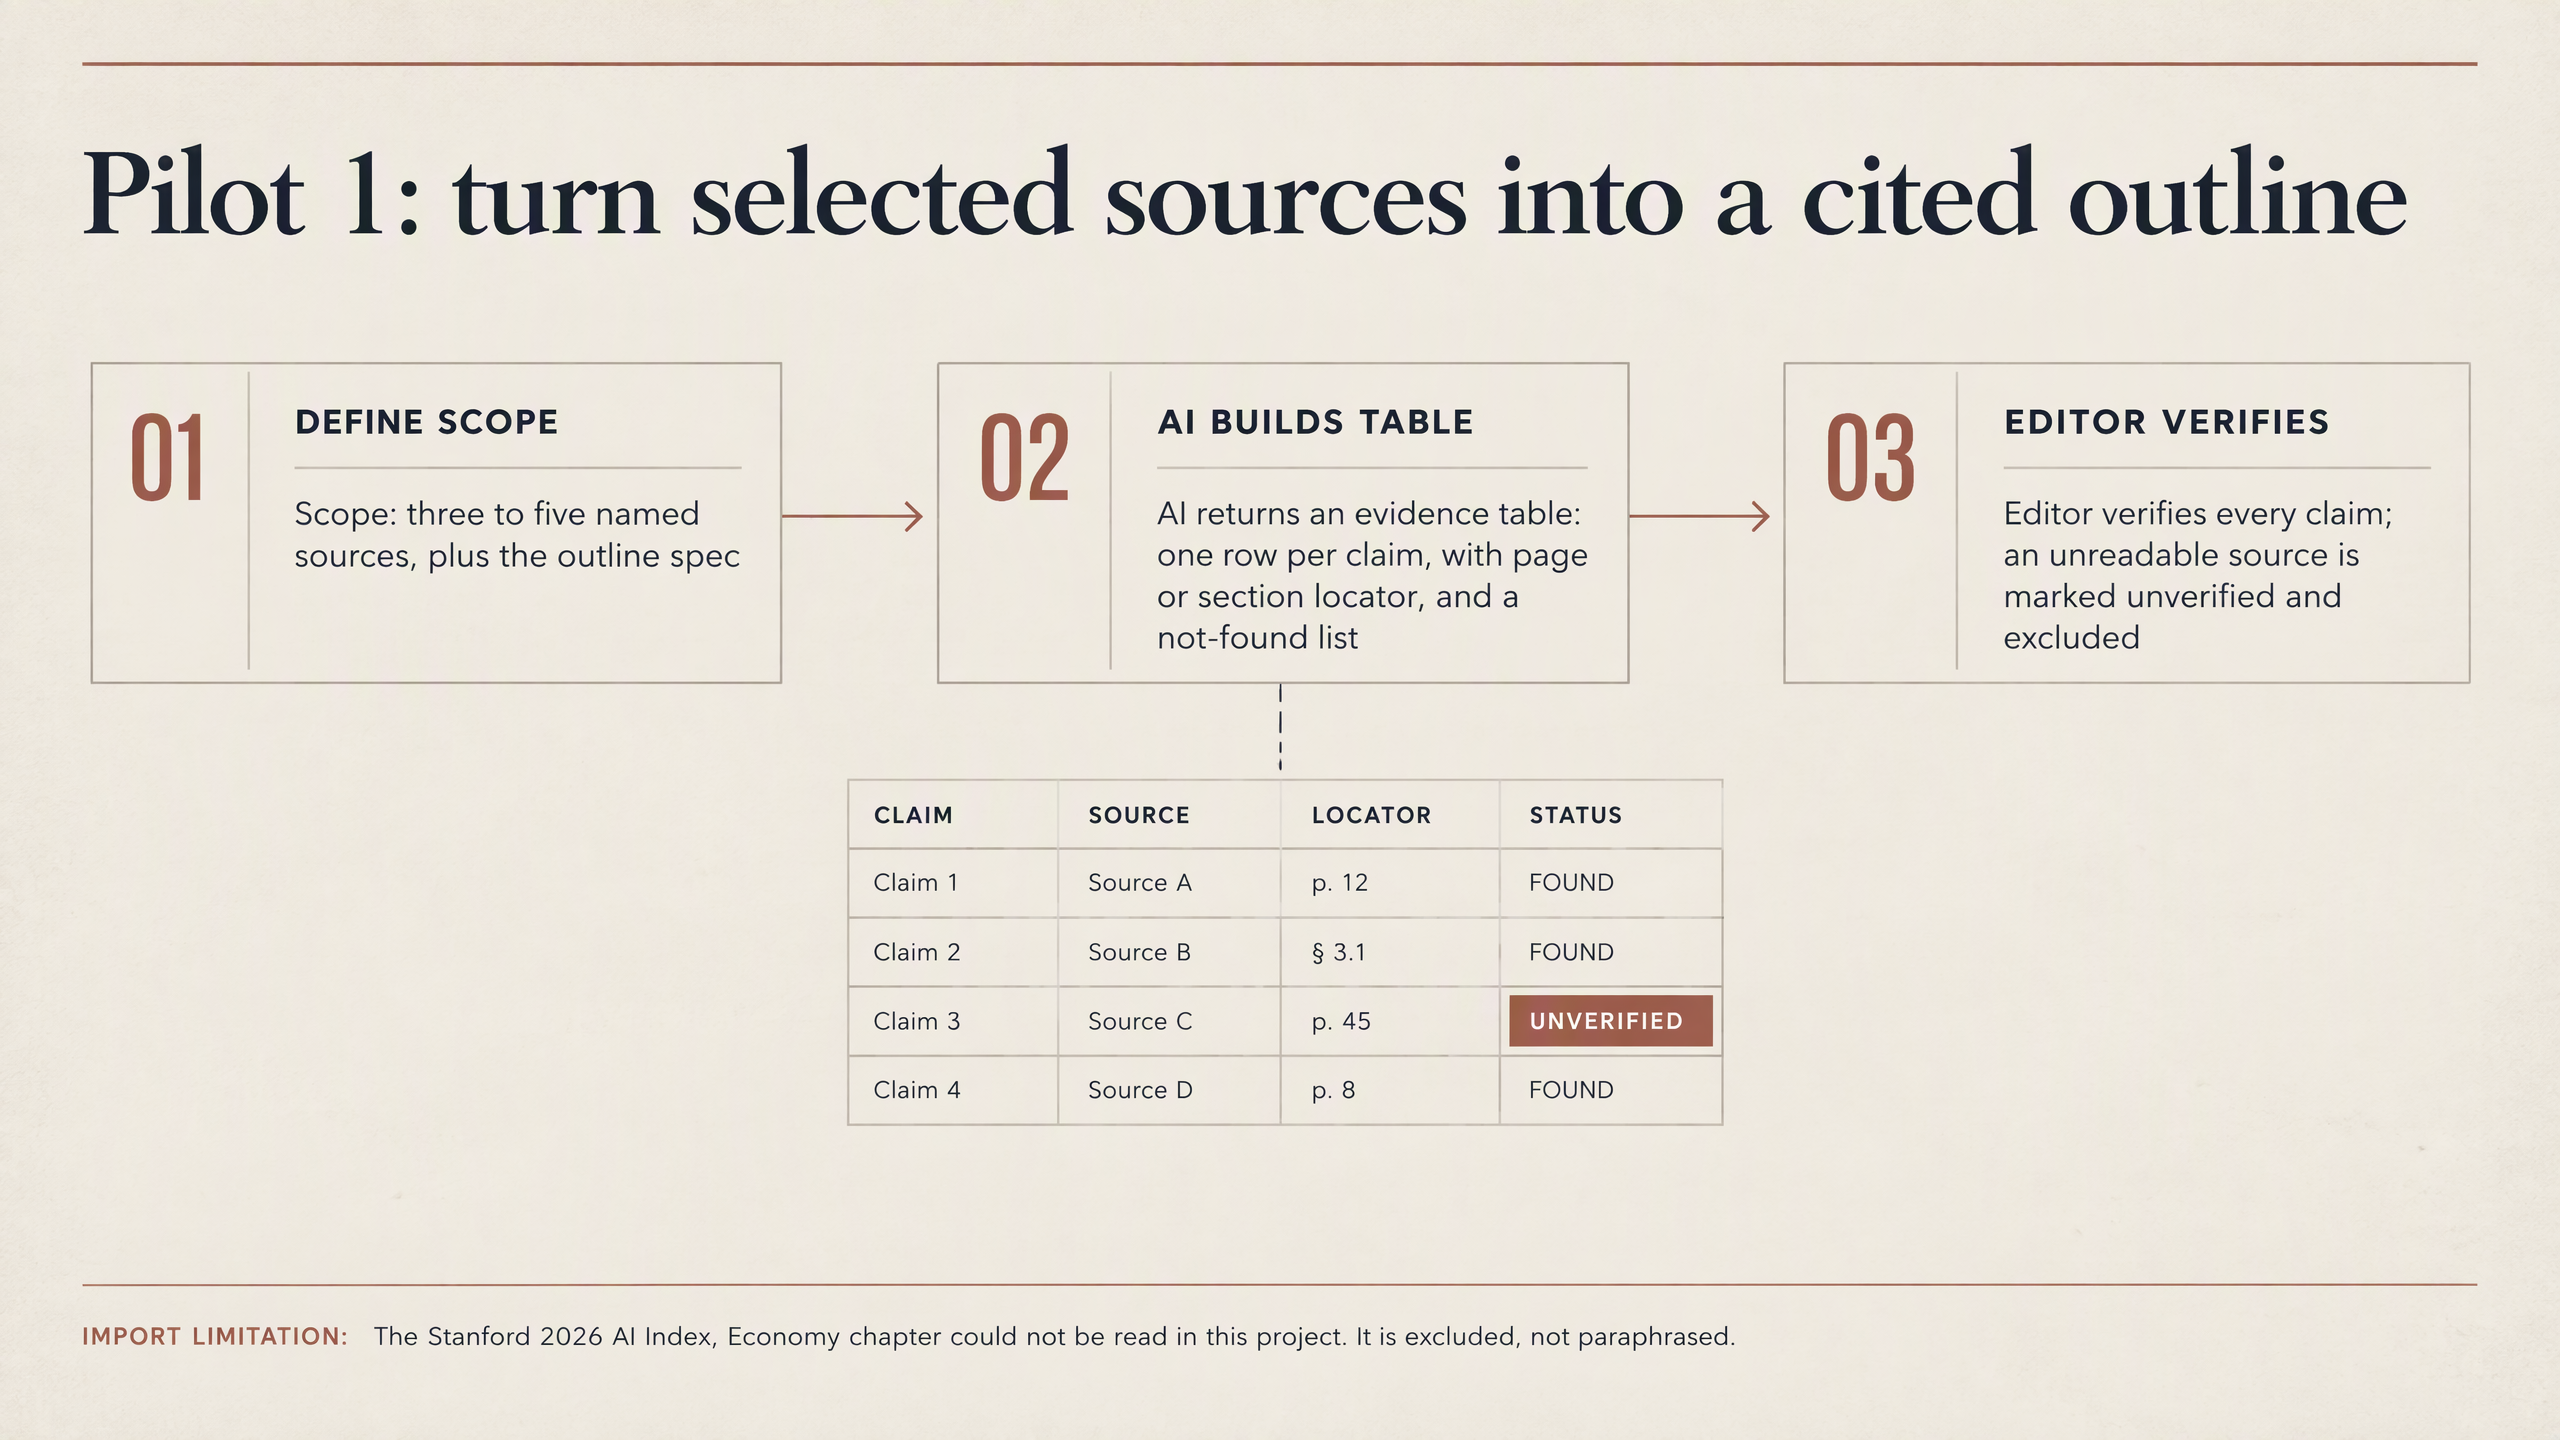
- หน้าที่มีปัญหาถูกฝังมาแล้ว: ตารางหลักฐานของ Pilot 1 แสดง placeholder อย่าง “Claim 1 / Source A / p.12” Pilot 2 ใช้การ์ด CHANNEL A/B/C ที่จริง ๆ แล้วระบุขั้นตอนกระบวนการ หน้า failure-modes ขาดหัวตารางและทำซ้ำประโยคเดิมในช่อง warning กับ check
การปรับโทนเสียงช่วยเรื่องนี้ไม่ได้ คุณต้องแก้โดยเทียบกับแหล่งข้อมูล ทุกอย่างด้านล่างมาจาก Revision Log ของ Board—เป็นการแก้ไขจริง ไม่ใช่รายการแนวปฏิบัติที่ดีที่แต่งเติมทีหลัง
เช็กลิสต์การแก้ไข (หัวใจของบทความนี้)
1. การทิ้งแหล่งข้อมูล: ข้อมูลที่ดึงมาว่างเปล่าก็ต้องอยู่บนสไลด์
Stanford ไม่ได้ถูกตัดทิ้งแค่ในโน้ต แถบตรวจสอบแหล่งข้อมูลของสไลด์ชุดสุดท้ายระบุว่า body unavailable → Excluded ในเวิร์กโฟลว์การอ้างอิง ผลลัพธ์ที่ซื่อสัตย์มักจะเป็น “unverified” ไม่ใช่หน้าที่กุขึ้นมา
มีการทิ้งครั้งที่สองในเรื่อง สไตล์: การปรับสไตล์ใหม่แบบ Soft-Glow ถูกสร้างออกมาเต็มรูปแบบและ ไม่ถูกเลือก บันทึกแสดงให้เห็น HTTP 404 สองครั้งเมื่อพยายามยกเลิก งานจึงรันต่อไป—นั่นคือ การยกเลิกที่ล้มเหลว ไม่ใช่การทดสอบ A/B อย่างใจเย็น อย่าเขียนใหม่ให้เป็นเจตนาส่งมอบสองแบบ
2. การเขียนโครงสร้างใหม่: ขอบเขตของ Pilot 2
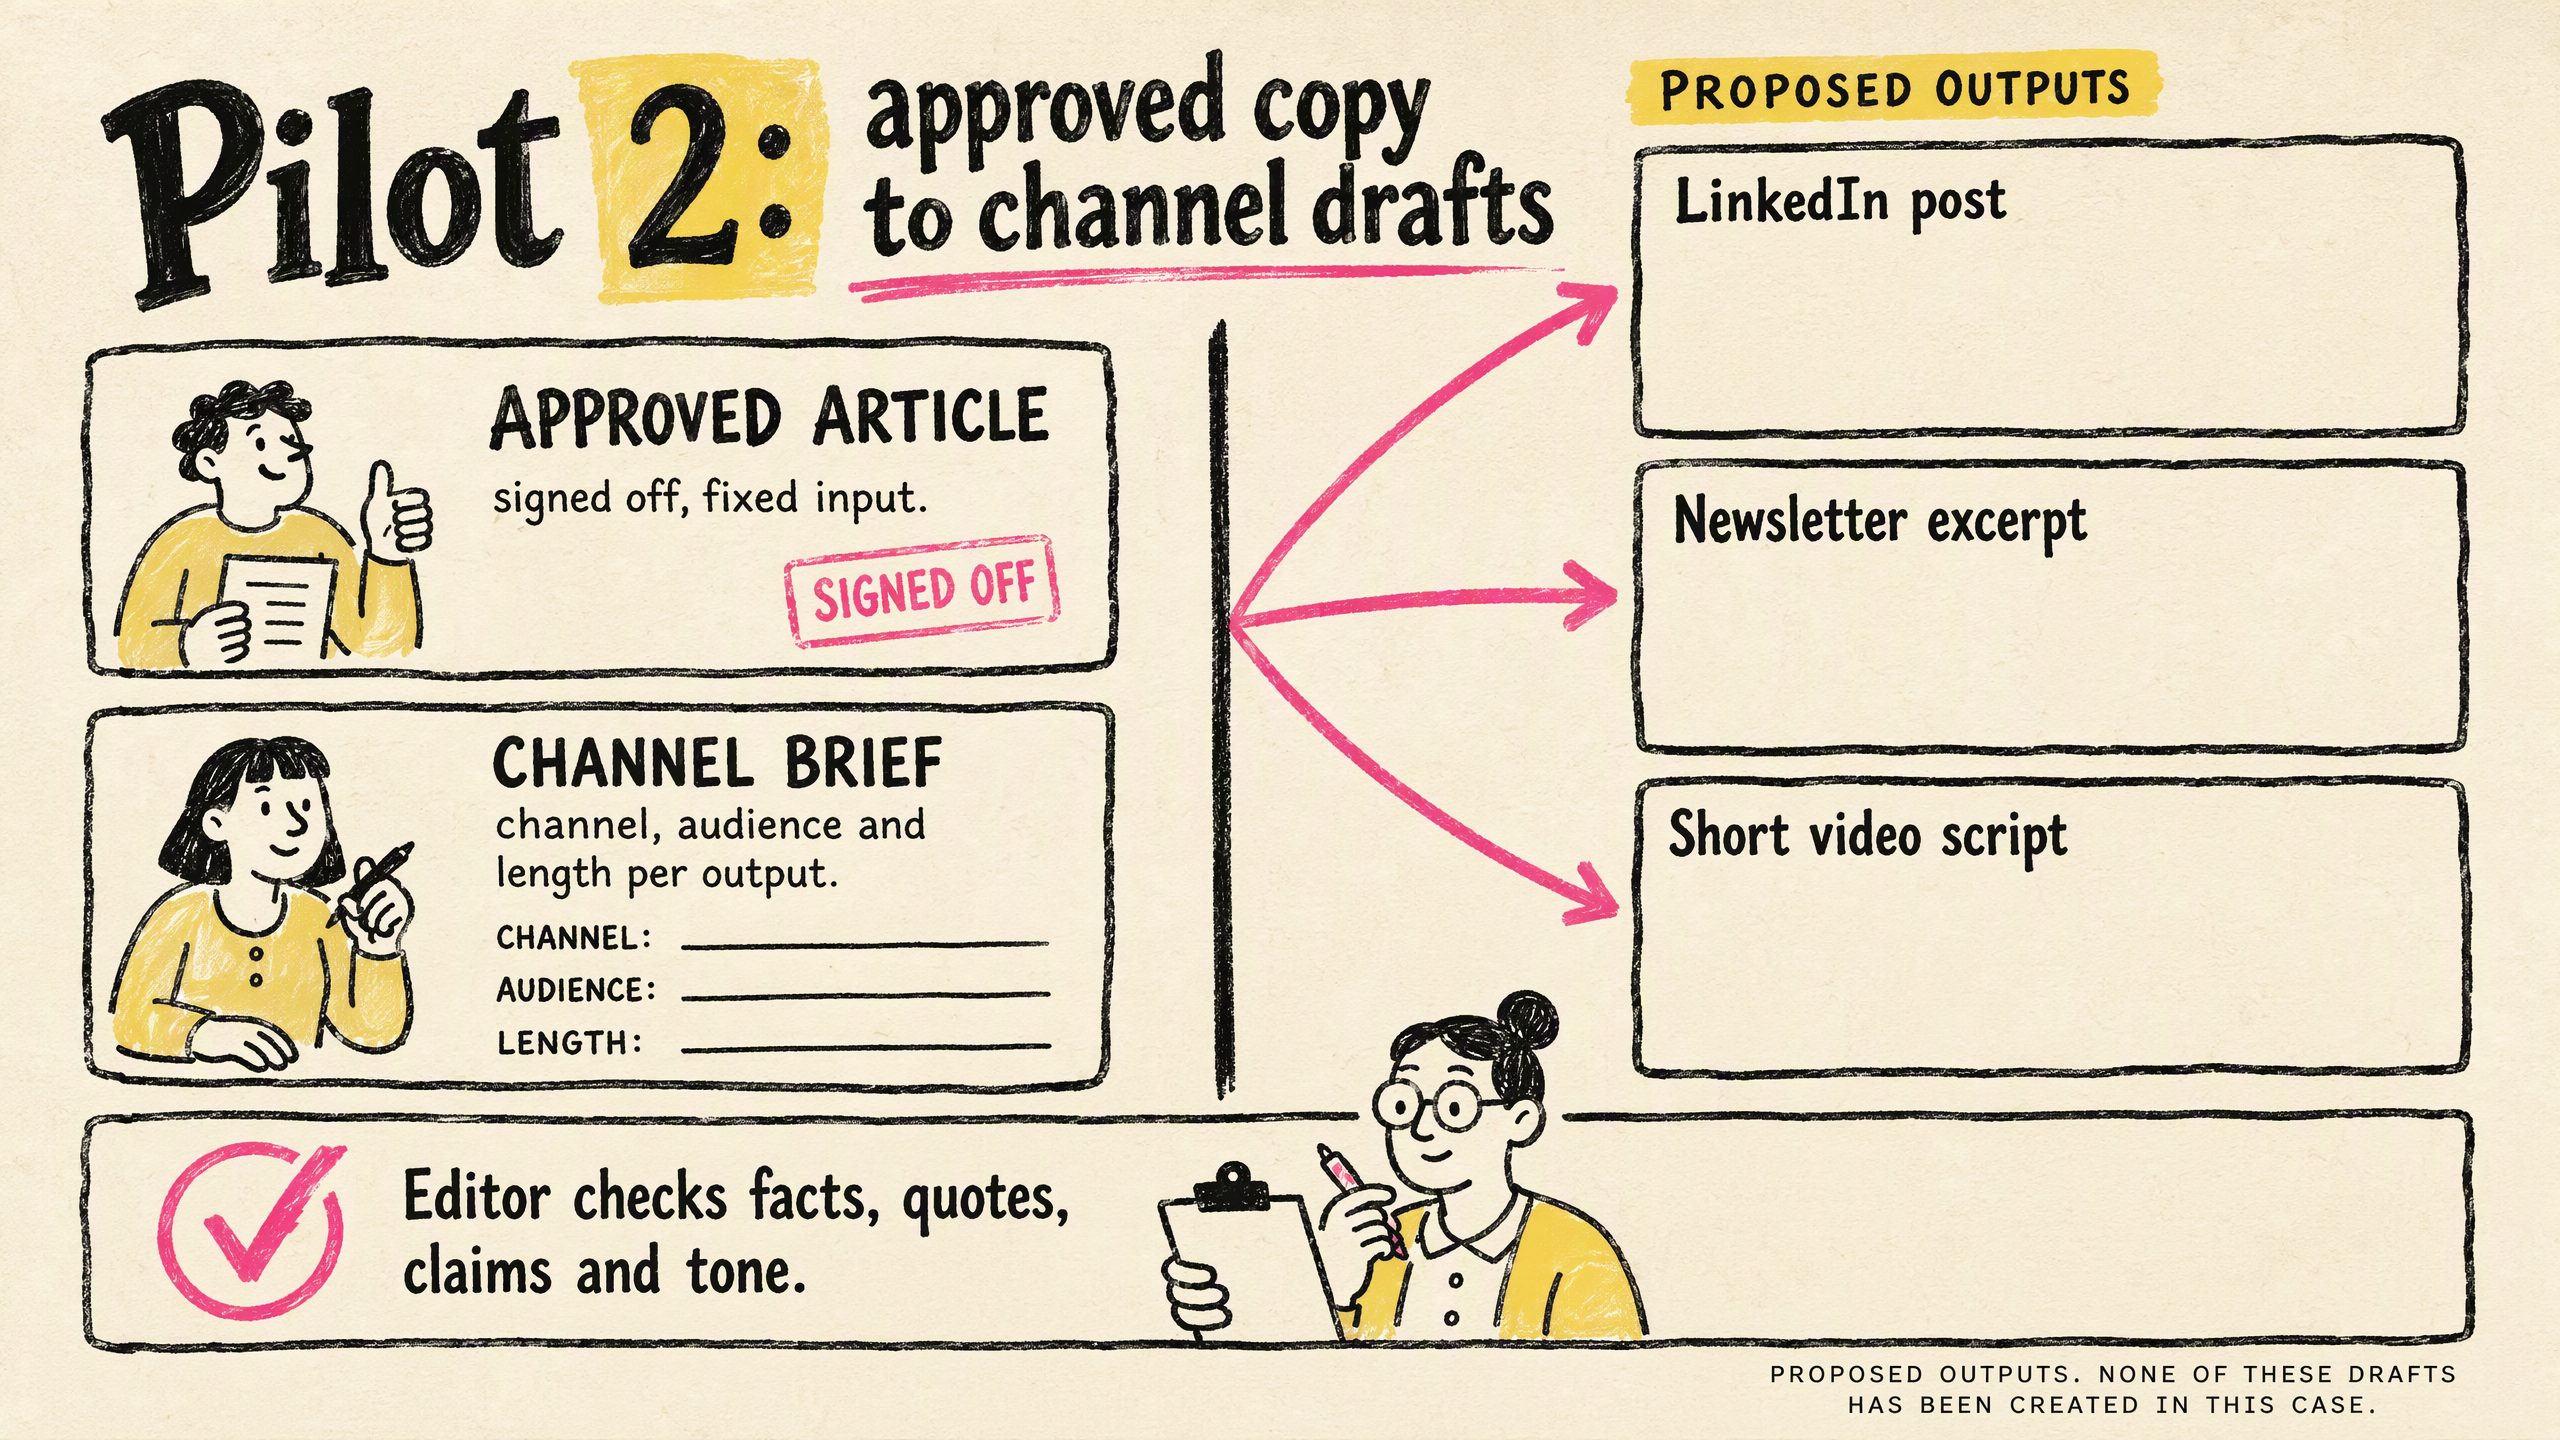
- ปัญหา · ก่อน: การ์ด CHANNEL A/B/C บรรจุขั้นตอน ในขณะที่ไดอะแกรมเขียนว่า “channel” · หลัง: ซ้าย: บทความที่อนุมัติแล้ว + brief ของช่องทาง; ขวา: ผลลัพธ์ที่เสนอสามรายการซึ่ง ตั้งชื่อไว้และว่างเปล่า (LinkedIn, จดหมายข่าว, วิดีโอสั้น); แถบตรวจทานร่วมกันหนึ่งแถบ
- เหตุผล · ก่อน: ในเคสนี้ยังไม่มีร่างของช่องทางใด ๆ · หลัง: ส่วนท้าย: ผลลัพธ์ที่เสนอไว้ ไม่ได้สร้างอะไรขึ้นที่นี่
- รอบที่สอง · ก่อน: ข้อความคำสั่ง (“Left:…”, “Right:…”) หลุดเข้าไปในตัวการ์ด · หลัง: ถูกลบออกเมื่อสร้างใหม่
ข้อกล่าวอ้างถูกล็อก: ข้อความที่อนุมัติแล้วคือขอบเขต AI ไม่ได้แก้ไขต้นฉบับ
3. การตรวจสอบตัวเลขและการอ้างอิง: placeholder → ตารางแหล่งข้อมูลจริง
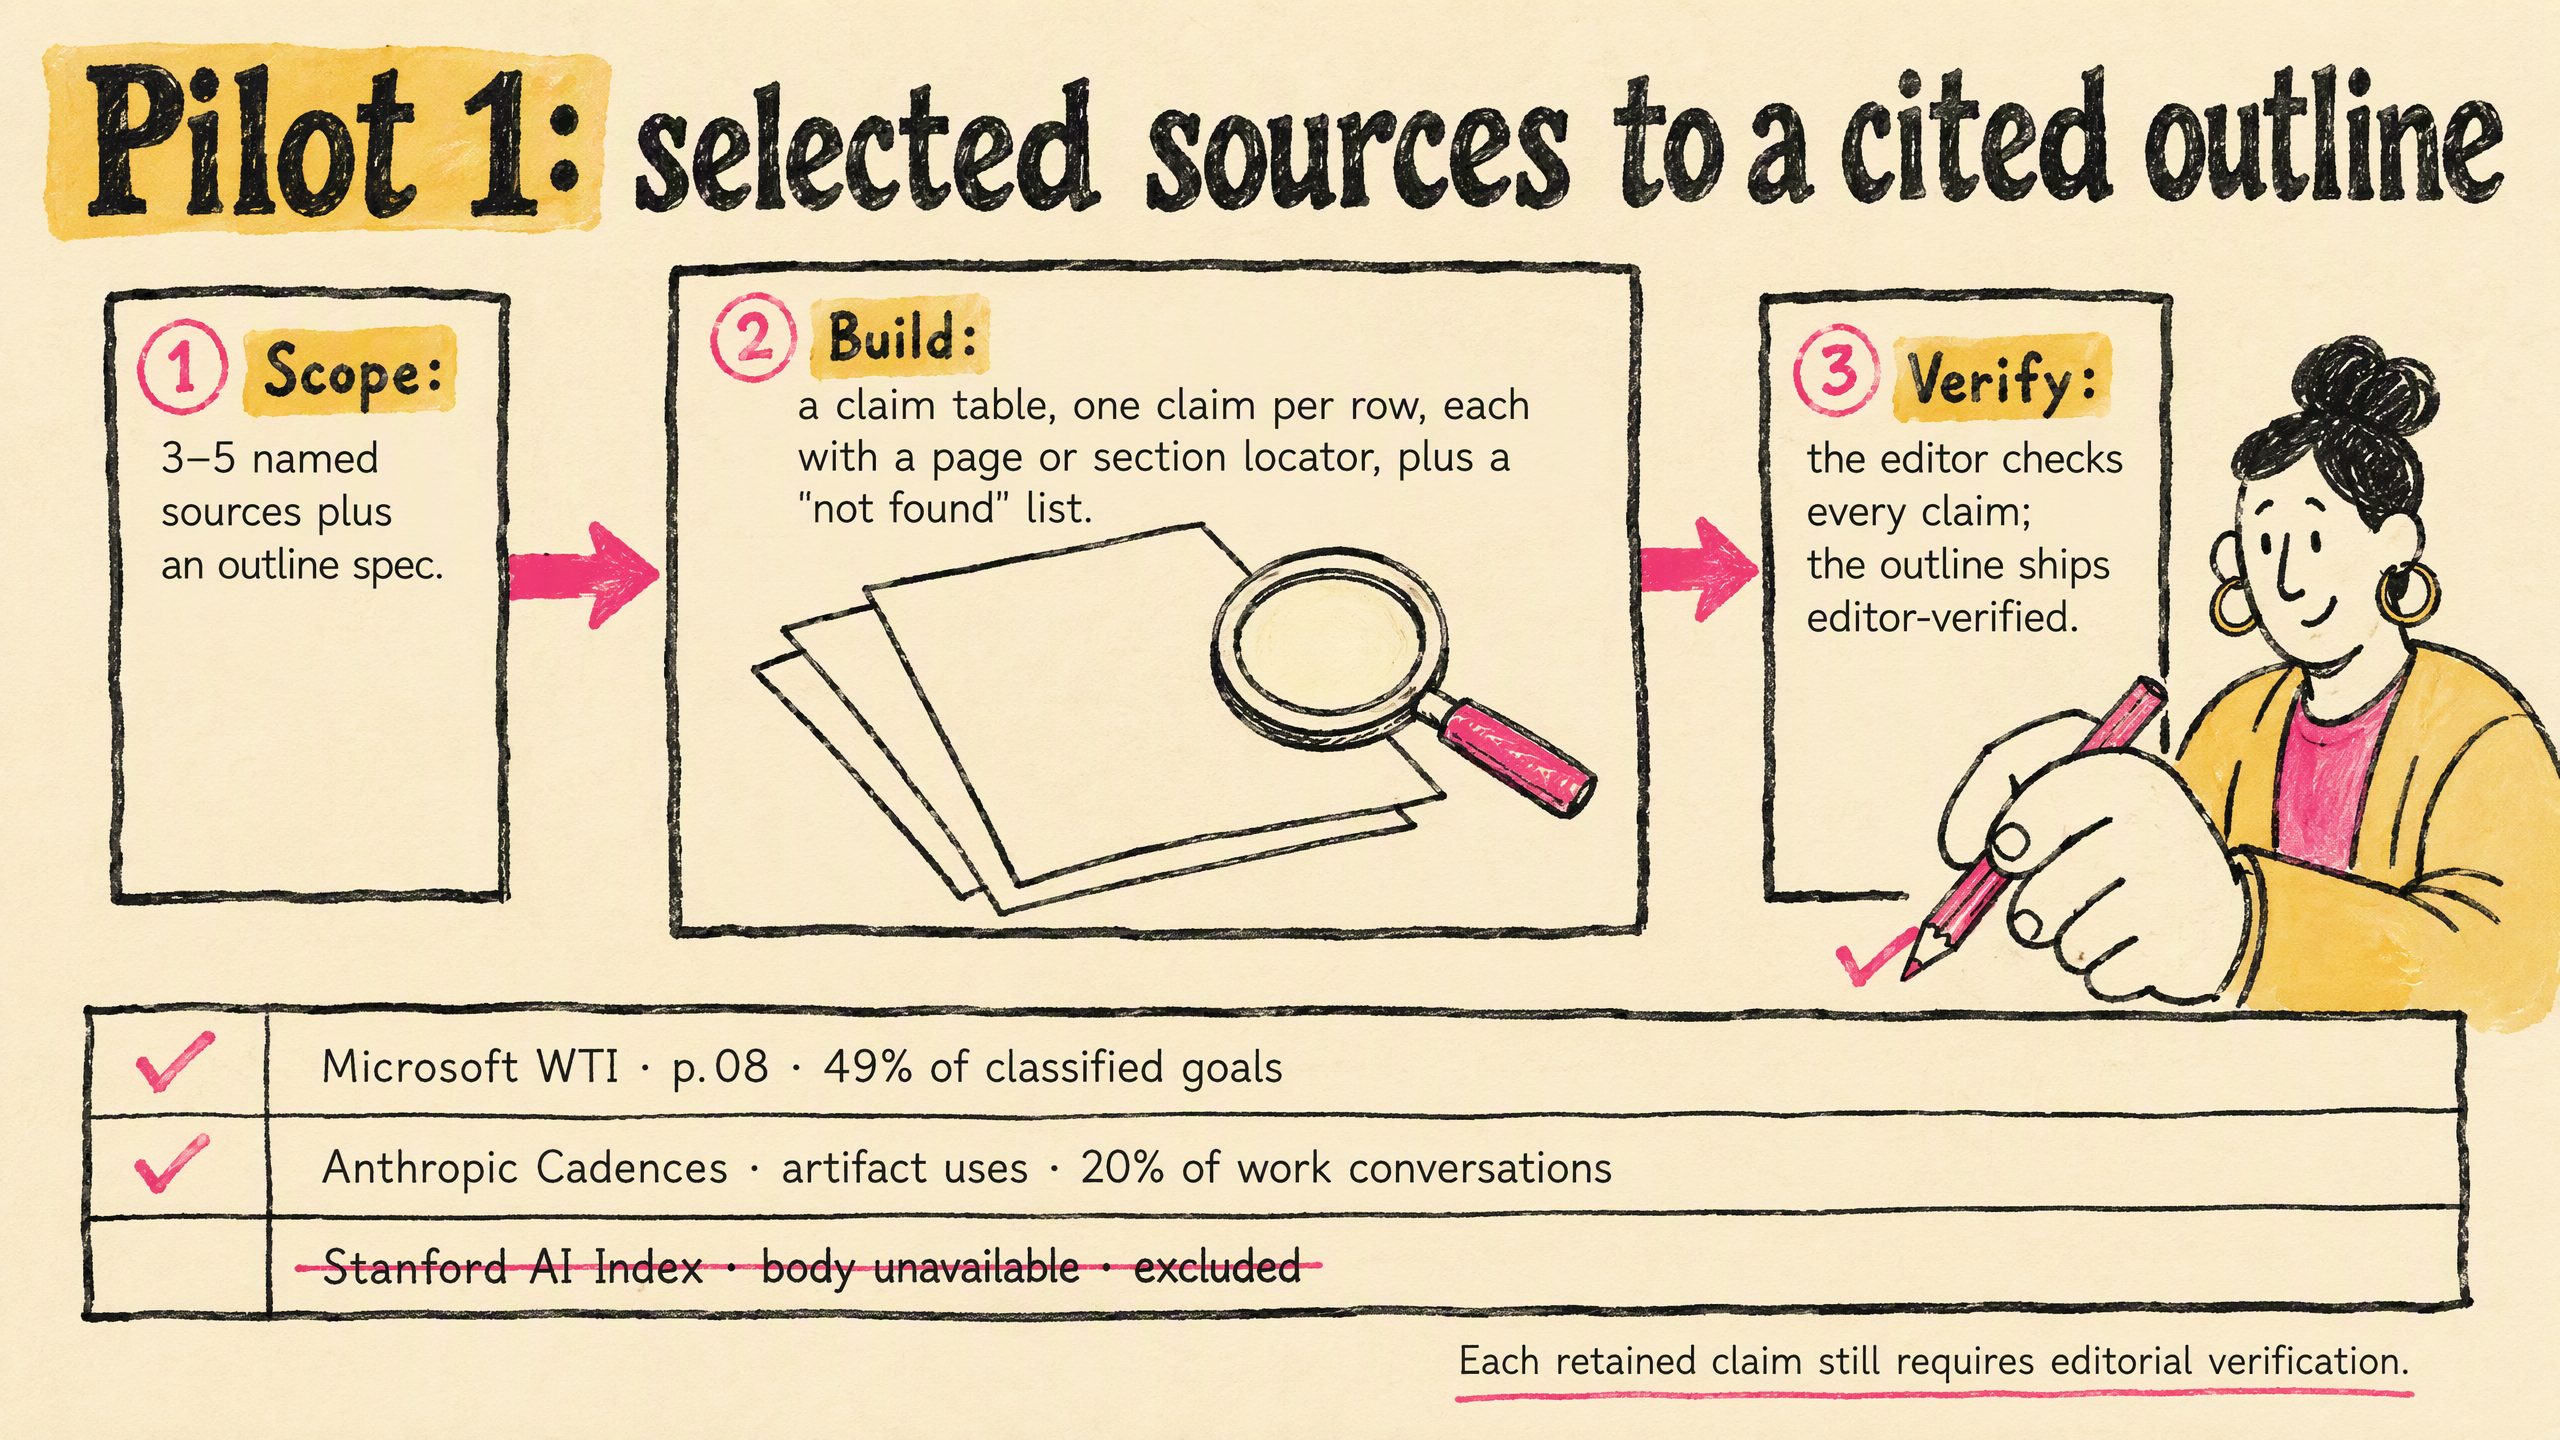
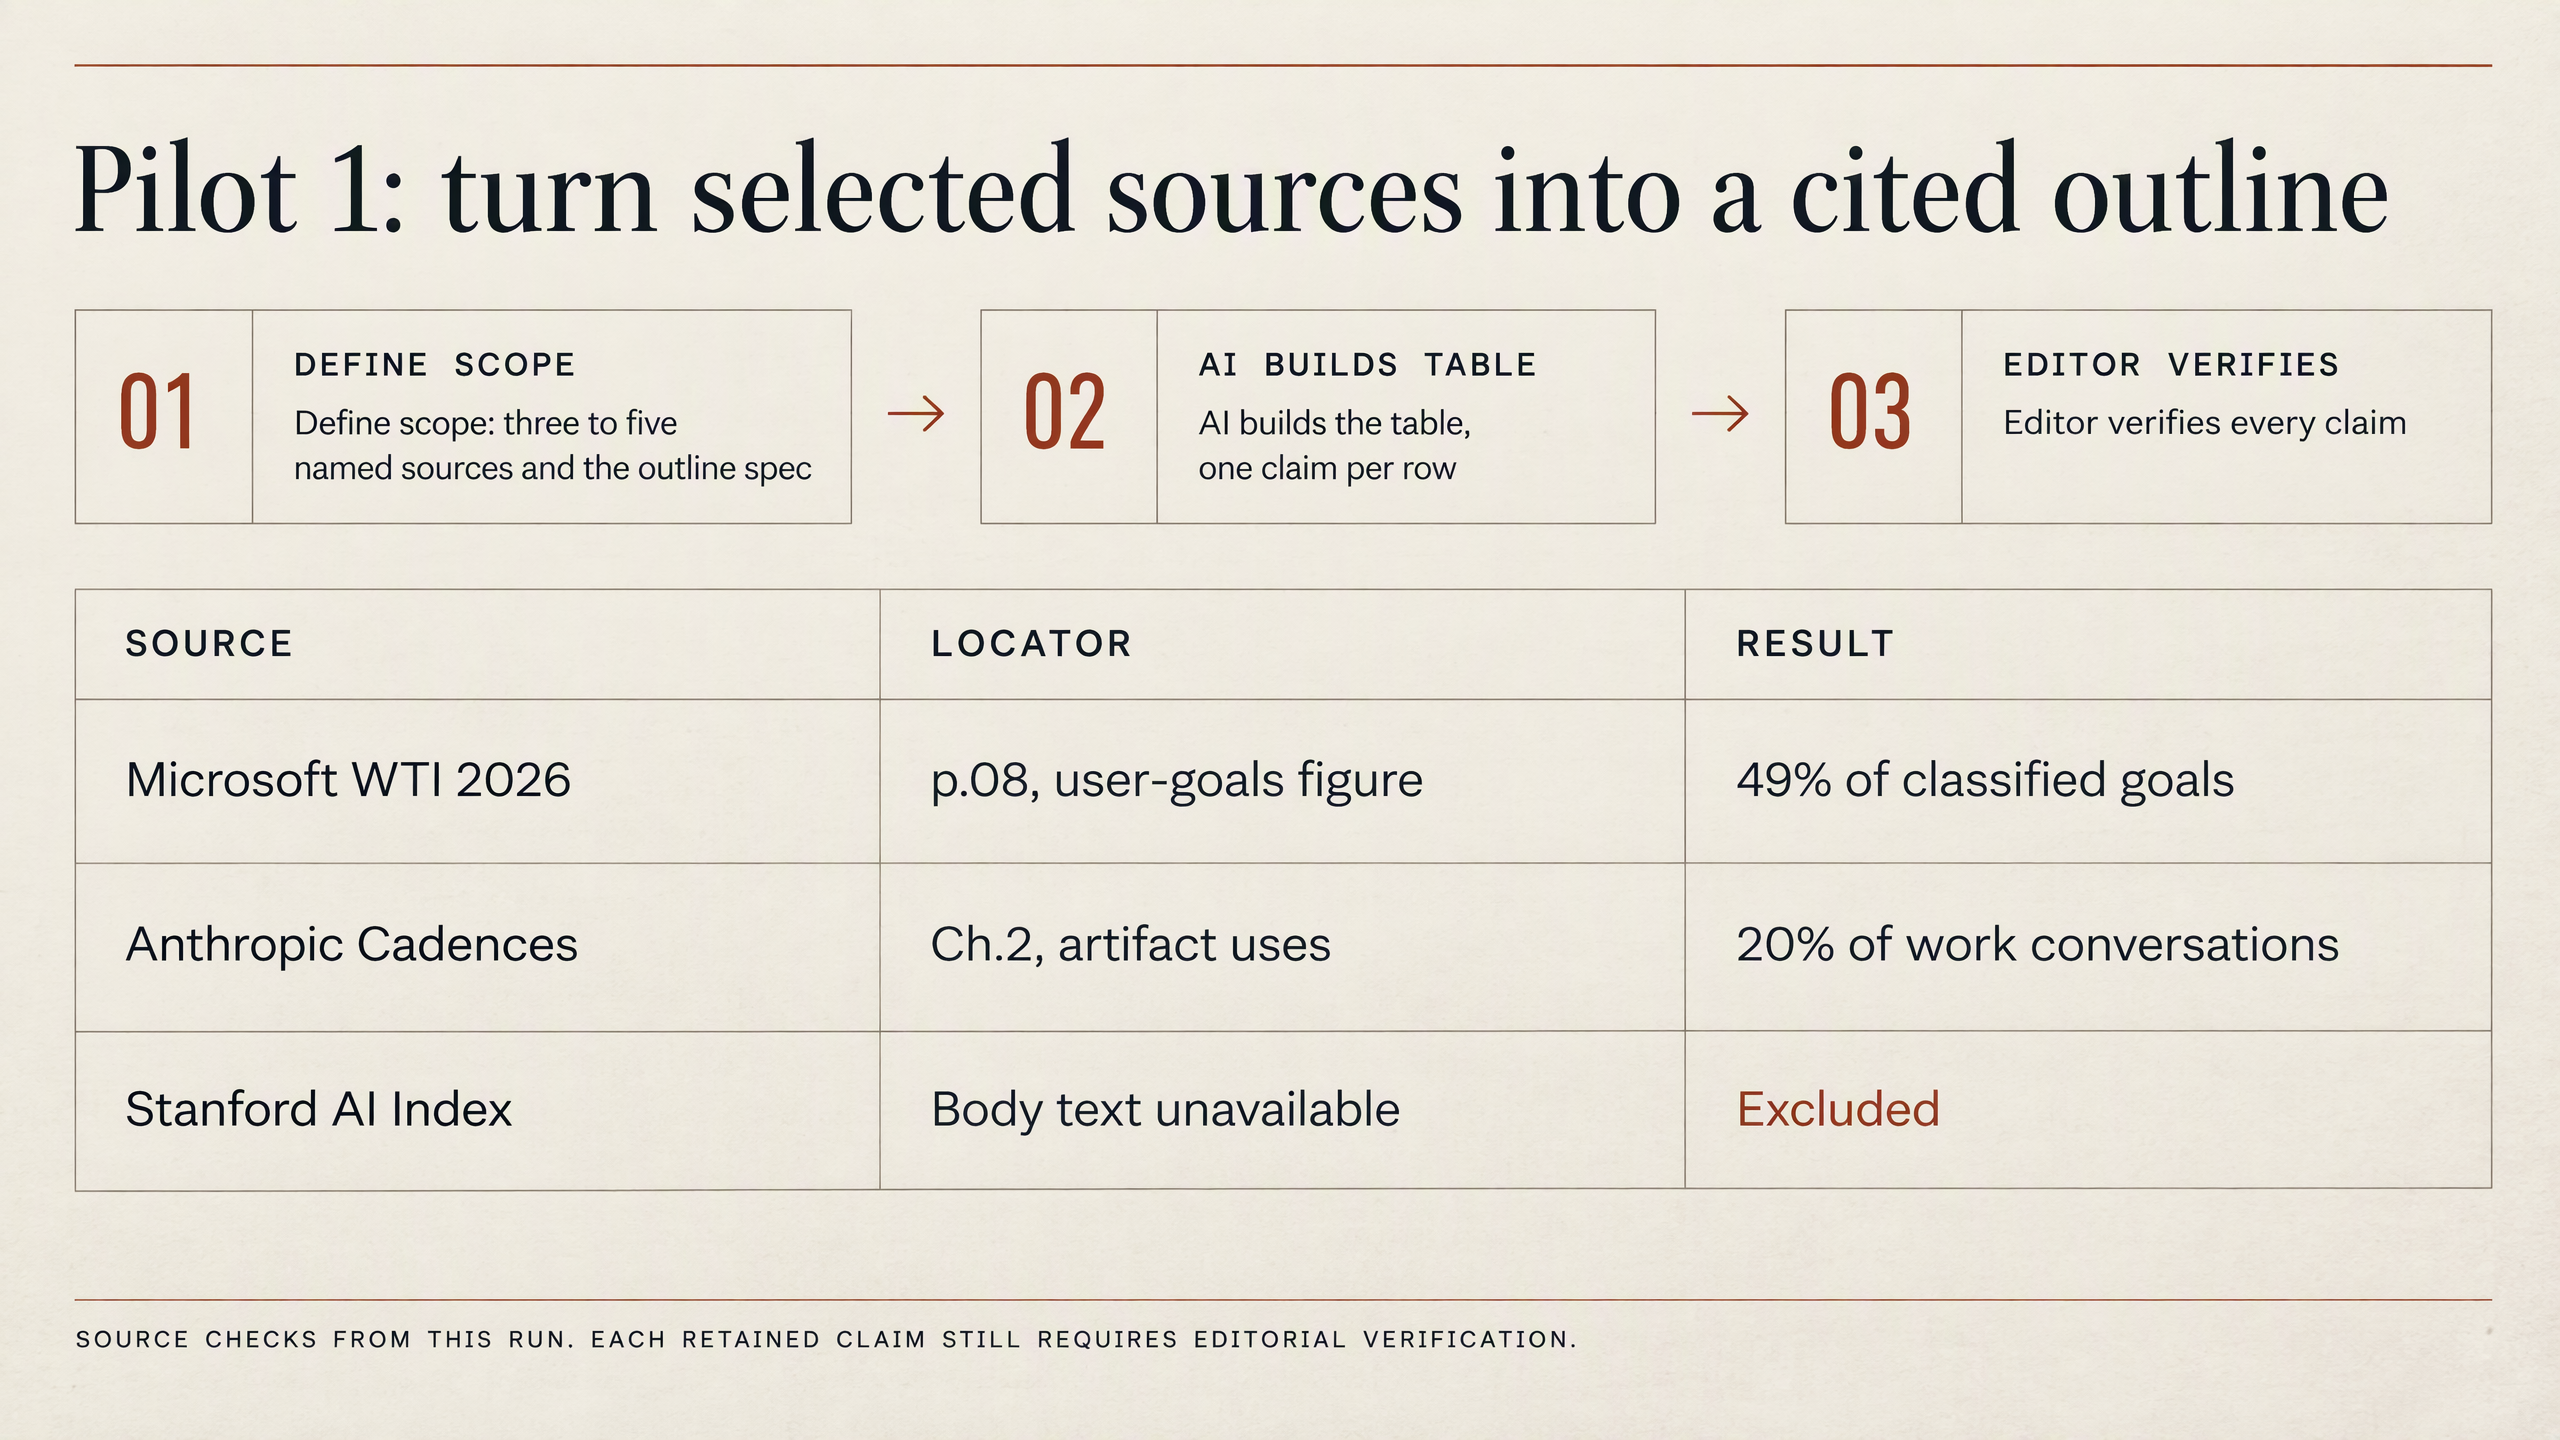
สไลด์ 3 (Pilot 1), รอบ 1
- ปัญหา: “Claim 1 / Source A / p.12” และข้อความคล้ายกัน—ตัวชี้ตำแหน่งที่ถูกกุขึ้นมาบนหน้าที่มีหัวข้อคือวินัยในการอ้างอิง
- วิธีแก้: สามแถวจริง—Source / Locator / Result:
- Microsoft WTI 2026 → p.08 → 49% ของเป้าหมายที่ถูกจัดหมวดหมู่แล้ว
- Anthropic Cadences → Ch.2 artifact uses → 20% ของบทสนทนาเกี่ยวกับงาน
- Stanford AI Index → body unavailable → Excluded
- ส่วนท้าย: การตรวจสอบแหล่งข้อมูลจากรอบนี้ ข้อกล่าวอ้างที่ยังเก็บไว้ยังคงต้องได้รับการยืนยันจากบรรณาธิการ
รอบ 3 (การตรวจสอบภาพหลังส่งออก): ตารางย่อยตรงกลางนำตัวชี้ตำแหน่งปลอมกลับมาอีก (“p.12”, “§ 3.1”) วิธีแก้: ลบตารางย่อยนั้นออกทั้งหมด แทนที่ด้วยภาพวาดมือกองกระดาษที่ไม่มีป้ายกำกับ เก็บแถบสามแถวจริงไว้ด้านล่าง
4. การแก้ความชัดเจน: หน้า failure-modes
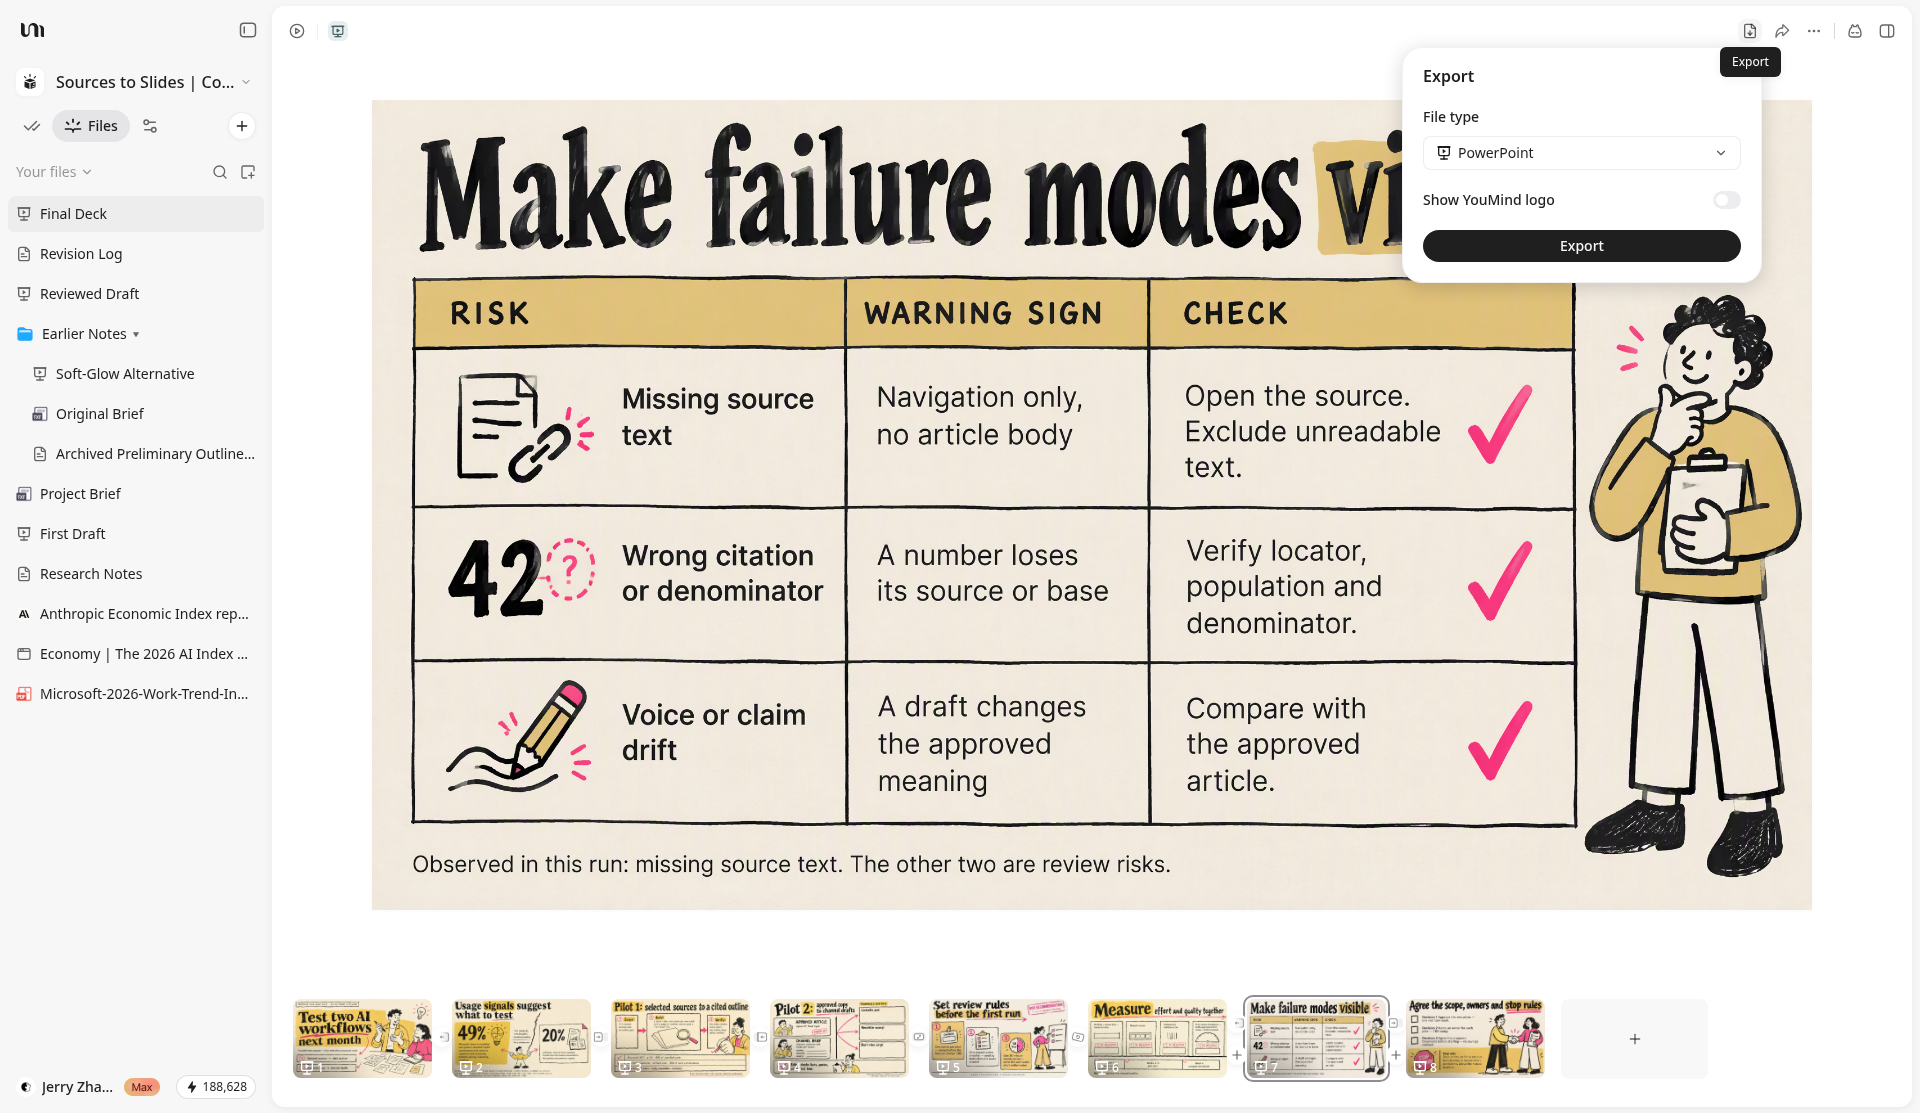
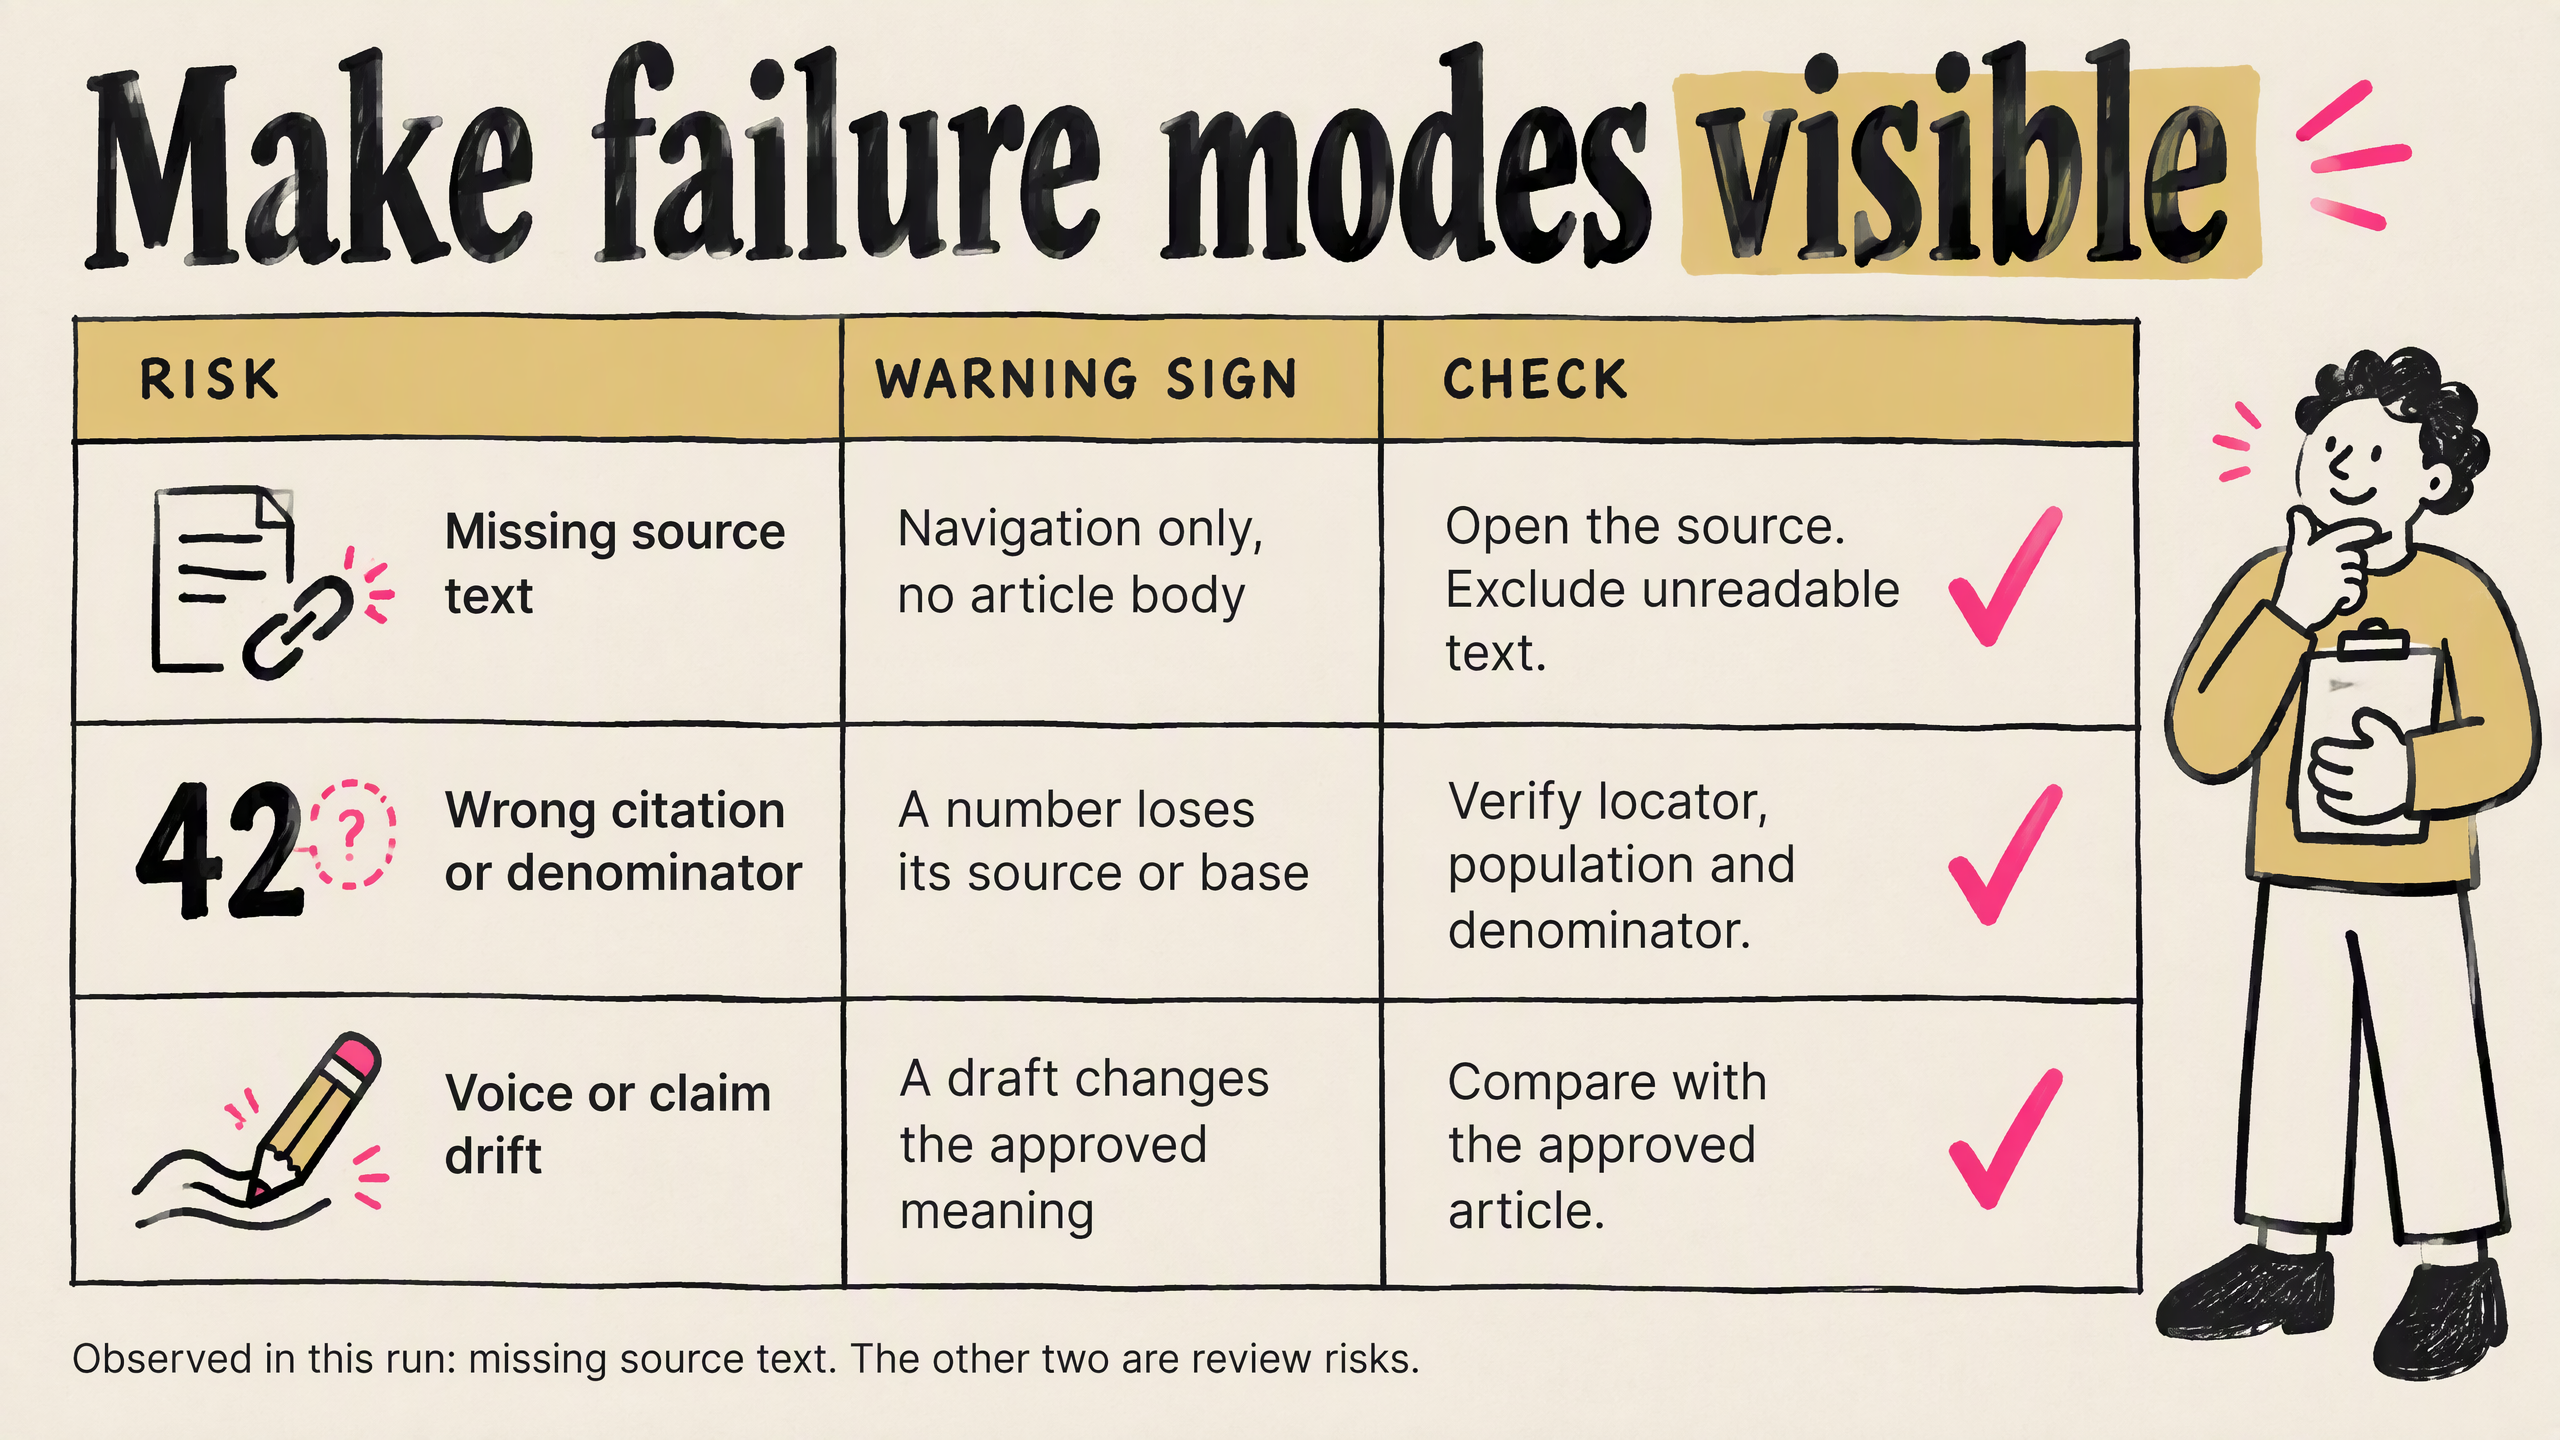
- ไม่มีหัวตาราง แถวที่สองทำซ้ำประโยคเดิมในคอลัมน์ warning และ check ทำให้ความหมายตรงกลางหายไป
- หลังแก้: หัวตาราง Risk / Warning sign / Check; สามแถวที่แตกต่างกัน (ข้อความแหล่งข้อมูลหาย การอ้างอิงหรือตัวส่วนผิด น้ำเสียงหรือข้อกล่าวอ้างเบี่ยงเบน) พร้อมวิธีตรวจสอบที่ใช้งานได้จริง
- รอบ 3: CHECK ไปทับเครื่องหมายติ๊กตกแต่งแทนที่จะอยู่ในคอลัมน์การกระทำ → สร้างใหม่บนกริดสามคอลัมน์จริง
5. การแก้ไขในตัวเครื่องมือ / สร้างใหม่: คุณไม่สามารถ “แก้คำเดียว” ได้
- เชิงอรรถสไลด์ 6 จบด้วยอักขระที่อ่านไม่ออก → สร้างหน้านั้นใหม่ทั้งหน้า ล็อกประโยคเดิมไว้: Week 1 establishes the manual baseline.
- คำนำหน้า “SOURCE: INTERNAL RESEARCH TEAM” ที่กุขึ้นมาปรากฏขึ้นหนึ่งครั้ง → ลบออก (ไม่มีแหล่งข้อมูลภายในเช่นนี้ในเคสนี้)
- เมตริกทั้งสี่ตัวยังคงเป็น TO BE MEASURED—ไม่มีตัวเลขปลอม
6. การเลือกสไตล์: เนื้อหาที่อนุมัติเหมือนกัน สองภาษาภาพ
หลังจากเนื้อหารอบ 1 ผ่านแล้ว ร่างแบบกระดาษ/หมึกก็ดูเรียบเกินไป—ข้อโต้แย้งแข็งแรง แต่การจัดวางอ่อนแอ ดังนั้น:
- รอบ 2a: Vibrant handdrawn for young professional (v1) → เลือกเป็น Final Deck (เส้นวาดมือ บล็อกสีจัดจ้าน ประเภทหน้าที่ต่างกันอย่างจงใจ)
- รอบ 2b: Modern Light Soft-glow (v9) → ไม่ถูกเลือก จัดเก็บเข้าคลัง
เนื้อหายังคงเดิมตลอดการปรับสไตล์: ถ้อยคำตัวส่วนของ 49%, แผงข้อเท็จจริงสองแผงที่แยกกัน, Stanford ถูกตัดออก, ผลลัพธ์ที่เสนอไว้ซึ่งว่างเปล่าของ Pilot 2, เมตริกที่ยังไม่ได้วัด, เจ้าของที่เป็น TBD, กฎการหยุดที่ติดป้ายว่า proposed
7. หลังส่งออก: ข้อจำกัดที่เปลี่ยนคำสัญญา
ไฟล์ PPTX จากสไลด์ชุดนี้คือ ภาพแรสเตอร์หนึ่งภาพต่อหนึ่งสไลด์ (เช่น 2560×1440)—ไม่มีวัตถุข้อความที่แก้ไขได้ ไม่มีแทร็ก speaker-notes การเปลี่ยนคำหมายถึงการสร้างภาพหน้านั้นใหม่และสลับชิ้นส่วนนั้น คำบรรยายอยู่ใน Research Notes ให้พรีเซนต์จากที่นั่น เชิงอรรถที่อ่านได้บนแล็ปท็อปอาจมองไม่เห็นจากด้านหลังห้อง
หากต้องการทราบว่าปุ่มและรูปแบบการส่งออกอยู่ที่ไหน ให้ใช้หน้าผลิตภัณฑ์: nano-banana-pro-slide อย่าอธิบายไฟล์นี้ว่าเป็น PowerPoint ปกติที่แก้ไขข้อความได้
สไลด์ชุดสุดท้ายในภาพรวม
- #: 1 · ทิศทางชื่อสุดท้าย: ทดสอบเวิร์กโฟลว์ AI สองรูปแบบเดือนหน้า · การตัดสินใจที่หน้านี้ปกป้อง: แผน ไม่ใช่ผลลัพธ์ ผลลัพธ์ที่ไม่ได้ติดป้ายจะถูกวัด
- #: 2 · ทิศทางชื่อสุดท้าย: สัญญาณการใช้งานบอกใบ้ว่าควรทดสอบอะไร · การตัดสินใจที่หน้านี้ปกป้อง: ข้อเท็จจริงสองข้อ ตัวส่วนสองตัว เหตุผลในการทดสอบ ≠ การพยากรณ์การประหยัด
- #: 3 · ทิศทางชื่อสุดท้าย: Pilot 1: แหล่งข้อมูลที่เลือก → โครงร่างที่อ้างอิง · การตัดสินใจที่หน้านี้ปกป้อง: ตารางตรวจสอบแหล่งข้อมูลจริง อ่านไม่ได้ → ตัดออก
- #: 4 · ทิศทางชื่อสุดท้าย: Pilot 2: ข้อความที่อนุมัติแล้ว → ร่างตามช่องทาง · การตัดสินใจที่หน้านี้ปกป้อง: ขอบเขตของข้อความที่อนุมัติแล้ว ผลลัพธ์เป็นเพียง “proposed”
- #: 5 · ทิศทางชื่อสุดท้าย: กำหนดกฎการตรวจทานก่อนรันครั้งแรก · การตัดสินใจที่หน้านี้ปกป้อง: การกำกับดูแลคือคำแนะนำของเรา ไม่ใช่ผลการวิจัย
- #: 6 · ทิศทางชื่อสุดท้าย: วัดความพยายามและคุณภาพไปด้วยกัน · การตัดสินใจที่หน้านี้ปกป้อง: รวมเวลาตรวจทานด้วย สัปดาห์ที่ 1 สร้างฐานอ้างอิง
- #: 7 · ทิศทางชื่อสุดท้าย: ทำให้โหมดความล้มเหลวมองเห็นได้ · การตัดสินใจที่หน้านี้ปกป้อง: ความเสี่ยงสามข้อ + วิธีตรวจสอบต้นทุนต่ำ สังเกตเห็นแค่ “ข้อความแหล่งข้อมูลหาย” ในที่นี้
- #: 8 · ทิศทางชื่อสุดท้าย: ตกลงขอบเขต ผู้รับผิดชอบ และกฎการหยุด · การตัดสินใจที่หน้านี้ปกป้อง: สไลด์สำหรับการตัดสินใจ กฎการหยุดก่อนเริ่มงาน
เช็กลิสต์ที่คุณเอาไปใช้ได้
- เขียนสามคำถามเปิดไว้แล้ว (การตัดสินใจ / ข้อกล่าวอ้าง / สิ่งที่ต้องห้าม)
- บันทึกแหล่งข้อมูลที่ไม่ได้ใช้แล้ว (รวมถึงการดึงข้อมูลเว็บที่ว่างเปล่า)
- หนึ่งข้อกล่าวอ้างต่อหนึ่งสไลด์ ตัวเลขสำคัญชี้กลับไปยัง PDF/หน้า + ตัวส่วน
- ล้าง placeholder ข้อความคำสั่งที่หลุดเข้ามา และไดอะแกรมที่ติดป้ายผิดออกหมดแล้ว
- หากสร้างมาสองสไตล์ ให้บันทึกเหตุผลที่เลือกและปฏิเสธ (รวมถึงการยกเลิกที่ล้มเหลว)
- ตรวจเนื้อหาก่อนส่งออก + ตรวจสอบหลังส่งออก: แก้ไขได้หรือไม่ โน้ตอยู่ที่ไหน
- ไม่มีลูกค้าปลอม การประหยัดปลอม หรือการถือว่าวลีค้นหาที่ยังไม่พิสูจน์แล้วเป็นทราฟฟิกที่ได้รับการยืนยัน
คำถามที่พบบ่อย
คุณจะเปลี่ยน PDF หน้าเว็บ และโน้ตให้เป็น PPT รายงานด้วย AI ได้อย่างไร?
ใส่แหล่งข้อมูลและกลุ่มผู้ชม/ข้อกล่าวอ้างที่ชัดเจนลงในพื้นที่ทำงานเดียว → สร้างโครงร่างที่ตรวจทานได้ (หนึ่งข้อกล่าวอ้างต่อสไลด์) และทำให้ผ่าน → สร้างร่างแรกผ่านการสนทนาหรือ Skill → แก้ไขชื่อ ตัดสัญญาณรบกวน และตรวจสอบตัวเลขกับแหล่งข้อมูลอีกครั้ง → ยืนยันว่าการส่งออกให้อะไรคุณจริง ๆ แล้วค่อยส่งมอบ ประเด็นไม่ได้อยู่ที่ความสมบูรณ์แบบในครั้งเดียว แต่อยู่ที่การตรวจสอบย้อนกลับได้ โครงร่างที่ได้รับการอนุมัติ และการแก้ไขโดยมนุษย์หลังการสร้าง
ปกติคุณแก้อะไรบ้างหลัง AI สร้าง PPT มาแล้ว?
สี่สิ่งที่ทำซ้ำบ่อย: (1) ตัดแหล่งข้อมูลที่ไม่ช่วยสนับสนุนข้อกล่าวอ้างหรืออ่านไม่ได้ (2) เขียนชื่อเรื่องที่คลุมเครือใหม่ให้เป็นข้อกล่าวอ้างแบบสรุปผล (3) ตรวจสอบตัวเลขและการอ้างอิงใน PDF หรือหน้าต้นฉบับ (4) ปรับให้เข้ากับรูปร่างการส่งออกจริง—หากสไลด์เป็นแรสเตอร์เต็มหน้า ให้วางแผนสร้างหน้านั้นใหม่เมื่อมีคำผิด
นี่ต่างจากการ อัปโหลด → สร้าง → ส่งออก บนหน้าเครื่องมืออย่างไร?
หน้าเครื่องมือแสดงเส้นทางความสามารถ บทความนี้แสดง การตัดสินใจและก่อน/หลัง บนชุดวัสดุเดียวกัน เพื่อให้คุณรู้ว่าควรหยุดและแก้ไขตรงไหน ปุ่มต่าง ๆ อยู่ที่ หน้าเครื่องมือ ส่วนความพร้อมส่งมอบอยู่ในเช็กลิสต์การแก้ไข
ยังเปรียบเทียบผู้ให้บริการอยู่ใช่ไหม? ดู /compare/autoppt
ขั้นตอนถัดไป
เปิด Board ด้วย PDF และโน้ตของคุณเองสักหนึ่งชุด รันเช็กลิสต์เดิม: สามคำถาม → ตัดโครงร่าง → สร้าง → แก้ไขอย่างน้อยหนึ่งชื่อเรื่องและหนึ่งตัวเลขเทียบกับแหล่งข้อมูล ติดเรื่องการเลือก Skill ใช่ไหม? กลับไปที่ คอลเลกชัน ต้องการเส้นทางผลิตภัณฑ์ใช่ไหม? ใช้หน้าเครื่องมือ
มีคำถามเกี่ยวกับบทความนี้ไหม?
ถาม AI ฟรีบทความที่เกี่ยวข้อง
สร้างภาพจำในทันที: ใช้ฟีเจอร์ Image-to-Prompt เพื่อสร้างสไตล์ภาพลักษณ์แบรนด์ที่สม่ำเสมอ
ลองนำภาพสิบภาพล่าสุดของคุณมาเรียงต่อกัน ถ้ามันดูเหมือนมาจากแบรนด์ที่ต่างกันสิบเจ้า — เจ้าหนึ่งเรียบหรูมินิมอล อีกเจ้าเป็นลายเส้นสีเหลืองอบอุ่น เจ้าถัดไปดันมีสีสันจัดจ้าน — ปัญหาไม่ใช่ว่าภาพแต่ละภาพดูดีหรือไม่ ปัญหาคือแต่ละภาพกำลังเล่าเรื่องคนละเรื่องกัน ในฟีดที่เต็มไปด้วยคอนเทนต์ สิ่งที่ทำให้คนจำคุณได้ไม่ใช่ภาพสวยงามเพียงภาพเดียว แต่เป็นความต่อเนื่องที่ทำให้พวกเขาคิดว่า "ฉันรู้ว่ามันคือคุณ ก่อนจะเห็นชื่อแอคเคาท์เสียอีก" และความต่อเนื่องนั้นไม่ใช่พรสวรรค์ — มันคือระบบ ความสม่ำเสมอทางภาพฟังดูเหมือนเป็นเรื่องสงวนไว้สำหรับแบรนด์ใหญ่และนักออกแบบมืออาชีพ แต่โดยแก่นแท้แล้วมันค่อนข้างง่าย: แสงแบบเดียวกัน จานสีเดียวกัน พื้นผิวของสื่อแบบเดียวกัน องค์ประกอบเดียวกัน ทำซ้ำจนกลายเป็นเอกลักษณ์ของคุณ สิ่งที่ยากไม่ใช่ "การสร้างภาพที่ดูดีสักภาพ" — แต่คือ "การทำให้ภาพที่ร้อยยังคงดูเหมือนเป็นครอบครัวเดียวกับภาพแรก" และที่น่าขันคือ เครื่องมือสร้างภาพด้วย AI กลับทำให้เรื่องนี้ยากขึ้น สิ่งที่ทำให้การแปลงข้อความเป็นภาพน่าดึงดูดนั้นเองที่ทำให้มันอันตรายต่อการสร้างแบรนด์: ทุกครั้งที่สร้างภาพ มันจะแตกต่างกันเล็กน้อย พรอมต์เดียวกันอย่าง "สไตล์ภาพประกอบอบอุ่นให้ความรู้สึกผ่อนคลาย" วันนี้อาจให้แสงนุ่มนวลครีมมี่ แต่พรุ่งนี้อาจให้สีส้มแดงเข้มข้น พรอมต์เดียวกัน "ภาพถ่ายสินค้ามินิมอล" ครั้งนี้อาจออกมาเป็นพื้นหลังสีขาวบริสุทธิ์ แต่ครั้งต่อไปอาจเพิ่มเงาโดยไม่มีเหตุผล โมเดลจะตีความคำอธิบายคลุมเครือของคุณใหม่ตั้งแต่ต้นทุกครั้ง และมันไม่เคยซึมซับจริงๆ ว่า "แบรนด์ของคุณควรมีลักษณะอย่างไร" ในใจคุณ ดังนั้นคุณจึงตกอยู่ในวงจรที่คุ้นเคย: คุณอธิบายแต่ละภาพตั้งแต่ศูนย์ มันก็เพี้ยนนิดหน่อยเสมอ คุณยอมแล้วโพสต์ ผ่านไปหลายเดือนคุณกลับมาดู แล้วแอคเคาท์ของคุณก็ดูเหมือนถูกดูแลโดยคนสามสี่คนที่มีรสนิยมแตกต่างกันโดยสิ้นเชิง มักถูกใช้เป็นเครื่องมือง่ายๆ ในการ "ย้อนวิศวกรรมว่าภาพถูกสร้างขึ้นมาอย่างไร" แต่ในบริบทของการสร้างแบรนด์ มันทำสิ่งที่สำคัญกว่านั้นมาก: มันนำสไตล์ภาพที่คุณจำได้ทันตาแต่บรรยายออกมายาก มาทำให้เป็นข้อความที่คุณสามารถคัดลอกและใช้ซ้ำได้ แนวทางง่ายดาย ขั้นแรก เลือกภาพ "จุดยึดสไตล์" หนึ่งภาพที่แสดงถึงบรรยากาศของแบรนด์คุณ — อาจเป็นโพสต์ที่ทำผลงานได้ดีที่สุด ภาพอ้างอิงที่คุณกลับมาดูบ่อยๆ หรือภาพพื้นฐานที่คุณสร้างขึ้นมาเพื่อแบรนด์นี้โดยเฉพาะ ป้อนให้เครื่องมือ แล้วมันจะ "อ่าน" ภาพนั้นออกมาเป็นคำอธิบายที่มีโครงสร้าง: วัตถุคืออะไร แสงมาจากไหน จานสีโทนเย็นหรืออุ่น เป็นภาพถ่ายหรือภาพประกอบ ความชัดลึกและพื้นผิวคืออะไร และบรรยากาศโดยรวม คำอธิบายนี้คือเวอร์ชันข้อความของดีเอ็นเอทางภาพของแบรนด์คุณ จากนี้ คุณไม่ต้องเขียนใหม่ตั้งแต่ต้นด้วยความรู้สึกทุกครั้งอีกต่อไป คุณมีเทมเพลตที่สามารถใช้ซ้ำได้ทันที ในพรอมต์ที่ถูกสกัดออกมา มีบางองค์ประกอบที่เป็นค่าคงที่ของแบรนด์คุณ และบางส่วนก็เป็นเพียงเนื้อหาของภาพนั้นๆ การแยกพวกมันออกจากกันคือกุญแจสำคัญของทั้งวิธีนี้ สิ่งที่คุณควรล็อกไว้มักรวมถึงสิ่งเหล่านี้: จานสี — ชุดของเฉดสีที่ทำให้คนจำคุณได้ในพริบตา; แสง — แสงอ่อนยามเช้าหรือแสงด้านข้างที่แรง; พื้นผิวของสื่อ — ภาพถ่ายเสมือนจริง ภาพประกอบกึ่งเสมือนจริง หรือการเรนเดอร์ 3 มิติ; นิสัยการจัดองค์ประกอบ — พื้นที่ว่างเยอะๆ วัตถุอยู่ตรงกลางหรือไม่อยู่ตรงกลาง; และบรรยากาศโดยรวม — สงบ คมชัด หรือมีชีวิตชีวา เมื่อรวมกันแล้ว มันคือส่วนที่ทำให้คนพูดว่า "ฉันจำคุณได้ก่อนที่จะเห็นชัดๆ" สิ่งที่คุณควรเปลี่ยนทุกครั้งคือแค่เนื้อหาเท่านั้น: ครั้งนี้วัตถุคือสินค้า A ครั้งหน้าเป็นสินค้า B; ภาพนี้是关于ฉากอาหารเช้า ภาพนั้น是关于โต๊ะทำงาน คุณคงไว้ซึ่ง "ยีน" ของสไตล์คุณ เปลี่ยนแค่ตัวแปรนั้นตัวเดียว แล้วสร้างใหม่ — แสงและจานสียังคงอยู่ มีเฉพาะสิ่งที่คุณเปลี่ยนเท่านั้นที่เปลี่ยน นี่คือเส้นแบ่งที่แท้จริงระหว่าง "การผลิตภาพทั้งชุดที่อยู่ในแบรนด์เดียวกัน" กับ "การเสี่ยงโชคตั้งแต่ต้นทุกครั้ง" การทดสอบจริงของความสม่ำเสมอทางภาพของแบรนด์ไม่ใช่แค่ภาพเดียว — แต่มันข้ามบริบท ปกบล็อกโพสต์ ชุดภาพโซเชียลมีเดีย พรีเซนเทชันภายนอก — ถ้าทุกอย่างมีสไตล์ต่างกัน แม้แต่คอนเทนต์ที่ดีก็รู้สึกไม่เป็นชิ้นเป็นอัน ด้วยพรอมต์ที่คงที่นั้น คุณสามารถกระจายภาษาเดียวกันไปทั่วทุกจุดสัมผัส: ใช้มันสร้างปกบล็อกที่สื่อถึงโทนของแบรนด์คุณ สร้างชุดภาพสำหรับโพสต์โซเชียลที่ดูเหมือนเป็นพวกเดียวกัน และแม้แต่กำหนดลุคที่เป็นหนึ่งเดียวสำหรับภาพประกอบในพรีเซนเทชันของคุณ ใน YouMind เริ่มจากพรอมต์นี้ คุณสามารถไหลผ่านงานทั้งหมดนี้ได้อย่างไร้รอยต่อ — ปก ภาพประกอบ และ Slides ใช้แสงและจานสีเดียวกัน แทนที่จะแยกกันไปคนละทาง เนื่องจากพรอมต์เป็นข้อความธรรมดา มันจึงทำงานข้ามเครื่องมือต่างๆ ได้: Nano Banana Pro, GPT Image 2, Midjourney และ Stable Diffusion ล้วนสามารถอ่านคำอธิบายเดียวกันได้ สไตล์แบรนด์ของคุณไม่ได้ถูกล็อกไว้กับโมเดลเดียว มีเส้นแบ่งที่ควรขีดให้ชัดเจน การได้รับแรงบันดาลใจจากแสง องค์ประกอบ และบรรยากาศของภาพนั้นดีต่อสุขภาพ แต่ถ้า "จุดยึดสไตล์" ของคุณมาจากภาพลักษณ์เด่นของคู่แข่ง ตัวละครที่มีลิขสิทธิ์ หรือโลโก้ของแบรนด์อื่น แล้วคุณใช้มันเป็นหน้าตาของคุณเอง — นั่นจะเลื่อนจาก "การสร้างสไตล์" ไปเป็น "การปลอมแปลงเอกลักษณ์" "สไตล์" ทั่วไปไม่มีใครเป็นเจ้าของ แต่การแสดงออกที่เฉพาะเจาะจงและจดจำได้ของแบรนด์คือทรัพย์สินของมันเอง ดังนั้นแนวทางที่ปลอดภัยที่สุดคือยึดกับเนื้อหาของคุณเอง — สินค้าของคุณ ฉากของคุณ ภาพพื้นฐานของคุณ — แล้วใช้พรอมต์ที่สกัดได้เพื่อทำให้เป็นระบบและขยายผล ทุกภาพที่คุณผลิตจะมีความสม่ำเสมอและเป็นของคุณอย่างแท้จริง ในอดีต ความสม่ำเสมอทางภาพของแบรนด์ต้องพึ่งพานักออกแบบที่จำทุกรายละเอียด หรือคู่มือสไตล์ที่ไม่มีใครอยากอ่าน ตอนนี้ คุณสามารถบีบอัดมันเป็นข้อความสั้นๆ: สกัดครั้งเดียว ใช้ซ้ำไม่รู้จบ เปลี่ยนเฉพาะสิ่งที่ต้องเปลี่ยน ครั้งต่อไปที่คุณต้องการภาพสำหรับคอนเทนต์ใหม่ คุณไม่ต้องเสี่ยงโชคจ้องมองกล่องพรอมต์ที่ว่างเปล่า คุณรู้แล้วว่าแบรนด์ของคุณมีลักษณะอย่างไร และคุณสามารถทำให้มันเป็นแบบนั้นทุกครั้ง Image to Prompt ช่วยเรื่องความสม่ำเสมอทางภาพของแบรนด์ได้อย่างไร? มันแปลภาพที่แสดงถึงบรรยากาศของแบรนด์คุณให้เป็นพรอมต์ที่มีโครงสร้าง คุณล็อกจานสี แสง สื่อ และองค์ประกอบไว้ ในแต่ละครั้งคุณเปลี่ยนแค่วัตถุหรือฉาก ภาพที่ได้จะคงสไตล์เดียวกันเสมอ 我应该ใช้ภาพไหนเป็น "จุดยึดสไตล์"? เนื้อหาของคุณเองปลอดภัยที่สุด: โพสต์ที่ทำผลงานดีที่สุด ภาพพื้นฐานที่คุณสร้างขึ้นมาโดยเฉพาะ หรือภาพที่เสร็จสมบูรณ์แล้วซึ่งแสดงถึงบรรยากาศของแบรนด์คุณได้ดีที่สุด หลีกเลี่ยงการใช้คู่แข่งหรือตัวละครที่มีลิขสิทธิ์เป็นจุดยึด พรอมต์นี้สามารถใช้ข้ามเครื่องมือ AI ต่างๆ ได้หรือไม่? ได้ เอาต์พุตเป็นข้อความธรรมดา และเครื่องมือแปลงข้อความเป็นภาพหลักๆ เช่น Nano Banana Pro, GPT Image 2, Midjourney และ Stable Diffusion สามารถนำไปใช้ได้โดยตรง สไตล์แบรนด์ของคุณจะไม่ถูกล็อกกับโมเดลเดียว มันจะทำให้ทุกภาพดูเหมือนกันหมดหรือไม่? ไม่ มันล็อกค่าคงที่ทางสไตล์ แต่เนื้อหายังคงแตกต่างกันในแต่ละครั้ง เป้าหมายคือให้พวกมันดูเหมือน "ครอบครัวเดียวกัน" ไม่ใช่การคัดลอกภาพเดียวกัน ฉันจำเป็นต้องมีประสบการณ์ด้านการออกแบบหรือการเขียนพรอมต์หรือไม่? ไม่ ขั้นตอนการสกัดจะแปลภาพเป็นข้อความให้คุณ คุณแค่ต้องตัดสินใจว่าองค์ประกอบใดคือค่าคงที่ของแบรนด์คุณและองค์ประกอบใดที่ควรเปลี่ยน จากนั้นก็เริ่มใช้ซ้ำได้เลย
เปลี่ยนรูปภาพให้เป็น Prompt สำหรับสร้าง AI Image ที่นำกลับมาใช้ใหม่ได้
คุณอาจเคยเจอช่วงเวลาแบบนี้: กำลังเลื่อนฟีดอยู่ แล้วเจอรูปภาพที่ทำให้คุณหยุดมอง—แสง จานสี และบรรยากาศที่คุณตามหามาหลายสัปดาห์ อยู่ในเฟรมเดียว คุณอยากสร้างอะไรแบบนั้นบ้าง เลยเปิดโปรแกรมสร้างรูป AI จ้องไปที่ช่อง prompt ว่าง ๆ แล้วพิมพ์อะไรบางอย่างที่คลุมเครือเช่น "ภาพแบบหนัง ไฟสวย มีบรรยากาศเต็มเปี่ยม" ผลลัพธ์? ได้ออกมาอะไรที่ไม่เกี่ยวกับภาพในหัวคุณเลย ปัญหาส่วนใหญ่ไม่ใช่รสนิยมของคุณ—แต่เป็นการแปลง ภาพที่เสร็จสมบูรณ์แล้วให้กลับเป็นข้อความที่ใช้สร้างมันขึ้นมาใหม่นั้นยากจริง ๆ ต้องใช้คำศัพท์เฉพาะทางเกี่ยวกับองค์ประกอบ มุมกล้อง แสง โทนสี และสไตล์—คำศัพท์ที่คนส่วนใหญ่ไม่เคยมีโอกาสสั่งสม นั่นคือสิ่งที่ ทำแทนคุณ: ใส่รูปภาพเข้าไป แล้วมันจะคืนข้อความกลับมาให้ บทความนี้จะอธิบายว่ามันคืออะไร ใช้ได้ดีตอนไหน ยังอ่อนด้อยตรงไหน และวิธีได้ prompt แรกของคุณภายในไม่กี่วินาที Image to Prompt คือการย้อนกลับของ text-to-image ปกติคุณเขียนคำอธิบายแล้วโมเดลก็สร้างภาพขึ้นมา แต่ตรงนี้ คุณให้รูปภาพที่เสร็จสมบูรณ์กับโมเดล แล้วมันจะเขียนคำอธิบาย—คือ prompt ที่คุณต้องพิมพ์เพื่อให้ได้ภาพนั้น คุณอาจเคยได้ยินชื่อเรียกต่างกันไป: reverse prompting, prompt extraction, image-to-prompt หรือเรียกง่าย ๆ ว่า "การถอด prompt จากภาพ" ชื่อจะต่างกันยังไง หน้าที่ก็เหมือนกัน: แปลงข้อมูลภาพให้เป็นคำอธิบายข้อความที่มีโครงสร้างและนำกลับมาใช้ใหม่ได้ ซึ่งเครื่องมือ text-to-image ตัวไหนก็เข้าใจ การถอดที่มีประโยชน์ต้องไปไกลกว่าแค่คำคลุมเครืออย่าง "แมวตัวหนึ่ง" มันต้องจับองค์ประกอบที่กำหนดตัวตนของภาพจริง ๆ: คุณอัปโหลดรูปภาพ แล้วเครื่องมือจะ "อ่าน" มันเหมือนสายตาที่ได้รับการฝึกฝน มองหาองค์ประกอบที่กำหนดผลกระทบทางภาพจริง ๆ: ตัวแบบและองค์ประกอบ ทิศทางและคุณภาพของแสง จานสีโดยรวม สไตล์และสื่อ รวมถึงรายละเอียดทางเทคนิคอย่างระยะชัดตื้นและพื้นผิว จากนั้นมันจะแปลงสิ่งที่เห็นเป็นภาษาที่แม่นยำ ประกอบร่างเป็น prompt ที่พร้อมใช้ แสงแบบหนึ่งกลายเป็น "แสงอาทิตย์ยามเช้าที่นุ่มนวล" โทนแบบหนึ่งกลายเป็น "สไตล์กึ่งเหมือนจริงอบอุ่น" ภายในไม่กี่วินาที คุณก็ได้ prompt ที่ใช้ได้ทันที ใน YouMind คุณสามารถใช้มันเป็นจุดเริ่มต้นเพื่อสร้างปกบทความ หรือแม้แต่สร้างภาพประกอบสำหรับงานนำเสนอ แต่จำไว้: ผลลัพธ์นี้เป็นร่างแรกที่ดี ไม่ใช่คำตอบสูงสุด มันคือความพยายามที่ดีที่สุดของเครื่องมือในการตีความรูปภาพ ซึ่งเป็นสิ่งที่หัวข้อถัดไปจะกล่าวถึง นี่คือการรันจริงแบบครบวงจร ขั้นแรก คุณอัปโหลดรูปอ้างอิง (ในกรณีนี้คือภาพประกอบแสงนุ่มนวลของคนถือแมวขาว) การ์ดอัปโหลดจะแสดงว่า: ไฟล์พร้อม ประมวลผลได้เลย คลิก Generate Prompt แล้วนี่คือผลลัพธ์จริง: เห็นไหม? มันไปไกลกว่า "คนถือแมว" มาก มันระบุทิศทางแสง จานสี ระยะชัดตื้น องค์ประกอบ และอารมณ์—ซึ่งเป็นปัจจัยที่กำหนดว่ารูปถัดไปของคุณจะตรงกับภาพอ้างอิงหรือไม่ ควบคู่กับ prompt เครื่องมือยังให้ขั้นตอนถัดไปที่ชัดเจน: สร้างตามเดิม เปลี่ยนองค์ประกอบหนึ่งอย่างโดยรักษาองค์ประกอบภาพเดิมไว้ หรือนำลุคนั้นไปใช้กับปกหรือกราฟิกโซเชียลมีเดีย จากตรงนี้ คุณไม่ต้องเริ่มต้นใหม่—แค่เปลี่ยนตัวแปรหนึ่งอย่าง เปลี่ยนแมวขาวเป็นหมา เปลี่ยนสีเสื้อ หรือย้ายฉากไปที่มุมอ่านหนังสือ แล้วสร้างใหม่ องค์ประกอบและแสงจะยังคงเดิม มีเพียงสิ่งที่คุณเปลี่ยนเท่านั้นที่ต่างออกไป คุณได้ "DNA" ของภาพอ้างอิง—แสง มุมเฟรม และบรรยากาศ—ในขณะที่ผลลัพธ์สุดท้ายเป็นของคุณเองอย่างไม่ต้องสงสัย เครื่องมือ image-to-prompt ส่วนใหญ่หยุดแค่ "นี่คือคำอธิบาย" —ซึ่งขั้นตอนนั้นตอนนี้กลายเป็นมาตรฐานไปแล้ว จุดที่ ของ YouMind โดดเด่นจริง ๆ คือสิ่งที่เกิดขึ้น หลัง จากที่คุณได้คำอธิบาย: มันเก่งที่สุดกับตัวแบบเดียวที่ชัดเจน: ภาพเหมือน ภาพผลิตภัณฑ์ ภาพทิวทัศน์ และภาพที่มีสไตล์สม่ำเสมอและเป็นที่รู้จัก ภาพอ้างอิงที่สะอาดและจัดแสงดีมักจะให้ prompt ที่สะอาดพอ ๆ กัน ในบางจุดที่พอคาดเดาได้ มันก็เริ่มไม่น่าเชื่อถือ องค์ประกอบที่ยุ่งเหยิงหลายตัวแบบ อาจทำให้มันสับสนว่าควรเน้นองค์ประกอบใดใน prompt งานศิลปะนามธรรม ยากที่จะลดเป็นข้อความและเสียสาระสำคัญบางอย่างไปเสมอ ภาพที่มีตัวหนังสือเยอะ (โปสเตอร์ อินโฟกราฟิก มีม) มักคืนข้อความที่เพี้ยนหรือมโนขึ้นมา เพราะโมเดลวิทัศน์ไม่ได้เก่งเรื่องการถอดข้อความ และเช่นเดียวกับโมเดล AI ทั่วไป เครื่องมือถอดก็มโนได้: มันอาจบรรยายวัสดุ แบรนด์ หรือรายละเอียดที่ไม่ได้อยู่ในภาพอย่างมั่นใจ ดังนั้นให้มองผลลัพธ์เป็นร่างที่ต้องตรวจเทียบกับภาพต้นฉบับ ไม่ใช่บันทึกถอดความตัวต่อตัว: อ่านมัน ลบทิ้งสิ่งที่ผิด เก็บสิ่งที่มีประโยชน์ไว้ ในเวลาประมาณสิบวินาที คุณก็สามารถถอด prompt ได้แล้ว การถอด prompt อธิบายสไตล์ มันไม่ได้โอนกรรมสิทธิ์ ถ้าใช้ให้ดี มันคือเครื่องมือสำหรับการเรียนรู้และคิดไอเดีย—วิธีทำความเข้าใจว่าทำไมภาพหนึ่งถึงเวิร์ก และสร้างสิ่งใหม่ในทิศทางที่คุณชื่นชม ถ้าใช้แบบไม่ระวัง มันก็ลื่นไถลไปสู่การลอกเลียน เส้นแบ่งที่สมเหตุสมผลคือ: ดึงแรงบันดาลใจจากแสง องค์ประกอบ และบรรยากาศ แต่อย่าลอกเลียนผลงานอันเป็นเอกลักษณ์ของศิลปินที่ยังมีชีวิต ตัวละครที่มีลิขสิทธิ์ หรือโลโก้แบรนด์ แล้วแอบอ้างว่าเป็นของตัวเอง โดยเฉพาะการใช้ในเชิงพาณิชย์ "สไตล์" ทั่วไปไม่ใช่ของใครคนใดคนหนึ่ง แต่การแสดงออกที่เฉพาะเจาะจงและเป็นที่จดจำนั้นเป็นเจ้าของได้ นั่นคือสิ่งที่เวิร์กโฟลว์ "การแทนที่" มีไว้: เปลี่ยนตัวแบบ ฉาก หรือมุม แล้วทำให้ผลลัพธ์เป็นของคุณอย่างแท้จริง เครื่องมือ Image to Prompt ฟรีไหม? ใช่ คุณสามารถอัปโหลดรูปภาพและสร้าง prompt บน YouMind ได้โดยไม่ต้องจ่ายเงิน รองรับไฟล์รูปแบบใดบ้าง? JPG และ PNG รวมถึงรูปแบบอื่น ๆ ครอบคลุมรูปถ่าย ภาพหน้าจอ และภาพที่ส่งออกจากโปรแกรมส่วนใหญ่ prompt ที่สร้างได้ใช้กับเครื่องมือ AI ตัวไหนได้บ้าง? โมเดล text-to-image ใดก็ได้ ผลลัพธ์เป็นข้อความธรรมดา จึงใช้ได้กับ Nano Banana Pro, GPT Image 2, Midjourney, Stable Diffusion, DALL·E และอื่น ๆ มันจะสร้างภาพที่เหมือนกันเป๊ะไหม? ไม่ และนั่นคือความตั้งใจ มันให้ prompt ที่อยู่เบื้องหลังสไตล์ เพื่อให้คุณสร้างเวอร์ชันของตัวเอง ไม่ใช่สำเนาแบบทุกพิกเซล ต้องมีประสบการณ์เขียน prompt ไหม? ไม่ต้อง จุดรวมของ image-to-prompt คือการช่วยคุณไม่ต้องเขียนเอง คุณสามารถปรับแต่งผลลัพธ์ได้ แต่ไม่ต้องเริ่มจากศูนย์ คราวหน้าที่รูปภาพทำให้คุณหยุดเลื่อนฟีด คุณไม่ต้องเดาข้อความที่ซ่อนอยู่ข้างหลัง และไม่ต้องลอกเลียนมัน ปรับแต่งให้เป็นสิ่งที่คุณต้องการ แล้วสร้างสรรค์สิ่งที่เป็นของคุณอย่างแท้จริง
AI กำลังทำลายกรอบความคิดแบบเก่าของมนุษย์
ครั้งแรกที่มันเกิดขึ้น ทั้งออฟฟิศก็เงียบกริบ จากนั้นมีคนกระซิบว่า "บ้าไปแล้ว" ตามมาด้วยเสียงฮือฮา ข้อความนิ่งๆ บนหน้าจอเพิ่งจะเปลี่ยนไป—ต่อหน้าต่อตาเรา—กลายเป็นสิ่งที่ตอบสนองได้ ลื่นไหล แทบจะมีชีวิต นี่คือการทำงานที่ประสบความสำเร็จครั้งแรกของ Dynamic View ของ Gemini 3 ภายใน YouMind ร่วมกับ Nano Banana Pro และเอนจินสร้างภาพของมัน และแน่นอนว่าผมต้องลองด้วยตัวเอง ปัญหาคือ... ตอนนั้นผมไม่มีจินตนาการเลย ผมเลยเลือกความคิดแรกที่ผุดขึ้นมาในหัว: จะเกิดอะไรขึ้นถ้าผมเปลี่ยนจดหมายข่าว AI ที่น่าเบื่อของผมให้กลายเป็น The Daily Prophet—หนังสือพิมพ์ภาพเคลื่อนไหวจาก Harry Potter? ผมสร้างมันขึ้นมา มันใช้งานได้ The Daily Prophet แบบอินเทอร์แอคทีฟ, ฉบับจดหมายข่าว AI. รับเอฟเฟกต์เดียวกันได้ที่นี่ และชั่วขณะหนึ่ง ผมคิดจริงๆ ว่าผมอาจจะร้องไห้ เนื้อหาไม่มีอะไรพิเศษ—เป็นเพียงการอัปเดต AI ทั่วไปที่ผมเผยแพร่ทุกสัปดาห์ แต่ตอนนี้คำเหล่านั้นกำลังเต้นรำอยู่ในหนังสือพิมพ์ขนาดใหญ่ที่มีชีวิตชีวาและมีมนต์ขลังที่พลิ้วไหวด้วยการเคลื่อนไหวและอารมณ์ ผมละสายตาไม่ได้ และนั่นคือตอนที่คำถามที่แท้จริงผุดขึ้นมาในใจผม: ถ้าสิ่งนี้สามารถทำให้เนื้อหาธรรมดาๆ รู้สึกน่าสนใจได้ขนาดนี้ มันจะทำอะไรได้บ้างกับสิ่งที่ยอดเยี่ยมจริงๆ? เมื่อมองแวบแรก นี่ดูเหมือนเป็นลูกเล่นทางภาพที่เจ๋ง เป็นแอนิเมชันที่หรูหรา เป็นหนังสือพิมพ์วิเศษ แต่นั่นเป็นเรื่องเล็ก เรื่องใหญ่คือมันทำลายมนต์สะกดที่เราอยู่ภายใต้มานานหลายพันปี—มนต์สะกดที่ดูเหมือน Newspeak เวอร์ชันที่อ่อนโยนกว่าของ Orwell อย่างน่าสงสัย ในปี 1984 ระบอบการปกครองสร้าง Newspeak ซึ่งเป็นภาษาที่จำกัดขอบเขตความคิดของมนุษย์ เมื่อเอาคำว่าอิสรภาพออกไป ผู้คนก็จะสูญเสียแนวคิดเรื่องอิสรภาพไปในที่สุด บีบอัดภาษา บีบอัดความคิด แต่ความจริงที่น่าอึดอัดคือ: คุณและผมก็อยู่ภายใต้ Newspeak ในรูปแบบของเราเองเช่นกัน ไม่ได้ถูกบังคับโดยระบอบการปกครอง แต่โดยสิ่งที่ละเอียดอ่อนกว่า: เทคนิค ภายในจิตใจของคุณ แนวคิดไม่ได้เป็นเส้นตรง พวกมันเป็นสามมิติ มีหลายชั้น มีมิติ—เหมือนพระราชวังที่มีห้อง บันได และประตูที่ซ่อนอยู่ แต่เว้นแต่คุณจะเป็นจิตรกร สถาปนิก หรือนักดนตรี คุณก็ไม่สามารถแสดงออกในวิธีที่ชัดเจนที่สุดได้ คุณถูกบังคับให้ทำให้ทุกอย่างแบนราบลงบนแถบข้อความเชิงเส้นที่แคบ ประโยคแล้วประโยคหนึ่ง ความคิดหนึ่งถูกบีบอยู่เบื้องหลังอีกความคิดหนึ่ง ทันทีที่ความคิดออกจากใจของคุณ มันก็สูญเสียความลึกไป แม้ในยุคอินเทอร์เน็ต ปัญหานี้ก็ยังไม่หายไป คุณรู้ว่าหน้าเว็บสามารถเป็นแบบมีมิติ โต้ตอบได้ มีชีวิตชีวา—แต่คุณไม่รู้วิธีเขียนโค้ด ออกแบบ หรือจัดวางเลย์เอาต์ คุณจึงถอยกลับไปใช้เอกสารแบบคงที่ ซึ่งเป็นเขตปลอดภัยที่ความซับซ้อนต้องลดลงเพื่อให้พอดี เทคนิคบีบอัดการแสดงออก และด้วยการบีบอัดการแสดงออก มันก็บีบอัดความคิดเอง นี่คือเหตุผลที่ความคิดของคุณรู้สึกยอดเยี่ยมในหัว แต่กลับไม่น่าประทับใจบนหน้ากระดาษ ภาชนะฆ่าพลังงานไปนานก่อนที่โลกจะมีโอกาสได้เห็นมัน แต่เมื่อ Gemini 3 รวมเข้ากับ Nano Banana Pro ภายใน YouMind เพดานนั้นก็แตกออกในที่สุด เป็นครั้งแรกที่ข้อความ ภาพ การเคลื่อนไหว และการโต้ตอบไหลรวมกันในสื่อเดียวที่ใครๆ ก็ควบคุมได้ เป็นครั้งแรกที่คุณสามารถแสดงความคิดเชิงพื้นที่เป็นความคิดเชิงพื้นที่ได้ ไม่ใช่เพราะคุณรู้เรื่องการออกแบบ—แต่เป็นเพราะ AI ทำให้การออกแบบสามารถเข้าถึงได้ นี่คือเสน่ห์ต่อต้าน Newspeak: AI คืนสิทธิ์ในการคิด—ที่เคยถูกขโมยไปโดยเทคนิค—กลับคืนสู่ผู้สร้าง เมื่อภาชนะขยายออก จิตใจก็ขยายตามไปด้วย มีอุปสรรคอีกอย่างที่ AI ค่อยๆ สลายไป: สุนทรียศาสตร์ ครั้งหนึ่ง ความงามเป็นสิทธิพิเศษ ที่ École des Beaux-Arts ในปารีส ศาสตราจารย์เดินผ่านสตูดิโอสอบและจัดเรียงภาพวาดของนักเรียนออกเป็นสองกองอย่างเงียบๆ: ทำต่อ และ ออกไป ไม่มีเกณฑ์ ไม่มีคำอธิบาย สุนทรียศาสตร์เป็นภาษาส่วนตัว เข้าถึงได้เฉพาะผู้ที่มีเวลา ทรัพย์สิน และการฝึกฝนเท่านั้น YouMind สามารถสร้างอินเทอร์เฟซที่มีจังหวะ ลำดับชั้น และความกลมกลืนตามธรรมชาติได้แล้ว คุณไม่จำเป็นต้อง "รู้เรื่องการออกแบบ" เพื่อแสดงสิ่งที่ดูเหมือนได้รับการออกแบบ ความงามกลายเป็นโครงสร้างพื้นฐานสาธารณะ และเมื่อความกลัวที่จะ "ทำให้สวย" หายไป ผู้สร้างก็สามารถกลับไปสู่คำถามที่แท้จริงได้ในที่สุด: ฉันต้องการสร้างโลกทางจิตวิญญาณแบบไหน? หากสุนทรียศาสตร์คือใบหน้า การส่งมอบคุณค่าคือจิตวิญญาณ ในทศวรรษ 1990 McKinsey ได้นิยามใหม่ของการให้คำปรึกษาโดยเปลี่ยนจากการใช้ "Blue Books" ที่หนาแน่นมาเป็นสไลด์ PowerPoint ที่สะอาดตาและเป็นภาพ มันไม่เพียงแต่เปลี่ยนวิธีการนำเสนอความรู้เท่านั้น แต่ยังเปลี่ยนวิธีการประเมินคุณค่าของมันด้วย วันนี้ YouMind อยู่ในช่วงเวลาของ McKinsey แต่ทวีคูณขึ้น สำหรับที่ปรึกษา นักการศึกษา นักวิจัย—ใครก็ตามที่ทำงานเกี่ยวกับความรู้—เอกสารไม่ได้เป็นผลลัพธ์สุดท้ายอีกต่อไป พวกมันเป็นวัตถุดิบ ผลลัพธ์ที่แท้จริงคืออินเทอร์เฟซ: การแสดงออกที่มีชีวิตชีวาและโต้ตอบได้ของแนวคิดของคุณ คุณไม่ได้ขายข้อมูลอีกต่อไป คุณกำลังขายประสบการณ์ความเข้าใจ เมื่อหนึ่งศตวรรษที่แล้ว การเคลื่อนไหวทางวัฒนธรรมใหม่ในประเทศจีนต่อสู้เพื่อสิทธิในการเขียนด้วยภาษาพูดในชีวิตประจำวัน—ภาษาพื้นถิ่นแทนที่จะเป็นภาษาคลาสสิก ข้อโต้แย้งนั้นง่าย: การแสดงออกเป็นสิทธิ ไม่ใช่สิทธิพิเศษ วันนี้ เราอยู่ในการเคลื่อนไหวทางวัฒนธรรมรูปแบบใหม่: สิทธิในการใช้พื้นที่ การเคลื่อนไหว และการโต้ตอบเพื่อสร้างโลกที่เราจินตนาการ เป็นครั้งแรกในประวัติศาสตร์: นักเขียนสามารถคิดเหมือนสถาปนิกได้ นักเรียนสามารถเรียบเรียงความคิดเหมือนผู้กำกับได้ นักวิจัยสามารถนำเสนอข้อมูลเหมือนนักออกแบบอินโฟกราฟิกได้ ผลงานสร้างสรรค์ของคุณไม่ได้อยู่บนหน้ากระดาษเฉยๆ พวกมันตั้งตรง พวกมันหายใจ พวกมันโต้ตอบกลับ มีความขัดแย้งที่เงียบงันอยู่ที่นี่ คุณกำลังอ่านสิ่งนี้ในเอกสารข้อความ—ในขณะที่ผมกำลังอธิบายว่าทำไมข้อความจึงไม่เพียงพออีกต่อไป ข้อความยังคงเป็นวิธีที่เร็วที่สุดในการจับประกายไฟ แต่มันไม่ใช่ขีดจำกัดของสิ่งที่ประกายไฟนั้นจะกลายเป็นได้อีกต่อไป เช่นเดียวกับปรัชญาที่เป็นหัวใจของ YouMind: "ทุกสิ่งเริ่มต้นจากฉบับร่าง และฉบับร่างจะกลายเป็นทุกสิ่ง" ข้อความเป็นเมล็ดพันธุ์ อย่าปล่อยให้มันติดอยู่ในขวด ฉบับร่างนี้และภาพประกอบที่มาพร้อมกันถูกสร้างขึ้นร่วมกับ YouMind