Prompts de pele realista
Para selfies, grandes planos e retratos
Prompts de pele realista
Para selfies, grandes planos e retratos
Pré-visualização
Descrição
Gere prompts para criar imagens de pessoas a partir de texto, em selfies, grandes planos, retratos de meio corpo e sessões fotográficas, com especial atenção a problemas como pele com aspeto plástico, película oleosa e rostos artificiais de IA. Quer procure retratos do dia a dia, imagens com aspeto de revista, instantâneos com flash direto ou retratos realistas com menos aparência de IA, pode personalizar o resultado de acordo com o sujeito, o ponto de vista, a iluminação, o estilo e as imperfeições pretendidas. Os prompts são organizados em torno do tom geral da pele, da localização dos brilhos, das diferenças entre zonas do rosto, de texturas como poros e penugem e das variações naturais do tom de pele, evitando simplesmente acumular expressões vagas como “pele realista” ou “hiper-realista”. Pode indicar formatos como 9:16, 3:4 e 1:1 e obter sugestões de composição e parâmetros adequadas ao modelo de geração de imagens utilizado. Quando necessário, também pode gerar versões em chinês, inglês ou bilingues para GPT-Image, 即梦, 豆包, Midjourney, SDXL ou Flux. Além de prompts positivos prontos a copiar, também explica como cada descrição importante influencia a textura da pele e fornece sugestões específicas de diagnóstico e ajuste quando surgem excesso de suavização, brilho oleoso em todo o rosto, aspeto de figura de cera ou texturas distorcidas. Os prompts gerados também podem ser guardados por tema, facilitando a sua consulta posterior, afinação e manutenção de uma textura consistente numa série de retratos.
Recomendado por
淡苍
Porque recomendamos esta habilidade
Divide a textura da pele em cinco pontos de controlo e resolve problemas como o aspeto plástico, oleoso e artificial da IA, com prompts bilingues prontos a copiar e rever.
Ideal para
Adequado para criadores de conteúdos, entusiastas de fotografia e utilizadores de geração de imagens que precisam de prompts para retratos naturais e realistas.
Como usar este Skill
Fornece os dados
Indique o sujeito, o ponto de vista, a iluminação, o estilo, as imperfeições pretendidas e o formato da imagem; pode também indicar o modelo de geração ou os idiomas necessários.
Executa o Skill
Organiza a textura da pele, a distribuição do brilho, as diferenças entre zonas, os detalhes da textura e as variações naturais, ajustando os prompts ao cenário.
Verifica o resultado
Obtenha prompts de geração de imagens de pessoas prontos a copiar, além de restrições negativas opcionais, análise da descrição e sugestões para resolver problemas de textura.
Habilidades relacionadas
Ver tudo Imagem
Diretor de Retratos Asiáticos
Esta skill foi concebida para utilizadores que precisam de criar prompts de alta qualidade para retratos em plataformas de geração de imagens por IA, sendo especialmente adequada para criadores e designers que procuram uma estética asiática e representações femininas maduras e naturais. Transforma as suas ideias criativas em prompts concretos e práticos, assegurando a qualidade visual e a compatibilidade com a plataforma. As principais funções desta skill incluem gerar, a partir da sua descrição, prompts compatíveis com vários modelos populares de geração de imagens por IA, como Midjourney, SDXL, Flux, GPT Image, 豆包, 即梦 e ComfyUI. Identifica e reformula de forma inteligente termos de alto risco, garantindo que o conteúdo dos prompts cumpre as normas de segurança das plataformas e evitando expressões infantilizadas, vulgares ou que deem demasiada ênfase a partes específicas do corpo. Também pode alternar rapidamente entre diferentes estilos de imagem através de comandos rápidos, como selfie fotorrealista, produção de revista comercial, cosplay sofisticado, cyberpunk ou estilo clássico chinês, além de permitir corrigir os prompts com base no feedback de gerações falhadas. Quer pretenda criar uma capa de revista de moda, um retrato com atmosfera cinematográfica ou o design de uma personagem 3D em CG, esta ferramenta fornece descrições linguísticas precisas e sugestões de parâmetros. Os prompts finais são optimizados de acordo com a plataforma escolhida: frases longas e naturais em inglês para Midjourney, grupos claros de palavras-chave positivas e negativas para SDXL/Flux ou campos de parâmetros modulares detalhados para ComfyUI, ajudando-o a gerar retratos por IA de forma eficiente e alinhada com as suas expectativas.
 Imagem
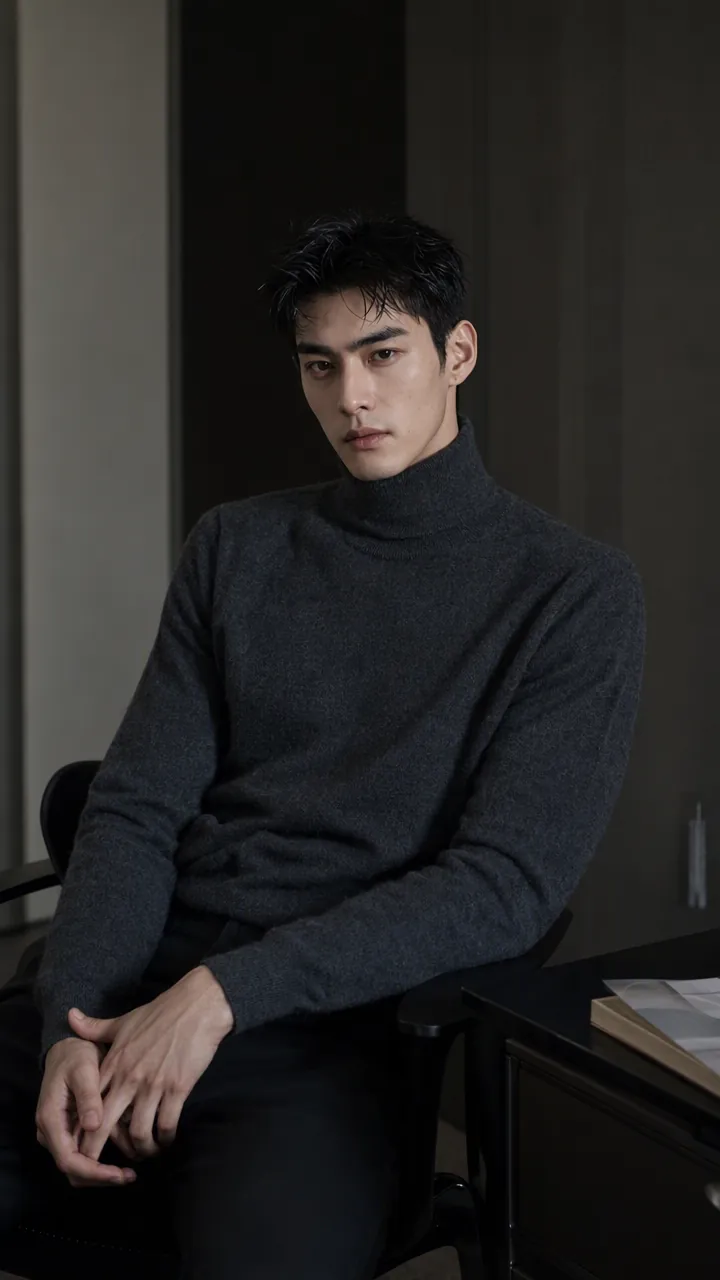
Personagens IA com precisão
Transforme a imagem de uma personagem que tem em mente em prompts prontos a usar e numa imagem final. Parta de uma breve descrição inicial ou de uma ideia temática e defina progressivamente detalhes essenciais como o penteado, os acessórios de cabelo, o vestuário, a expressão, a pose, o enquadramento, a iluminação e o cenário. Quer pretenda criar uma figura feminina de estilo tradicional chinês, uma rapariga ciborgue, uma personagem de estilo japonês, um retrato realista ou uma personagem personalizada, obterá uma solução visual coerente e harmoniosa com base na atmosfera geral. Pode escolher a geração rápida de imagens e deixar que a IA complete automaticamente a definição da personagem, ou optar por um controlo detalhado, ajustando cada elemento por seleção ou personalização. Os resultados incluem prompts estruturados bilingues em chinês e inglês, bem como um Negative Prompt compatível com o estilo visual escolhido, para facilitar a compreensão e a reutilização, além de serem adequados para utilização com modelos populares como FLUX, Midjourney e SDXL. A personagem é também gerada através de IA. Depois de gerar a imagem, pode continuar a ajustá-la por dimensão — por exemplo, alterando o penteado, a expressão, a pose, o ângulo da câmara, a iluminação, o cenário ou o estilo visual — e gerar novamente a imagem, mantendo as restantes definições. As alterações feitas são apresentadas de forma clara. Ideal para design de personagens, concept art de figuras, criação de avatares, desenvolvimento de ideias para ilustrações e exploração de definições visuais.
 Imagem
Streetwear com flash direto
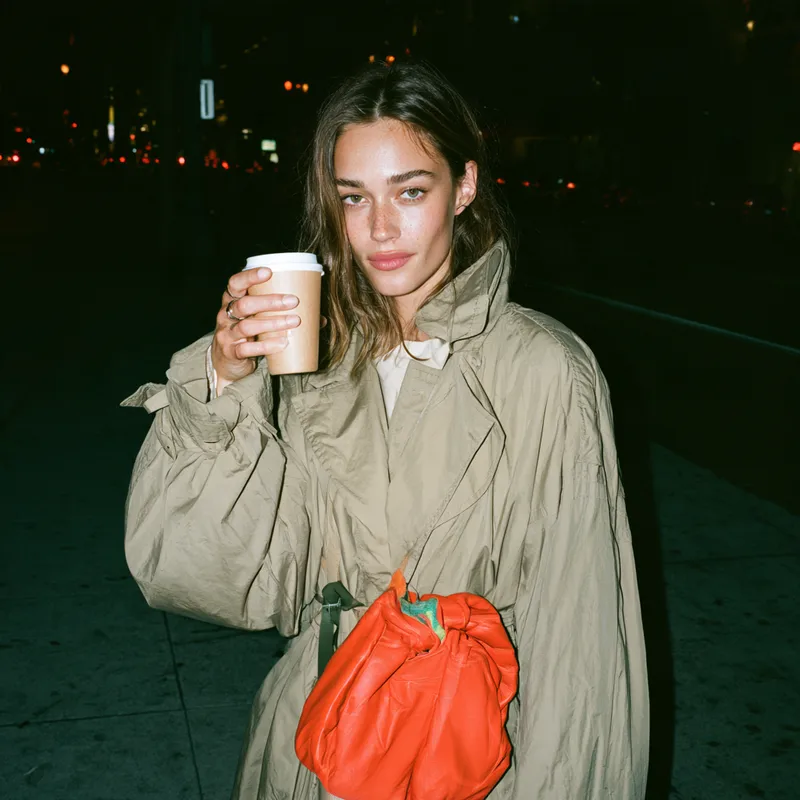
Gera prompts de imagem para streetwear, malas, calçado e outros acessórios, com um ambiente espontâneo de flash direto a curta distância. Mantém os produtos nítidos e em destaque, preservando poses descontraídas e a sensação de uma fotografia captada no momento, num cenário urbano real. É adequado para visuais de marca, conteúdos para redes sociais e geração inicial de conceitos de moda e acessórios, sem transformar a imagem numa sessão de estúdio rígida ou numa campanha publicitária excessivamente retocada. Pode indicar um produto, um look completo ou uma situação de utilização específica, além de definir cores, materiais, quantidade, forma de transporte e formato da imagem. O resultado organiza a cena em torno de um flash frontal próximo, sombras curtas e marcadas, uma exposição ambiente mais escura mas percetível e fundos urbanos em cinzento natural, branco, azul-escuro ou semelhantes. A composição é ajustada conforme a relação com o produto — na mão, a tiracolo ou pousado sobre uma mesa — para tornar mais visíveis o corpo da mala, as alças, as solas e a estrutura da roupa. Por predefinição, gera conceitos visuais independentes em 16:9, juntamente com prompts prontos a utilizar no Midjourney e no ImageGen em chinês. Se precisar apenas de um dos formatos, também o pode solicitar. Para séries com várias imagens, mantém as características do produto e o estilo visual consistentes, alterando os cenários e as poses para criar uma série coerente de imagens de moda urbana.
Informações
- Versão
- v6
- Última atualização
- Créditos por execução
- Conforme a utilização
- Modelos
- Automático
- Casos de utilização
- Imagens e design
- O que vais obter
- Prompt