Assistente de modelos e tokens
Modelos adequados, com contexto do projeto
Assistente de modelos e tokens
Modelos adequados, com contexto do projeto
Pré-visualização
Descrição
Com base na dificuldade da tarefa, no tipo de conteúdo e na fase do projeto, ajuda-te a escolher o modelo de IA mais adequado e aplica um conjunto de regras para poupar quota e, assim, Tokens. Permite controlar o consumo da quota enquanto realizas tarefas de programação, criação, planeamento, design e análise de informação. Quer se trate de componentes de páginas, integração de APIs, correções simples de erros, ou de design de arquitetura, lógica complexa, revisão e refatoração de código, apresenta recomendações claras de modelos e fornece diretamente o resultado necessário. Também é adequado para tarefas do dia a dia, como textos, títulos e ganchos, conteúdos narrativos, propostas de marca, planos de marketing, estruturas de PPT, ideias visuais, tendências de mercado, análise da concorrência e interpretação de dados. Para trabalhos simples, em lote ou formatados, dá prioridade a abordagens que consumam menos quota; quando estão em causa decisões importantes, raciocínio complexo ou a versão final, lembra-te de investir num modelo mais adequado à qualidade pretendida. Com a utilização contínua, ajusta as recomendações com base nas tuas preferências de modelos, hábitos de produção, stack tecnológico do projeto, decisões importantes, tarefas pendentes e problemas conhecidos, reduzindo a necessidade de repetir informações. Nas tarefas de código, por predefinição, concentra-se nas alterações essenciais e resume o que foi alterado. Nas tarefas de textos e propostas, começa por organizar a estrutura geral e desenvolve-a conforme necessário, para que cada conversa se adapte melhor ao projeto atual e ao teu ritmo de trabalho.
Habilidades relacionadas
Ver tudo
Otimizador de Prompts de IA
O Otimizador de Prompts de IA concentra-se em melhorar a qualidade das instruções através de um quadro sistemático, ajudando-o a transmitir a sua intenção com precisão e a obter resultados de IA mais estáveis e previsíveis. Quer precise de melhorar instruções existentes, criar descrições de tarefas complexas a partir do zero, ou encontrar modelos profissionais para cenários específicos, esta competência oferece um suporte completo. Ela não só reconstrói pedidos vagos em instruções estruturadas, mas também identifica e corrige falhas lógicas comuns através de um processo de diagnóstico. Esta competência inclui vários quadros de otimização maduros, que ajustam as estratégias consoante a natureza da tarefa. Por exemplo, para documentos formais e conteúdo profissional, reforça a definição do contexto e do público-alvo; em tarefas de geração de código ou processamento de dados, dá mais ênfase à definição de papéis e a restrições específicas. Desta forma, garante que cada prompt tenha objetivos claros, um estilo definido e um formato de saída padronizado. Além disso, inclui modelos especializados para vários cenários frequentemente usados, desde a criação de texto para marketing e análise de dados até à redação de documentação técnica. Pode utilizar diretamente estas estruturas validadas para preencher rapidamente informações-chave, como pontos de venda principais, explicações de dados ou o contexto do leitor. Durante a otimização, a competência recorre a uma lista de verificação de qualidade, com múltiplas iterações e comparação de alternativas, para o ajudar a dominar as principais técnicas de engenharia de prompts, reduzindo significativamente os custos de comunicação e aumentando a produtividade.
Economizador de Tokens YouMind
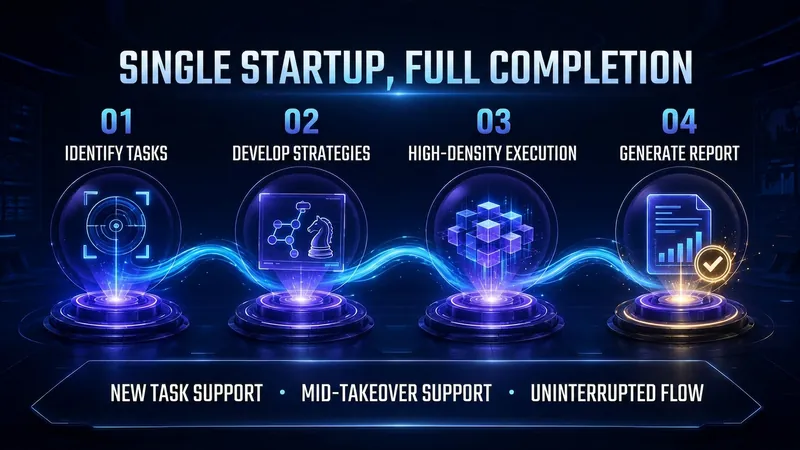
Já calculou quanto paga por mês pela "conversa fiada" da IA? "Ok, vou ajudar..." "Primeiro, vamos rever a sua pergunta..." "Resumindo, acima está..." Você nem lê estas frases, mas cada palavra consome os seus tokens. 💸 Criei uma Skill chamada «Token Economizador» para resolver isto: ✅ Identifica automaticamente o tipo de tarefa e aplica a estratégia de poupança de tokens ✅ Corta redundância sem perder profundidade, a qualidade não diminui nem um cêntimo ✅ Após concluir, gera automaticamente uma fatura: poupança de 40%+, tudo claro Se usa IA regularmente, instale esta Skill e poupe o suficiente para vários cafés. Um facto ignorado por muitos: grande parte do que paga pela IA não é pela "resposta", mas pela "linguagem processual" — saudações iniciais, repetição da pergunta, transições, resumos finais. Estes conteúdos não geram valor, mas cada token é cobrado. Empacotei toda a metodologia de otimização de densidade de informação numa Skill: «Token Economizador». A sua lógica é direta — identifica o tipo de tarefa e aplica automaticamente a estratégia de poupança de tokens, executa a tarefa com a máxima densidade de informação, elimina toda a expressão redundante, e ao mesmo tempo garante que a qualidade da saída não diminui através de restrições rigorosas; após a tarefa, gera automaticamente um relatório detalhado de tokens, dizendo-lhe quanto cada etapa consumiu, quanto poupou em comparação com o modo padrão, e como pode otimizar no futuro. Suporta dois modos: iniciar no início ou assumir a meio, sem qualquer configuração. Se é um utilizador intensivo de IA — escritor, investigador, criador de conteúdo em massa, utilizador de API de pagamento por uso — esta Skill é essencialmente uma "máquina de poupança": instale uma vez e cada conversa ajuda a comprimir os custos. Já disponível no mercado de Skills da YouMind, procure por «Token Economizador» para instalar.
Assistente de Projetos de I&D
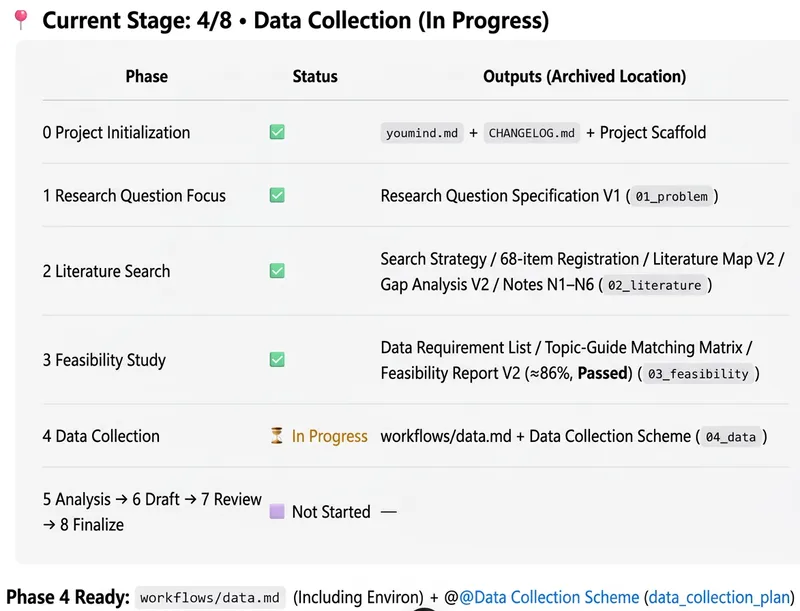
Destinado a docentes do ensino superior e investigadores, parte de uma ideia de investigação ainda pouco definida e ajuda a construir, passo a passo, um plano de projeto de investigação exequível e elegível para candidatura. Abrange projetos de nível nacional, projetos provinciais de humanidades e ciências sociais, projetos de inovação pedagógica e outros tipos de projetos de investigação. Basta fornecer o tipo e o nível do projeto, o aviso ou modelo de candidatura, a área de investigação, os resultados obtidos e os dados pessoais e institucionais. O assistente ajuda a clarificar o tema, a focar o problema e a criar a estrutura-base completa da candidatura, tendo em conta a questão de investigação, os requisitos da candidatura e a lógica da avaliação. Nas etapas seguintes, o assistente pode apoiar a pesquisa académica, a revisão da bibliografia, a análise das lacunas de investigação, a demonstração da viabilidade dos dados e dos métodos, a correspondência com projetos semelhantes e o ajuste do desenho da investigação. Garante que a bibliografia, os dados e as informações sobre a aprovação do projeto são reais e verificáveis, e integra a utilização de AI, a atualidade e a inovação metodológica no tema e nos pontos de inovação. Quando o plano de investigação estiver amadurecido, pode também redigir um primeiro rascunho da candidatura com base no aviso ou modelo em branco fornecido, simular diferentes perspetivas de avaliação e apresentar sugestões de revisão, aperfeiçoando o documento até à versão final. Ao longo de todo o projeto, são conservados os resultados de cada etapa, o histórico de versões e a fundamentação das alterações. No final, é possível organizar a candidatura, o roteiro técnico, o esquema da estrutura da investigação, o diagrama lógico dos pontos de inovação, o gráfico de Gantt do calendário e outros elementos gráficos científicos. Para tarefas que dependam de um ambiente externo, como a análise integral de PDFs, a execução de código, a recolha de dados na Web ou o processamento de grandes volumes de dados, o assistente identifica claramente o trabalho a transferir e permite retomar o processo com os resultados preenchidos, ajudando a avançar desde a preparação do projeto até à versão final normalizada.
Informações
- Versão
- v2
- Última atualização
- Créditos por execução
- Conforme a utilização
- Modelos
- Automático