Mosaico de Legendas de Vídeo
Crie imagens longas com legendas de vídeos
Mosaico de Legendas de Vídeo
Crie imagens longas com legendas de vídeos
Prévia
Descrição
Transforme vídeos locais ou online que você tenha o direito de processar em imagens longas de legendas em proporção 3:4 ou na proporção original da tela. O processo inclui obtenção da fonte, localização de transcrição, seleção de temas e frases, captura precisa de quadros, corte compacto, montagem e inspeção de qualidade quadro a quadro. Suporta dois modos de saída distintos: o modo de legenda nativa, que preserva as legendas já embutidas na imagem, e o modo de legenda de roteiro, que desenha carimbos de data/hora e falas revisadas em quadros de vídeo reais. Utilize quando for necessário obter capturas de tela com legendas nativas, mosaicos de quadros de legenda, imagens longas de frases marcantes do YouTube, capturas de tela de falas, legendas sem reDesenho, falas personalizadas em chinês, ou ao ajustar a proporção da imagem principal, área de legendas, espaçamento de falas e estética.
Recomendado por
Dancang
Por que recomendamos esta habilidade
Esta habilidade diferencia rigorosamente legendas nativas de legendas roteirizadas, evitando alterações indevidas no conteúdo e organizando falas verificadas em imagens longas e confiáveis.
Ideal para
Ideal para criadores de conteúdo e editores que precisam organizar legendas originais ou falas revisadas em imagens longas compartilháveis.
Como usar este Skill
Forneça os dados
Forneça um vídeo local ou online que você tenha o direito de processar, especificando o modo de legenda original ou roteirizada, pontos temporais ou falas, e a proporção de tela desejada.
Execute o Skill
Selecione e verifique os quadros do vídeo e o conteúdo das legendas, preservando as originais ou desenhando as falas confirmadas no quadro real conforme o modo escolhido, antes de montar a imagem e realizar uma inspeção individual.
Confira o resultado
Receba uma ou mais imagens longas de legendas de vídeo, acompanhadas de dados de tempo ou falas e de uma visão geral de pré-visualização.
Habilidades relacionadas
Ver tudo
Assistente de prompts H3
Entregue um vídeo de referência completo à IA multimodal para decompor automaticamente os planos reais, a linha do tempo, as mudanças visuais e os sons audíveis, gerando prompts de nível profissional prontos para a criação de vídeos. A ferramenta não se limita a pessoas, anúncios ou materiais cinematográficos: também é adequada para exibição de produtos, arquitetura e paisagens, animais, gastronomia, movimentos esportivos, dança, animações 2D/3D, demonstrações de UI, gravações de tela, infográficos, efeitos visuais e imagens abstratas. Com base na estrutura informacional do vídeo, o assistente pode gerar um prompt completo para texto em vídeo ou, para cada Shot, prompts de imagem de referência/quadro inicial, descrições de movimento contínuo, prompts de quadro final quando necessário e restrições de estabilidade no nível do plano para vídeo a partir de imagem. Quando tanto a imagem estática quanto as mudanças ao longo do tempo são importantes, também pode fornecer as duas versões. O conteúdo gerado preserva as informações que podem ser confirmadas, como sujeito, composição, movimento de câmera, causalidade das ações, mudanças estruturais, textos, diálogos, sons ambientes e música, acompanhando cada plano até seu estado final real. Quando textos, sons, identidade, local ou método de filmagem não puderem ser confirmados com clareza, o assistente evita preencher lacunas por conta própria. Ele também diferencia a imagem desejada de elementos externos, como marcas-d’água do reprodutor e camadas de controle, reduzindo desvios de conteúdo durante a geração. É indicado para criadores e equipes de produção que precisam extrair prompts de texto em vídeo ou prompts de planos I2V de vídeos de referência, além de organizar materiais para reconstrução de vídeos, reprodução de estilos e criação de anúncios generativos.
 Vídeo
Gerador de fábulas
Transforme rapidamente um provérbio, uma história tradicional ou uma fábula em um roteiro de storyboard narrativo contínuo, pronto para uso na geração de vídeos. Seja «Esperando o coelho», «Tapando os ouvidos para roubar o sino», «Sima Guang quebra o jarro» ou qualquer expressão idiomática informada pelo usuário, a ferramenta recupera o contexto da história, as relações entre os personagens, as ações principais e a moral, organizando tudo em uma trama curta, clara e dinâmica. Por padrão, são oferecidas versões de 15 e 30 segundos: a versão de 15 segundos é ideal para apresentar rapidamente o enredo central, enquanto a de 30 segundos acrescenta ambientação, reações dos personagens e ações de clímax, tornando a história mais completa e dramática. Cada plano especifica as emoções, o tipo de enquadramento, o movimento de câmera e a narração necessária. Os personagens também recebem características visuais consistentes, ajudando a manter sua continuidade entre os planos e garantindo compatibilidade com modelos comuns de geração de vídeo. Todas as narrações são escritas em formato de dublagem (voz em off ou personagem falando), para que o modelo de vídeo realmente pronuncie as falas, em vez de renderizá-las como texto na tela. O estilo padrão é de animação cartunesca, mas você também pode especificar estilos visuais como pintura a tinta, recorte de papel, teatro de sombras ou realista, ou solicitar apenas uma das durações. O roteiro final é apresentado exclusivamente em chinês e inclui a atmosfera da cena, a aparência dos personagens, a composição dos planos e os requisitos de consistência. É adequado para produzir animações de expressões idiomáticas, histórias de fábulas, curtas com estética tradicional chinesa e vídeos sobre cultura tradicional voltados para crianças ou para o público geral.
 Vídeo
Checklist de Legendas
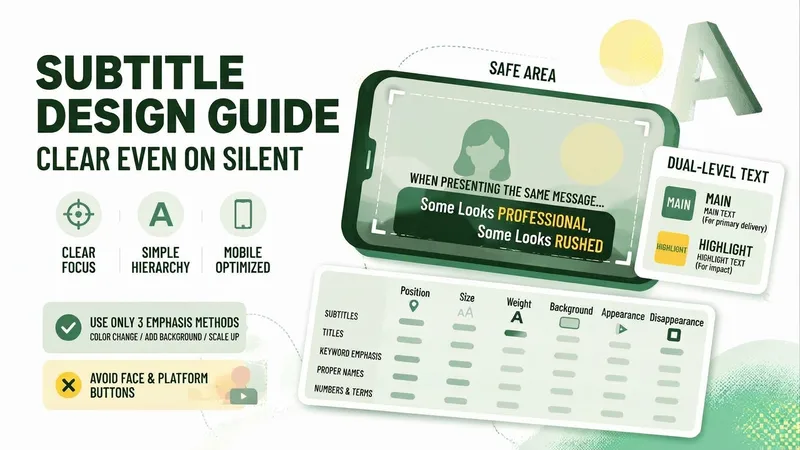
Para avaliar se uma legenda funciona, há apenas um critério: no celular, em tamanho reduzido e com o vídeo no mudo, ainda dá para entender a frase de imediato? O 【Checklist de layout de legendas】 começa com três regras rígidas: área segura (quanto deixar nas partes superior, inferior e laterais, com orientações separadas para vídeos verticais e horizontais), limite de caracteres por linha (e por que existe um limite para a quantidade de caracteres que se consegue ler em um segundo) e apenas dois níveis hierárquicos (texto principal e texto de destaque; um terceiro nível sempre gera confusão). Depois, traz uma tabela de parâmetros de layout pronta para preencher, com posição, tamanho relativo, peso da fonte, uso ou não de fundo e momento de entrada e saída para legendas, títulos, destaques de palavras-chave, nomes de pessoas e lugares, números e nomes próprios. A tabela também indica as áreas que devem ficar livres para não cobrir rostos nem botões da plataforma. Para destacar palavras-chave, há apenas três opções (mudar a cor, adicionar um fundo ou aumentar o tamanho), e é preciso escolher somente uma. Também inclui seis práticas que mais fazem o vídeo parecer amador e como corrigi-las, além de um método simples para verificar o resultado no celular com o vídeo no mudo. Regras rígidas: não escrever falas nem roteiros, não recomendar arquivos específicos de fontes, não ensinar formas de deformar ou ocultar texto para burlar a análise da plataforma, não avaliar a aparência ou o sotaque do usuário e não prometer uma taxa de conclusão.
Informações
- Versão
- v4
- Última atualização
- Créditos por execução
- Conforme o uso
- Modelos
- Automático
- Casos de uso
- Imagens e design
- O que você recebe
- ImagemDados