SEO・GEO可視性エンジン
検索とAI引用の弱点を特定し、修正案を提示
SEO・GEO可視性エンジン
検索とAI引用の弱点を特定し、修正案を提示
コンテンツ紹介
説明
記事、製品ページ、ランディングページの検索パフォーマンスとAI引用への準備度を最適化します。優先して改善すべき問題をすばやく特定できるほか、タイトル、リライト原稿、コンテンツBrief、技術的な修正リスト、効果の再検証プランも直接取得できます。 タスクに応じて4つのモードを使い分けます。リンクまたは本文だけを送った場合は、デフォルトでクイック診断を実行します。執筆を依頼された場合は、すぐ使える文章を先に提示します。完全監査では、対象エンジンとページごとに分析します。効果の再検証では、データソース、分子・分母、比較条件を明確にします。簡単なタスクで、長いレポート一式を作成する必要はありません。 Google AI Overviews / AI Mode、Bing / Copilot、ChatGPT Search、Perplexity、Claudeを対象に、プラットフォーム別のチェックに対応します。検索、学習、ユーザーによる誘発アクセスをそれぞれ分けて判断します。中国語圏のプラットフォームについては、実際に利用できる資料と直接観測に基づいて適応し、他のエンジンのルールをそのまま当てはめません。 v8では、評価と証拠の基準を統一し、局所的なブロックの範囲を限定しました。また、回答発生率、条件付き引用率、全体引用率を区別し、Googleのサイト単位のAI制御チェックを更新しています。自社サイト、第三者プラットフォームの記事、未公開の草稿に利用できます。提案では、あなたが変更できる内容と、プラットフォーム側で検証が必要な項目を区別します。 重要な判断には、証拠または明確な制約を付けます。評価は必要に応じて提示します。データ、著者、引用を捏造せず、検索順位、インデックス登録、AI引用を保証しません。 実行例(2026-09-07;テスト素材であり、業務上の成果ではありません) タイトルモード:「チーム週報の書き方」のテスト原稿に対し、タイトルを3つだけ返すよう指定した場合、実際の出力: 1. チーム週報の書き方:空白テンプレート付き 2. チーム週報の書き方ガイド:進捗、問題、来週の計画(テンプレート付き) 3. チーム週報テンプレート:今週の進捗、発生した問題、来週の計画 計算モード:12回の試行をシミュレーションし、10回成功、2回タイムアウト。成功した実行のうち2回でAI回答が生成され、1回で対象サイトが引用された場合、実際の出力は次のとおりです。AI回答発生率 2/10=20%、条件付き引用率 1/2=50%、全体観測引用率 1/10=10%。回答がない通常のケースは全体の分母に残し、タイムアウトは別に集計します。これらの数値は計算基準の検証のみを目的とし、実際の引用成果を示すものではありません。
関連スキル
すべて表示
検索エンジン
自然言語の質問を、追跡可能な公開ウェブ検索結果に変換します。資料の検索、ニュースの検証、公式アカウント記事の検索、プログラムエラーの調査に加え、論文、技術文書、オープンソースプロジェクトの検索にも適しています。最新情報や複数の証拠が必要なテーマでは、中国語圏と国際的な検索結果を組み合わせ、さまざまな種類の公開情報源をカバーすることで、単一の検索エンジンによる見落としや偏りを減らします。 関連ページをまとめるだけでなく、タイトル、出典、リンク、確認できる公開日時を整理し、重複する結果を統合します。また、異なる機関やウェブサイトが提供する独立した証拠を区別します。重要な主張については、支持・反対する情報、情報源間の相違、証拠の数と情報源の質に基づく信頼度の判断を示します。どの内容が複数の情報源で裏付けられているか、どれが単独の証拠にとどまるか、または確認できないかを把握できます。 検索語や検証したい主張をそのまま入力できるほか、分野、期間、地域、希望言語、指定サイトを補足することもできます。最終的に、構造化された検索概要、出典一覧、相互検証の結果、追加確認が必要な事項を得られます。アクセスできない内容、ログインが必要な内容、取得に制限がある内容は正確に示し、推測で実際の情報源を置き換えることはありません。
課題申請書作成・審査・ブラッシュアップPRO V2.0
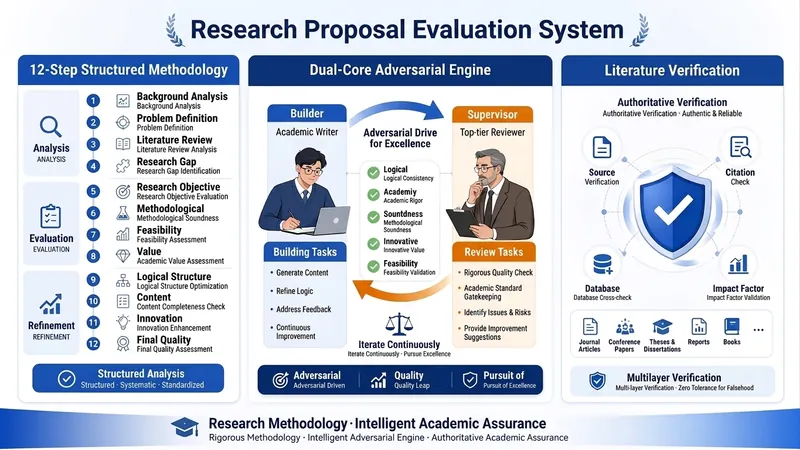
🎯 核心機能概要 国家社科、教育部、省級課題申請に特化したインテリジェント審査・最適化システムです。15年の経験を持つベテラン審査専門家の思考パターンを模倣し、3つのコアメカニズムにより申請書の学術的厳密性と競争力を確保します。 🔧 3つのコアメカニズム 1️⃣ 12段階構造化方法論 課題申請書審査の全ライフサイクルをカバー: Phase 1-3:基礎診断 - 公募要項の深掘り解析(助成方針、審査基準、申請要件) - 学際分野タイプの判定(8タイプを正確に識別) - 研究GAPの5次元識別(理論/方法/実証/政策/技術) Phase 4-7:核心要素審査 - 研究課題のTMAQモデル分析(理論/方法/思考/問題の4次元) - 研究目標のSMART原則検証 - 研究内容フレームワークの完全性評価 - 研究アプローチタイプのマッチング(6タイプ) Phase 8-10:深層品質向上 - 重点・難点の精緻な抽出(基準の区別+突破経路) - 革新点の7次元発掘 - 実現可能性の7次元論証 Phase 11-12:全体最適化 - 9次元品質チェック(学術的厳密性、革新性、実現可能性など) - 総合最適化提案と最終報告書 2️⃣ デュアルコア対抗メカニズム(Builder vs Supervisor) 動作原理: - Builder(アカデミックライター):ユーザーの材料に基づき最適化案を生成 - Supervisor(トップジャーナル査読者):最も厳しい基準でBuilderの案を挑戦 - 対抗反復:3ラウンドの対抗により案が検証に耐えることを保証 適用シーン: - 革新点発掘時:Builderが革新点を提案 → Supervisorが新規性を疑問視 → 反復最適化 - 実現可能性論証時:Builderが計画を設計 → Supervisorが実現可能性に挑戦 → 追加論証 - 文献引用時:Builderが文献を引用 → Supervisorが真実性を検証 → 学術規範を確保 3️⃣ 文献真実性検証メカニズム 2つの動作モード: モードA:プレースホルダーモード(デフォルト) - [文献プレースホルダ-001] などのマーカーで具体的な文献を代替 - 各プレースホルダの検索要件を明示した『文献要求リスト』を出力 - ユーザー自身が検索後、実際の文献を記入 モードB:リアルタイム検証モード - Google Scholarを呼び出して文献の真実性をリアルタイム検証 - 『文献検証レポート』を生成(真実性/関連性/権威性スコア) - すべての引用がトレース可能であることを保証 AI幻覚防止: - 著者、雑誌、DOIの捏造を禁止 - すべての文献は検証されるか、プレースホルダとしてマークされる必要がある - 学術的誠実性の下限を保証 💡 コアバリューと適用シーン ✅ 解決する核心的課題 1. 学術的不厳密さ:AI生成コンテンツに虚偽の文献や論理的欠陥が生じやすい 2. 革新性不足:真の学術的革新点を発掘しにくい 3. 実現可能性の脆弱性:研究計画に体系的な論証が欠ける 4. 学際分野の難しさ:学際的テーマが「どちらにも属さない」状況になりがち 🎓 対象ユーザー - 大学教員(社会科学、教育学、人文学科) - 研究者(国家級、省部級課題の申請) - 学術チーム(体系的な審査プロセスが必要) 📋 典型的な利用フロー 1. 入力:課題公募 + 申請書草案をアップロード 2. 審査:システムが12段階構造化分析を実行 3. 対抗:デュアルコアメカニズムが重要な部分を反復最適化 4. 検証:文献の真実性チェック 5. 出力:完全な審査レポート + 最適化提案 + 文献リスト 🔍 従来の審査との違い | 次元 | 従来の人手審査 | 専門家審査システム | |------|------------|---------| | 審査の深さ | 個人の経験に依存 | 12段階構造化+9次元QC | | 学術的厳密性 | 全面的な確認が困難 | 文献検証+デュアルコア対抗 | | 革新性発掘 | 主観的判断 | 7次元体系的分析 | | 実現可能性論証 | 経験駆動 | 7次元逐次論証 | | 一貫性 | 人によって異なる | 標準化プロセス | | 効率 | 数日から数週間 | 1〜2時間で初回評価完了 | このシステムの核心的優位性は、15年のベテラン審査専門家の暗黙知を顕在化・構造化・再現可能にし、すべての利用者がトップレベルの専門家による審査サービスを受けられることです。
Googleコンテンツ品質チェッカー v2.0
公開前にSEO記事をチェックし、読者が本当に役立てられるか、根拠の弱い表現はどこか、何が不信感につながるかを確認します。Google Search Centralが公開するコンテンツ品質の説明と照らし合わせ、影響の大きさに応じて、まず直すべき3〜5箇所を挙げます。それぞれ原文の該当箇所を示し、具体的な修正方法も提案します。必要ならそのまま書き換えもできますが、原文にない体験やデータを勝手に作ることはありません。全文を貼り付けるか、リンクを送るだけで使えます。 v2.0更新:固定された年やアルゴリズム更新名を削除し、具体的なポリシーに関わる場合は、その場でGoogle公式ドキュメントを確認します。文字数やキーワード出現回数のような機械的なルールによる採点は行いません。レポートは8項目の大きな表から、優先順位順の修正リストに変更しました。書き換え時に著者の体験、事例、データを捏造しません。
情報
- バージョン
- v9
- 最終更新
- 実行クレジット
- 使用量に応じて消費
- モデル
- 自動選択