Moteur de visibilité SEO+GEO
Lacunes SEO et IA, contenus prêts à l’emploi
Moteur de visibilité SEO+GEO
Lacunes SEO et IA, contenus prêts à l’emploi
Aperçu
Description
Optimisez les performances dans les moteurs de recherche et la préparation aux citations par l’IA de vos articles, pages produit et pages d’atterrissage. Identifiez rapidement les problèmes les plus importants à corriger et obtenez directement des titres, des réécritures, des briefs de contenu, des listes de corrections techniques ou un plan de nouvelle mesure des résultats. Quatre modes orientent l’analyse selon la tâche : envoyez seulement un lien ou le texte pour obtenir par défaut un diagnostic rapide ; demandez une rédaction pour recevoir d’abord un texte utilisable ; choisissez l’audit complet pour une analyse par moteur cible et par page ; utilisez la nouvelle mesure des résultats pour préciser les sources de données, le numérateur, le dénominateur et les conditions de comparaison. Les tâches simples ne nécessitent pas un long rapport complet. L’outil prend en charge les vérifications spécifiques à Google AI Overviews / AI Mode, Bing / Copilot, ChatGPT Search, Perplexity et Claude. Les accès déclenchés par la recherche, l’entraînement et les utilisateurs sont évalués séparément ; pour les plateformes chinoises, l’analyse s’adapte aux informations réellement disponibles et aux observations directes, sans appliquer les règles d’autres moteurs. La v8 uniformise les critères de notation et de preuve, limite la portée des blocages locaux, distingue le taux de déclenchement d’une réponse, le taux de citation conditionnel et le taux de citation global, et met à jour la vérification des contrôles IA au niveau du site Google. Utilisez-la pour vos propres sites, des articles publiés sur des plateformes tierces ou des brouillons non publiés. Les recommandations distinguent ce que vous pouvez modifier des éléments à vérifier du côté des plateformes. Chaque conclusion importante est accompagnée de preuves ou de limites clairement indiquées. La notation est fournie au besoin ; aucune donnée, aucun auteur ni aucune citation ne sont inventés, et aucun classement, référencement ou citation par l’IA n’est garanti. Exemple d’exécution réelle (2026-09-07 ; contenu de test, pas un résultat commercial) Mode titres : pour un texte de test sur « comment rédiger le rapport hebdomadaire d’une équipe », la consigne demandait de renvoyer uniquement 3 titres. Résultat : 1. Comment rédiger le rapport hebdomadaire d’une équipe ? Avec modèle vierge 2. Guide de rédaction du rapport hebdomadaire d’une équipe : avancement, problèmes et plan pour la semaine prochaine (avec modèle) 3. Modèle de rapport hebdomadaire d’une équipe : avancement de la semaine, problèmes rencontrés, plan pour la semaine prochaine Mode calcul : sur 12 tentatives simulées, 10 ont réussi et 2 ont expiré ; parmi les exécutions réussies, 2 ont généré une réponse IA et 1 a cité le site cible. Résultat : taux de déclenchement d’une réponse IA 2/10 = 20 %, taux de citation conditionnel 1/2 = 50 %, taux de citation observé global 1/10 = 10 %. Les exécutions sans réponse sont conservées dans le dénominateur global et les délais d’expiration sont comptés séparément ; ces valeurs vérifient uniquement les critères de calcul et ne représentent pas un véritable taux de citation.
Compétences associées
Tout voir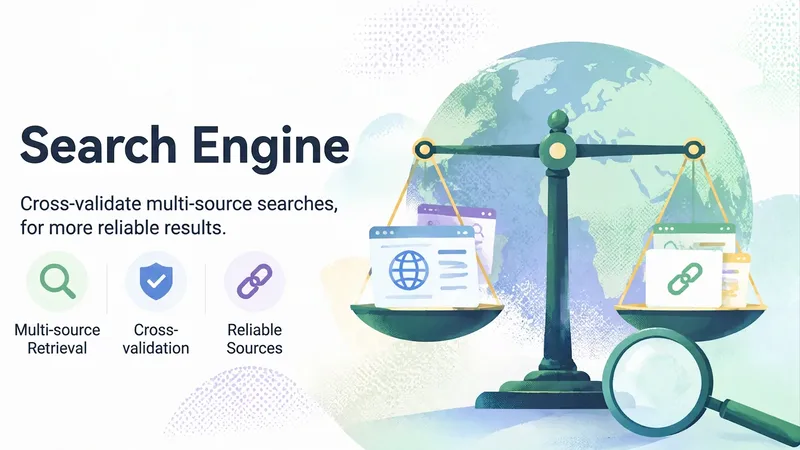
Moteur de recherche
Transforme les questions en langage naturel en résultats de recherche sur le Web public, avec des sources traçables. Il convient pour rechercher des informations, vérifier des faits, trouver des articles de comptes officiels, résoudre des erreurs de programmation et rechercher des articles scientifiques, de la documentation technique ou des projets open source. Pour les sujets nécessitant des informations récentes ou des preuves provenant de plusieurs sources, il combine des résultats de recherche chinois et internationaux et couvre différents types de sources publiques afin de réduire les omissions et les biais liés à un seul moteur de recherche. En plus de regrouper les pages pertinentes, il organise les titres, les sources, les liens et les dates de publication disponibles, fusionne les résultats en double et distingue les preuves indépendantes fournies par différents organismes ou sites. Pour les affirmations importantes, les résultats présentent les informations qui les soutiennent ou les contredisent, les divergences entre les sources, ainsi qu’une évaluation de la fiabilité fondée sur le nombre de preuves et la qualité des sources. Vous voyez ainsi clairement quels éléments sont confirmés par plusieurs sources et lesquels reposent encore sur un témoignage isolé ou ne peuvent pas être confirmés. Vous pouvez saisir directement des termes de recherche ou une affirmation à vérifier, et préciser le domaine, la période, la région, la langue souhaitée ou des sites particuliers. Vous obtenez finalement un résumé structuré de la recherche, une liste de sources, les résultats de la vérification croisée et les points à confirmer. Les contenus inaccessibles, nécessitant une connexion ou soumis à des restrictions de collecte sont signalés fidèlement, sans remplacer les sources réelles par des suppositions.
Optimisation de prop. PRO V2.0
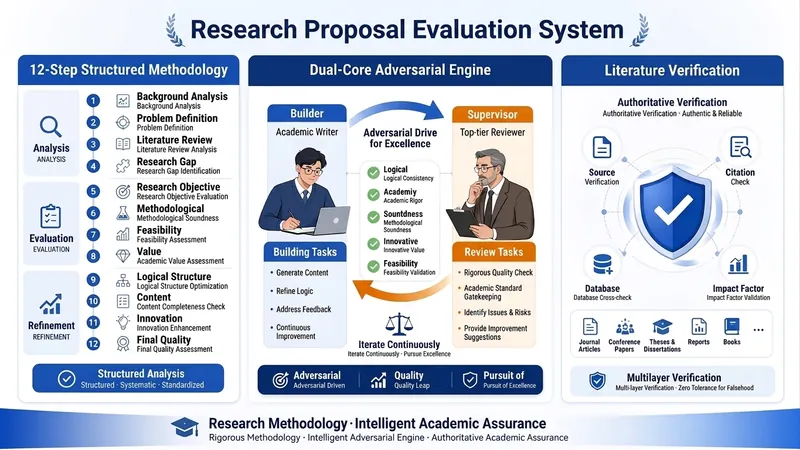
🎯 Présentation des fonctionnalités principales Il s'agit d'un système intelligent d'évaluation et d'optimisation conçu spécifiquement pour les propositions de projets CNSF, MEN et provinciaux. Il simule le mode de pensée d'experts évaluateurs ayant 15 ans d'expérience et garantit la rigueur académique et la compétitivité des propositions via trois mécanismes principaux. 🔧 Trois mécanismes principaux 1️⃣ Méthodologie structurée en 12 étapes Couverture complète du cycle de vie de l'évaluation des propositions de projets : Phase 1-3 : Diagnostic de base - Analyse approfondie de l'annonce (orientations de financement, critères d'évaluation, exigences de soumission) - Identification du type interdisciplinaire (8 types précis) - Identification des lacunes de recherche sur 5 dimensions (théorie/méthode/empirique/politique/technique) Phase 4-7 : Évaluation des éléments clés - Analyse du modèle TMAQ pour les questions de recherche (4 dimensions : théorie/méthode/approche/question) - Vérification des objectifs de recherche selon le principe SMART - Évaluation de l'exhaustivité du cadre de contenu de recherche - Mise en correspondance des types d'approche de recherche (6 types) Phase 8-10 : Amélioration profonde de la qualité - Extraction précise des points clés et des difficultés (critères de distinction + voies de percée) - Exploration des points d'innovation sur 7 dimensions - Justification de la faisabilité sur 7 dimensions Phase 11-12 : Optimisation globale - Contrôle qualité sur 9 dimensions (rigueur académique, innovation, faisabilité, etc.) - Recommandations d'optimisation complètes et rapport final 2️⃣ Mécanisme de confrontation dual-core (Builder vs Supervisor) Principe de fonctionnement : - Builder (rédacteur académique) : génère des propositions d'optimisation à partir des matériaux de l'utilisateur - Supervisor (relecteur de revue de premier plan) : remet en question les solutions du Builder selon les critères les plus stricts - Itération par confrontation : 3 cycles de confrontation garantissent que les solutions sont solides Scénarios d'application : - Lors de l'exploration des points d'innovation : Builder propose une innovation → Supervisor remet en question sa nouveauté → itération et optimisation - Lors de la justification de la faisabilité : Builder conçoit un plan → Supervisor remet en question sa faisabilité → justification complémentaire - Lors de la citation des références : Builder cite une référence → Supervisor vérifie l'authenticité → garantit les normes académiques 3️⃣ Mécanisme de vérification de l'authenticité des références Deux modes de fonctionnement : Mode A : Mode avec placeholders (par défaut) - Utilise des marqueurs tels que [Placeholder-réf-001] pour remplacer les références spécifiques - Génère une « Liste des besoins en références » précisant les exigences de recherche pour chaque placeholder - L'utilisateur recherche lui-même et insère les références réelles Mode B : Mode de vérification en temps réel - Utilise Google Scholar pour vérifier en temps réel l'authenticité des références - Génère un « Rapport de vérification des références » (notes d'authenticité, pertinence, autorité) - Garantit que chaque citation est traçable Prévention des hallucinations IA : - Interdiction de fabriquer de toutes pièces des auteurs, revues, DOI - Toutes les références doivent être vérifiées ou marquées comme placeholders - Protège le seuil d'intégrité académique 💡 Valeur principale et scénarios d'application ✅ Problèmes clés résolus 1. Manque de rigueur académique : les contenus générés par IA présentent souvent des références fausses et des failles logiques 2. Innovation insuffisante : difficulté à trouver de véritables points d'innovation académique 3. Faisabilité faible : le plan de recherche manque de justification systématique 4. Difficulté interdisciplinaire : les sujets transdisciplinaires tombent souvent entre deux chaises 🎓 Utilisateurs concernés - Enseignants-chercheurs (sciences sociales, éducation, sciences humaines) - Chercheurs (soumission de projets nationaux, provinciaux et ministériels) - Équipes académiques (nécessitant un processus d'évaluation systématique) 📋 Processus d'utilisation type 1. Saisie : téléchargement de l'annonce du projet + brouillon de la proposition 2. Évaluation : le système effectue une analyse structurée en 12 étapes 3. Confrontation : le mécanisme dual-core optimise itérativement les parties clés 4. Vérification : contrôle de l'authenticité des références 5. Sortie : rapport d'évaluation complet + recommandations d'optimisation + liste des références 🔍 Différence avec l'évaluation traditionnelle | Dimension | Évaluation humaine traditionnelle | Système d'évaluation expert | |----------|---------------------------------|-----------------------------| | Profondeur de l'évaluation | Dépend de l'expérience personnelle | 12 étapes structurées + contrôle qualité 9 dims | | Rigueur académique | Difficile à vérifier complètement | Vérification des références + confrontation dual-core | | Exploration de l'innovation | Jugement subjectif | Analyse systématique sur 7 dimensions | | Justification de la faisabilité | Guidée par l'expérience | Argumentation dimension par dimension sur 7 dimensions | | Cohérence | Varie d'une personne à l'autre | Processus standardisé | | Efficacité | De plusieurs jours à plusieurs semaines | Évaluation initiale en 1-2 heures | L'avantage principal de ce système est de rendre explicite, structurée et reproductible la connaissance tacite d'experts évaluateurs ayant 15 ans d'expérience, permettant à chaque utilisateur d'obtenir un service d'évaluation de niveau expert de premier plan.
Contrôle qualité Google v2.0
Avant publication, vérifiez une article SEO : les lecteurs peuvent-ils réellement l’utiliser, quelles affirmations sont fragiles et quels passages risquent de paraître peu crédibles ? En s’appuyant sur les recommandations publiques de Google Search Central concernant la qualité des contenus, l’outil liste les 3 à 5 corrections les plus importantes, par ordre d’impact. Chaque point renvoie à l’emplacement concerné dans le texte et propose une amélioration concrète. Si vous le souhaitez, il peut aussi réécrire directement le contenu, sans inventer d’expériences ni de données absentes de l’original. Collez le texte complet ou envoyez simplement son lien. Mise à jour v2.0 : suppression des années et des noms de mises à jour d’algorithme codés en dur ; consultation des documents officiels de Google au moment de l’analyse lorsqu’une règle précise est concernée ; abandon des critères mécaniques comme le nombre de mots ou la fréquence des mots-clés ; transformation du rapport, auparavant présenté sous forme de tableau en 8 dimensions, en une liste de corrections classées par priorité ; lors des réécritures, aucune expérience d’auteur, étude de cas ni donnée n’est inventée.
Informations
- Version
- v9
- Dernière mise à jour
- Crédits par exécution
- Selon l’utilisation
- Modèles
- Automatique