Comment transformer un PDF, des pages web et des notes en présentation client avec YouMind (Guide complet)
À lire aussi : Choisir un Skill de présentation → 10 Skills pour des decks professionnels. Finaliser un deck à partir de vos propres documents → cet article.
Ce que ce tutoriel résout (30 secondes)
Vous avez déjà un rapport PDF, deux pages de référence et vos propres notes. Il vous faut une présentation de briefing livrable en quelques heures — pas un énième aperçu en cinq étapes du type « collecter → structurer → générer → modifier → exporter ».
Cet article déroule un cas réel YouMind de bout en bout : liste des sources, ce que nous avons supprimé, les erreurs du premier brouillon, les corrections page par page, un choix de style que nous avons rejeté et les limites d’export à connaître avant de promettre un « PowerPoint modifiable ». À la fin, vous devriez pouvoir reproduire le parcours avec votre PDF et vos notes — et savoir quoi corriger après la génération.
Contexte (fixe) : un briefing interne de type collaborateur du savoir / conseiller. Dans cette démo, le briefing demande quels deux workflows IA une petite équipe de contenu pourrait tester le mois prochain. Nous n’abordons pas ici les cas d’usage étudiants, pitchs ou formations ; pour explorer les Skills et les styles, utilisez la collection liée ci-dessus.
Configuration du cas et liste des sources
- **Objectif** — Proposer deux pilotes de workflow IA de quatre semaines à un responsable de contenu et aux rédacteurs ; clarifier ce qui relève de l’humain et comment décider de poursuivre ou non
- **Public — Petite équipe de contenu · ~10 minutes · 8 slides en anglais**
- **Niveau d’exigence** — Longueur maîtrisée, affirmations prêtes pour la scène, chaque chiffre clé traçable jusqu’à sa source — aucun client, effectif, budget ou « temps gagné » inventé
- **Étiquette** — Démonstration pédagogique à partir de sources publiques — ni mission client, ni plan interne validé
Sources
- Source : Microsoft 2026 Work Trend Index (PDF) · Rôle : Principale · Résultat : Conservée ; numéros de page imprimés utilisés pour les vérifications
- Source : Anthropic Economic Index: Cadences (web) · Rôle : Secondaire · Résultat : Conservée ; citée par chapitre
- Source : Stanford 2026 AI Index — Economy (web) · Rôle : Support prévu · Résultat : Exclue — la capture ne contenait que la navigation/CSS, sans corps de texte
- Source : Brief projet / Notes de recherche / Brief original · Rôle : Affirmation, interdictions, public · Résultat : Conservée ; configuration démarrée en chinois, livraison verrouillée en anglais avant la génération des slides
Trois questions à se poser avant de générer (jugement n°0)
Notez-les d’abord. Chaque suppression ultérieure en dépend.
- Quelle décision le public doit-il prendre ? Valider deux pilotes de quatre semaines — et leurs règles d’arrêt — avant que quiconque ne commence.
- Quelle affirmation défendons-nous ? Les données d’usage justifient de lancer un petit test, pas de prévoir des économies. Les deux workflows sont des propositions ; rien n’a encore été mesuré.
- Qu’est-ce qui est interdit ? Clients, effectifs, budgets ou gains d’efficacité inventés ; généralisation des utilisateurs d’un produit à tout un secteur ; tout chiffre sans source, population et dénominateur.
Un dernier arbitrage pour ce parcours : la note de tâche initiale et le plan préliminaire étaient en chinois. Avant de générer les slides, la langue de livraison a été verrouillée en anglais ; le brief projet en anglais prime sur la note précédente.
Des sources au plan : ce qui est resté, ce que nous avons jeté
Rassembler le PDF, les pages et les notes sur un même Board est la partie facile. Le plan est là où le temps file — dans la sélection, pas dans la mise en page.
Supprimé (volontairement, avec trace)
- Chapitre Economy de Stanford : corps de texte illisible → exclu de l’argumentation et signalé comme limite d’importation sur le deck et dans les notes de recherche. Aucune supposition.
- Une douzaine de pourcentages « disponibles mais non essentiels » (répartition des outputs, gains déclarés, comparaisons salariales, etc.) → retirés pour éviter que le deck ne devienne un musée des statistiques.
- Fenêtres précises de collecte des enquêtes → les notes sources se contredisaient ; le deck mentionne uniquement « enquête 2026 ».
- Présenter le pilote 1 comme une « délégation » sans relecture et le pilote 2 comme la réécriture de l’article original en un « second brouillon » → corrigé : les deux pilotes exigent une relecture éditoriale ; le pilote 2 part d’un contenu validé et ne réécrit jamais l’article source.
- Formuler 49 % comme « de toutes les conversations » → corrigé selon la note du graphique : part des objectifs utilisateur classifiés (Microsoft WTI, p.08 imprimée) — ni temps, ni nombre de sessions.
Seuls deux faits ont survécu jusqu’aux slides
- F1 : Dans les conversations Copilot échantillonnées, 49 % des objectifs utilisateur classifiés soutiennent le travail cognitif (analyse, résolution de problèmes, évaluation, pensée créative, etc.). Source : Microsoft 2026 Work Trend Index, p.08. Dénominateur : objectifs utilisateur classifiés.
- F2 : Parmi les conversations Claude classées comme professionnelles, les documents et rapports sont l’artefact le plus fréquent, à environ 20 %. Source : Anthropic Cadences, chapitre 2. Dénominateur : conversations classées professionnelles.
Les dénominateurs différents restent sur des panneaux séparés. Nous ne les fusionnons jamais dans une promesse d’économies.
Règle du plan : une affirmation par slide ; signaler les preuves manquantes ; se limiter à huit slides pour dix minutes de présentation.
Comment ce cas a réellement généré le deck
- Étape : Premier brouillon · Ce que nous avons fait : conversation du Board « Build the Content Team Pilot Deck » (pas un Skill « Architect PRO » distinct — ne le nommez pas ici)
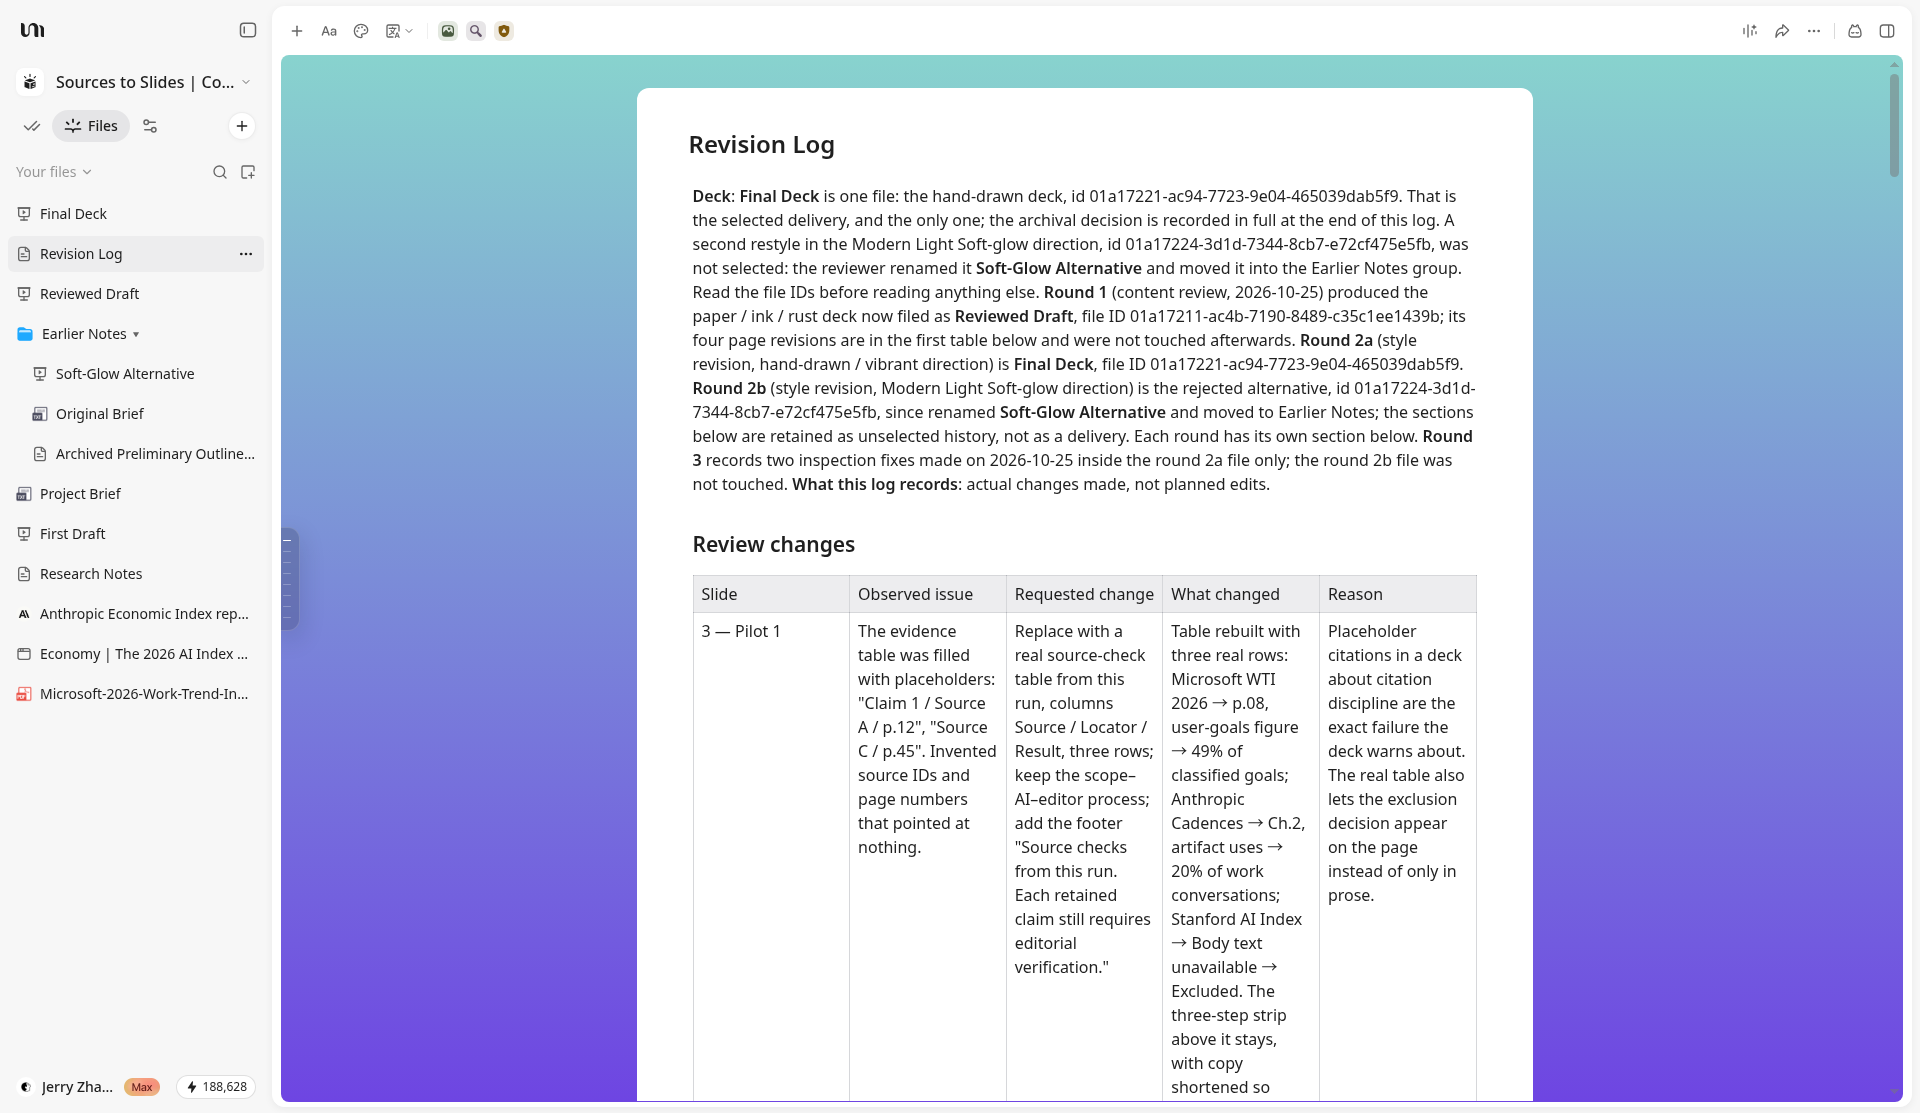
- Étape : Révision du contenu · Ce que nous avons fait : Round 1 → Brouillon révisé (corrections de contenu page par page)
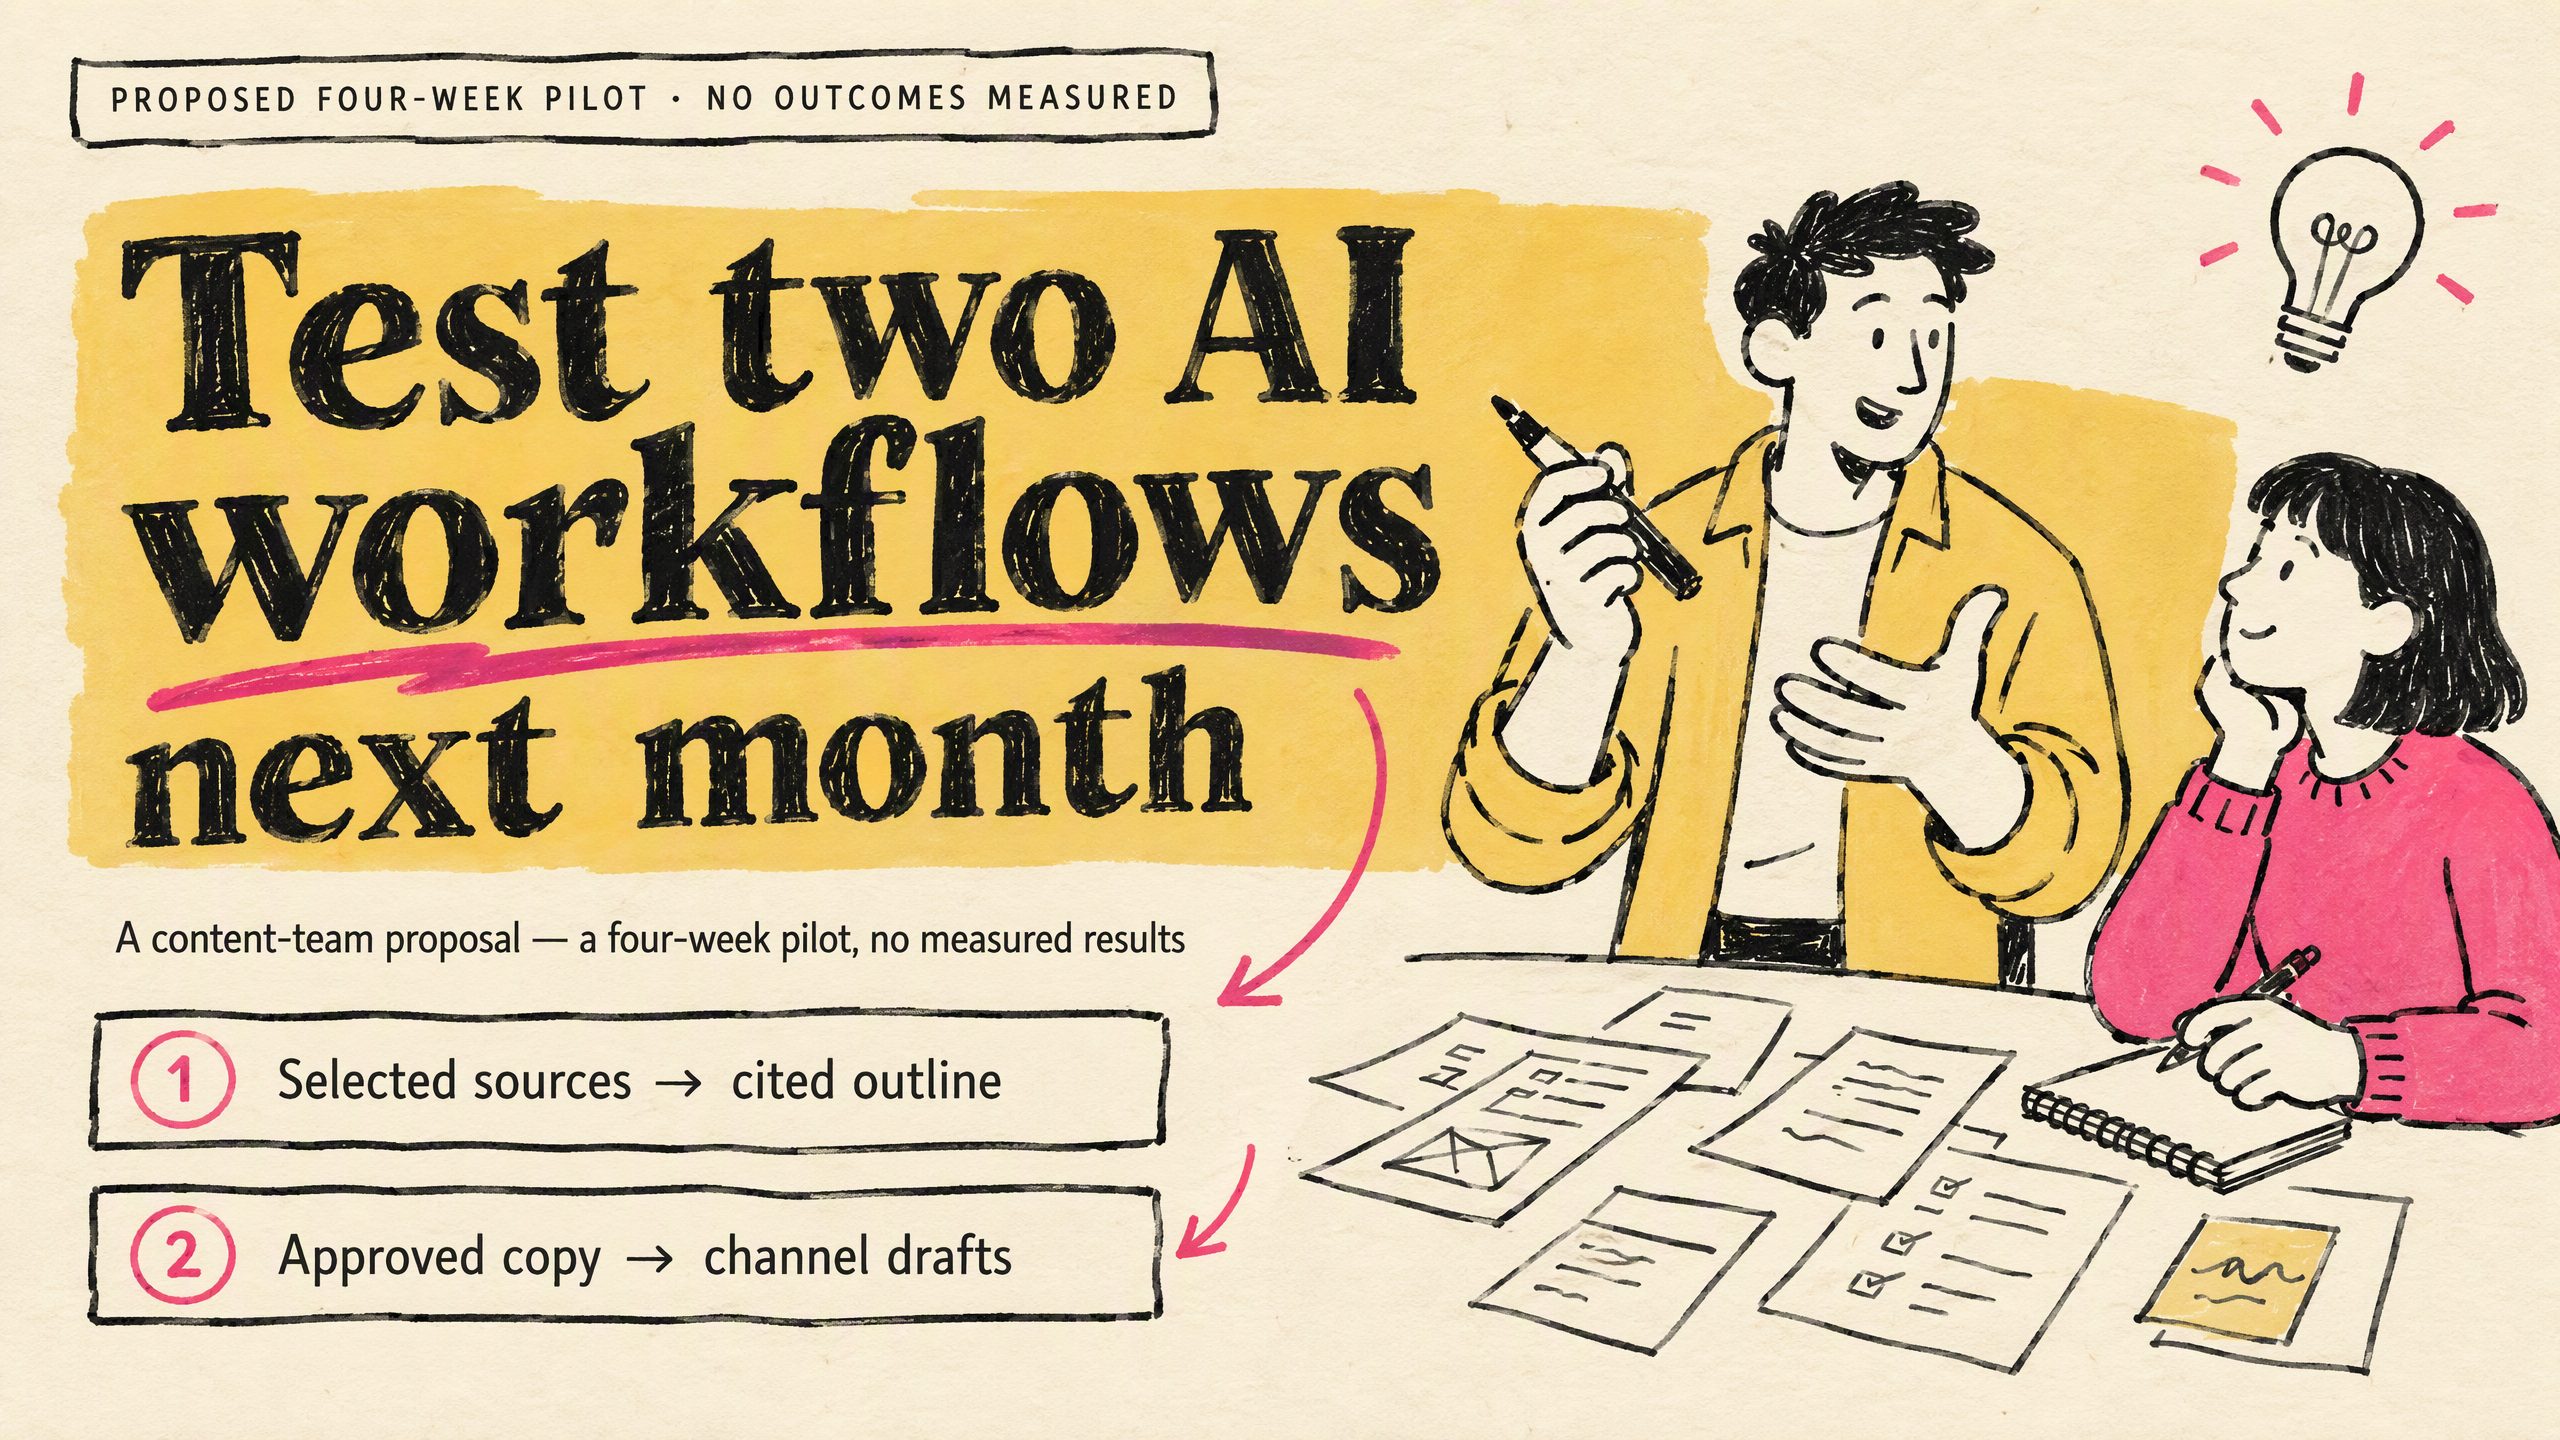
- Étape : Visuel final · Ce que nous avons fait : refonte complète avec le Skill Vibrant handdrawn for young professional (v1) → Deck final
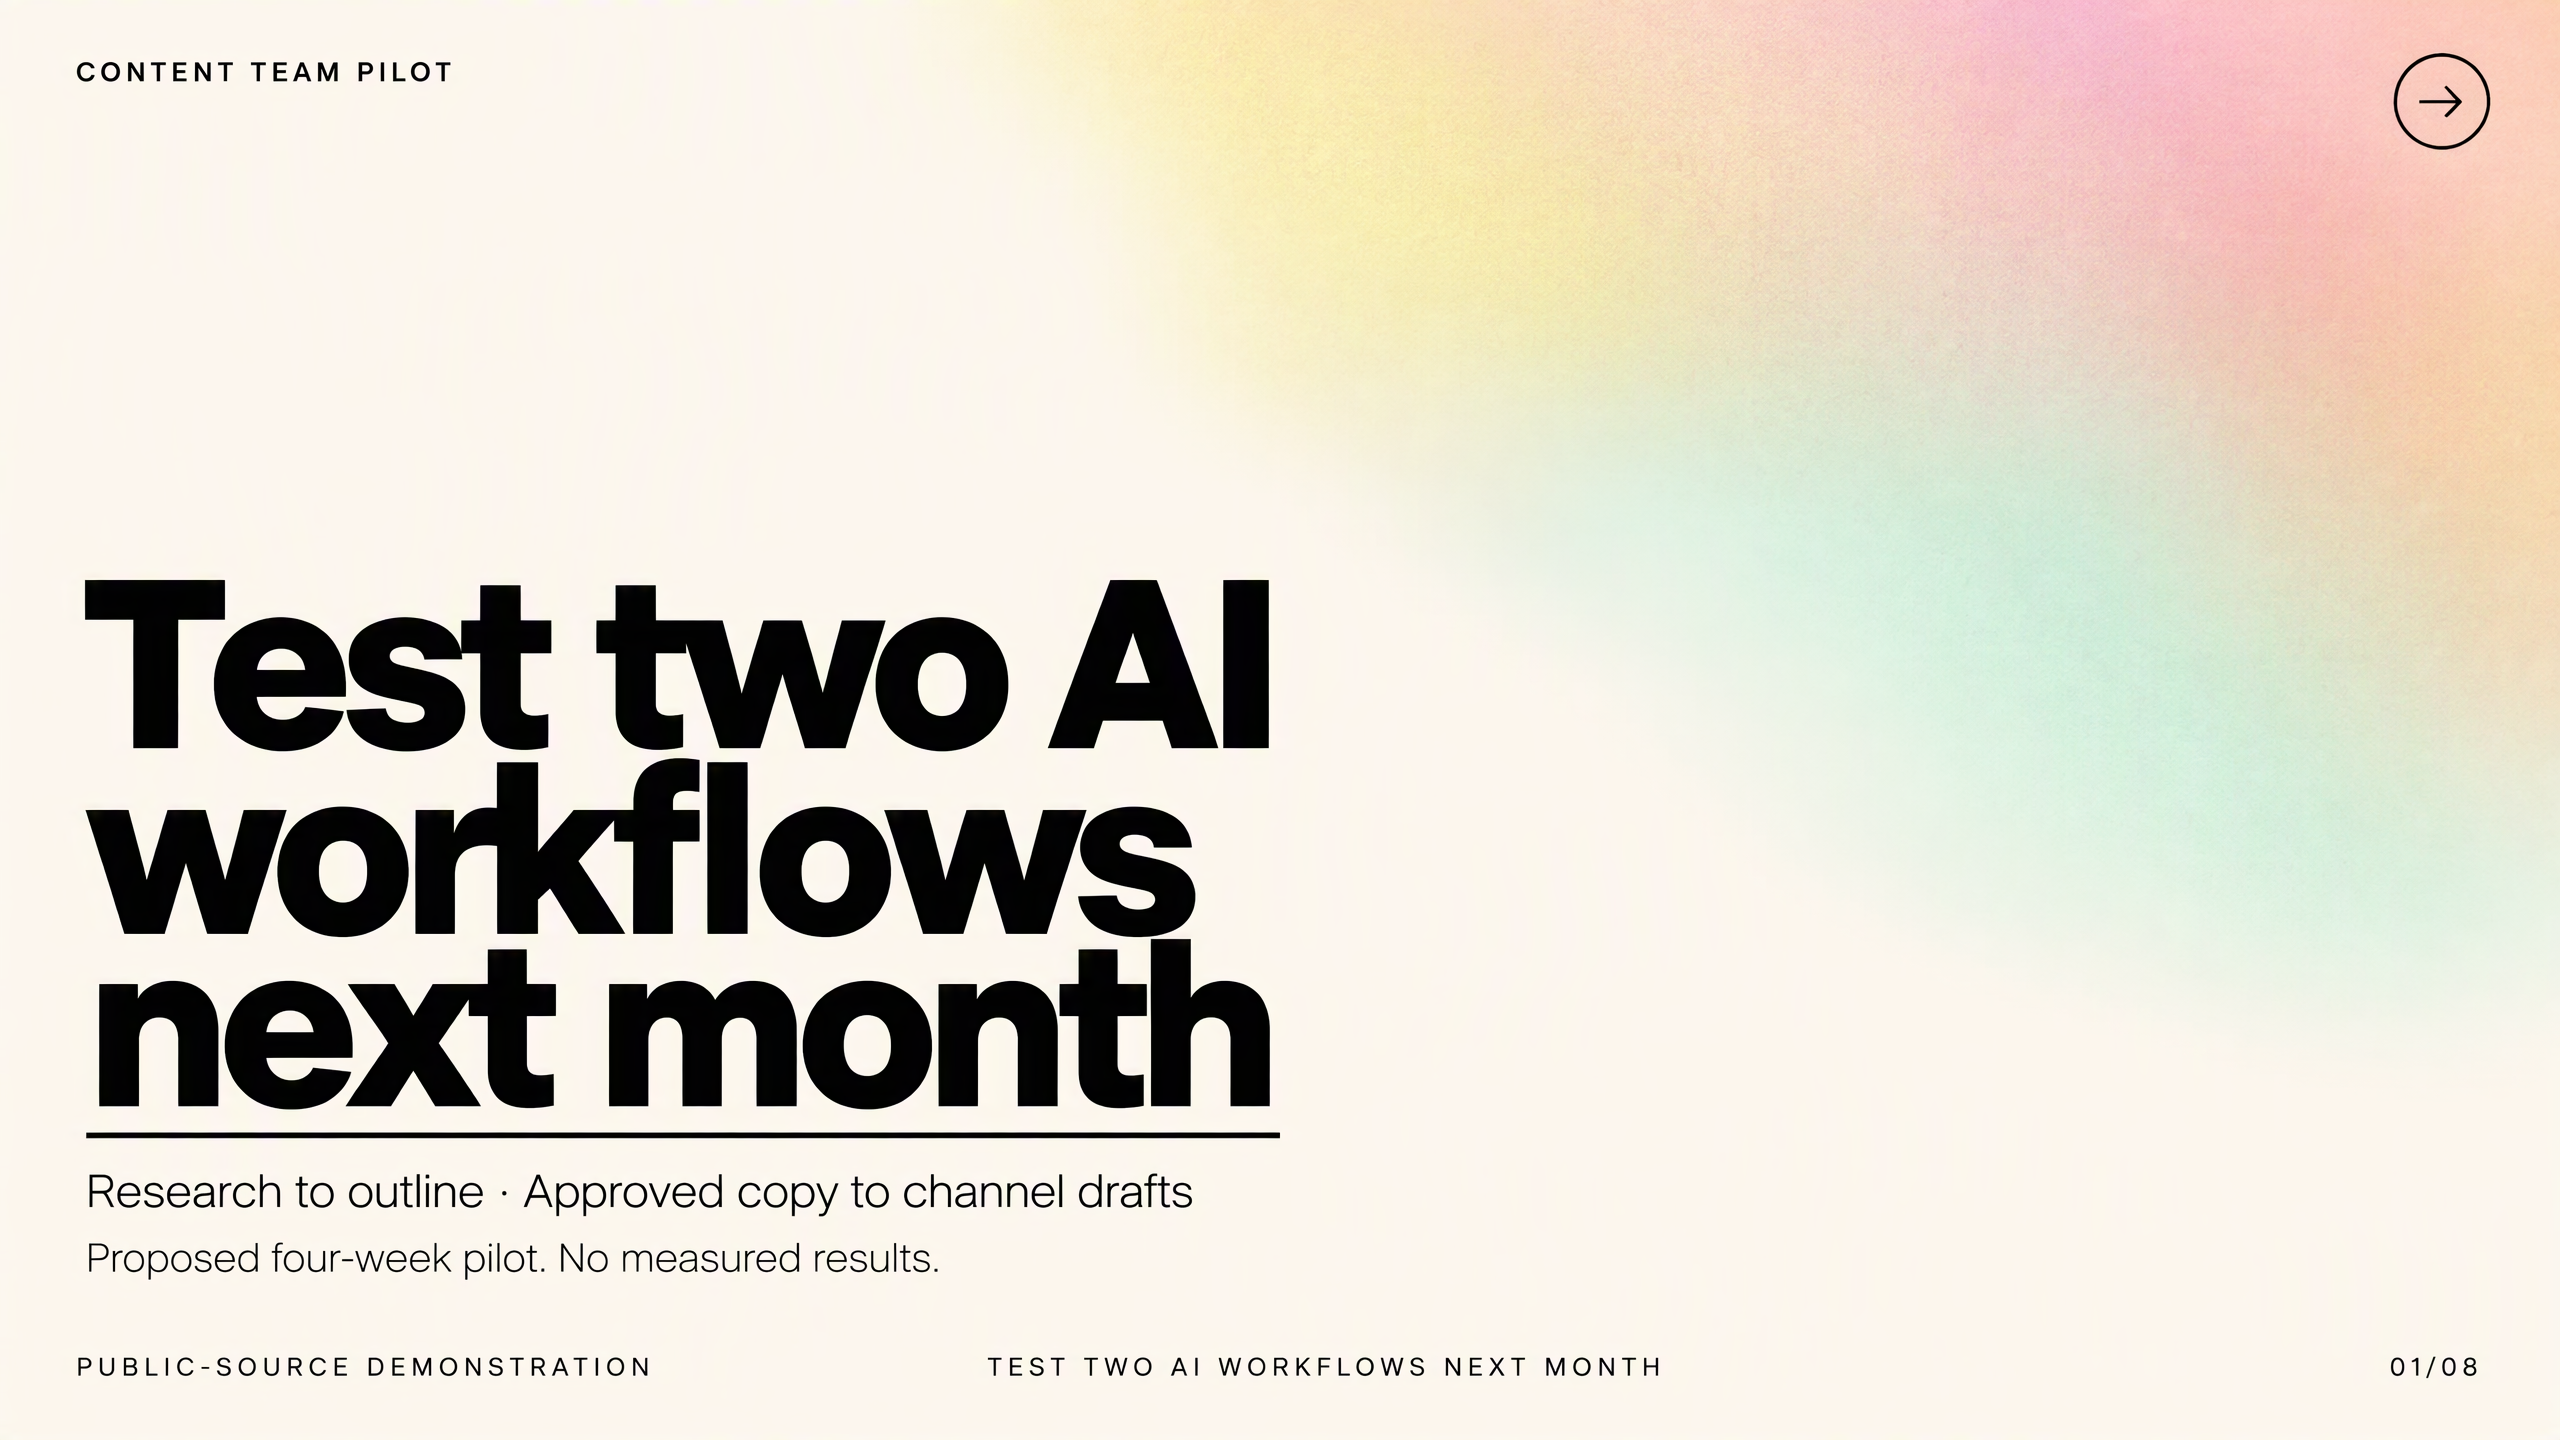
- Étape : Alternative rejetée · Ce que nous avons fait : Skill Modern Light Soft-glow (v9) → renommé Alternative Soft-Glow, déplacé vers les notes antérieures
Si vous devez encore choisir un style ou un Skill pour un autre projet, utilisez la collection de Skills et la galerie de Skills. Les tâches planifiées et le principe « même Board, autres formats » n’auront droit qu’à une phrase ici — ils ne constituent pas la colonne vertébrale.
À quoi ressemblait le premier brouillon
Le premier brouillon possédait déjà une structure complète de huit pages en anglais — et n’était pourtant pas livrable.
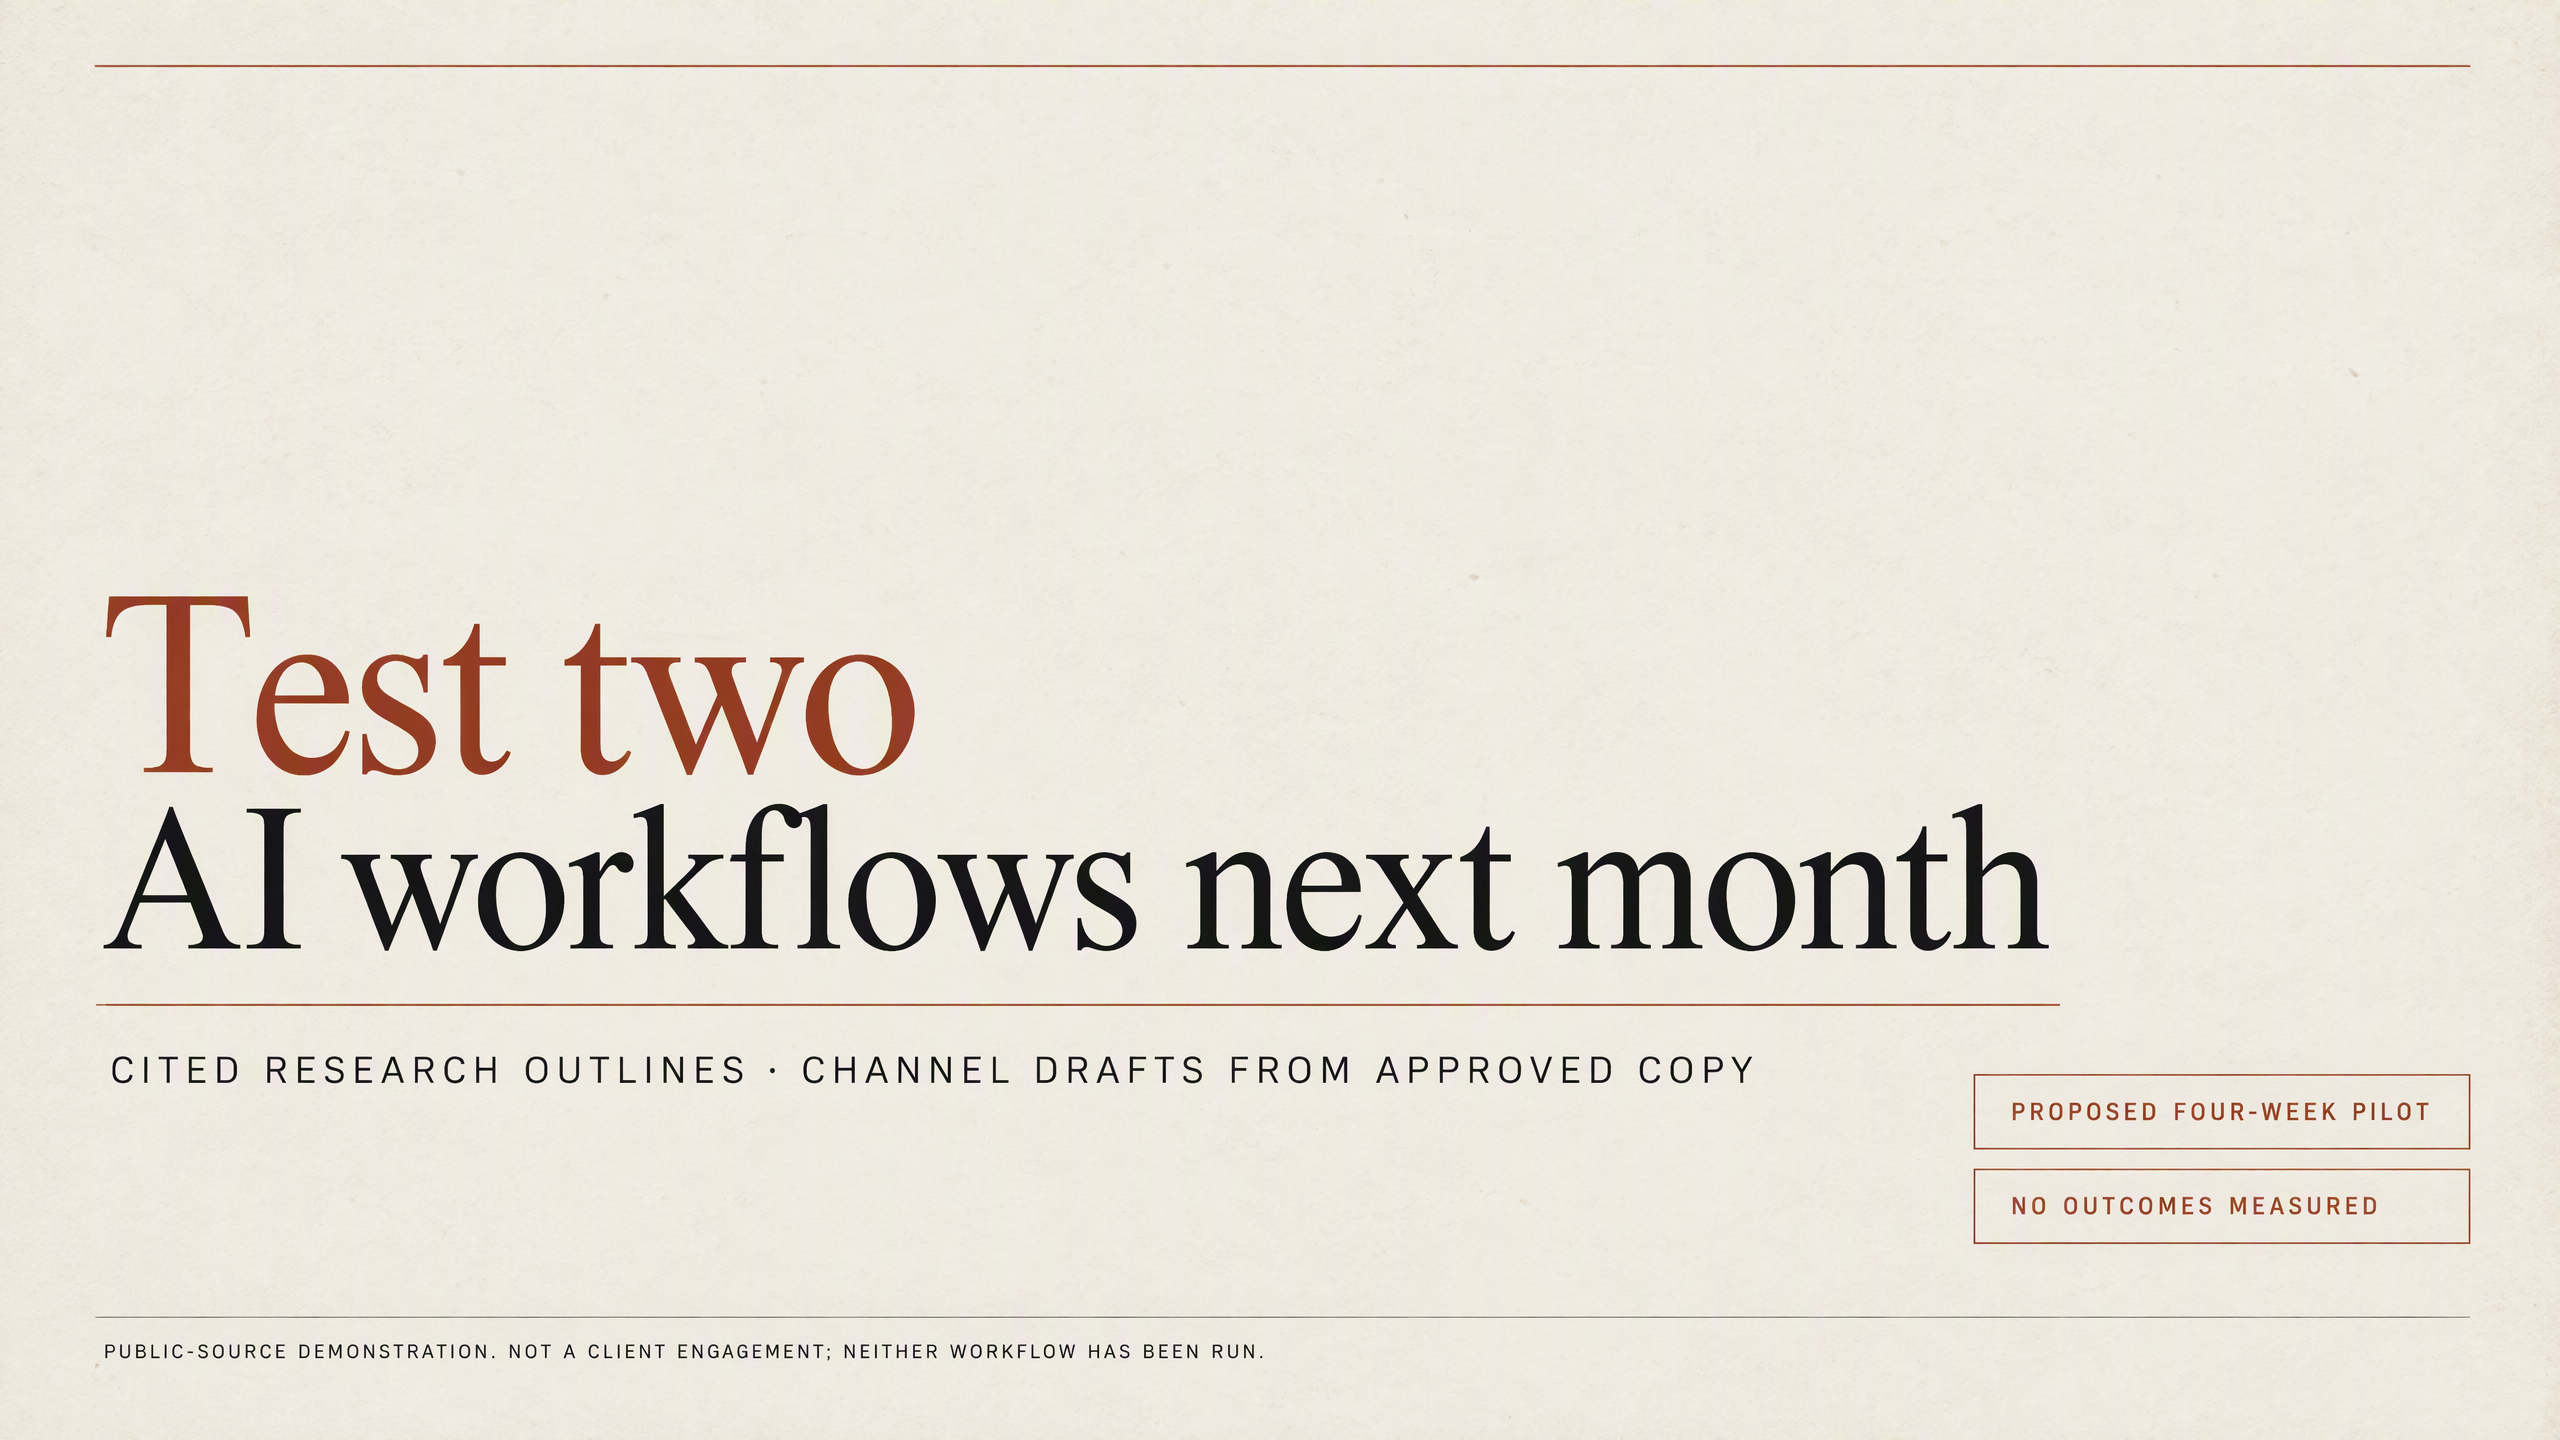
- La couverture et les pages de recommandation semblaient relativement propres.
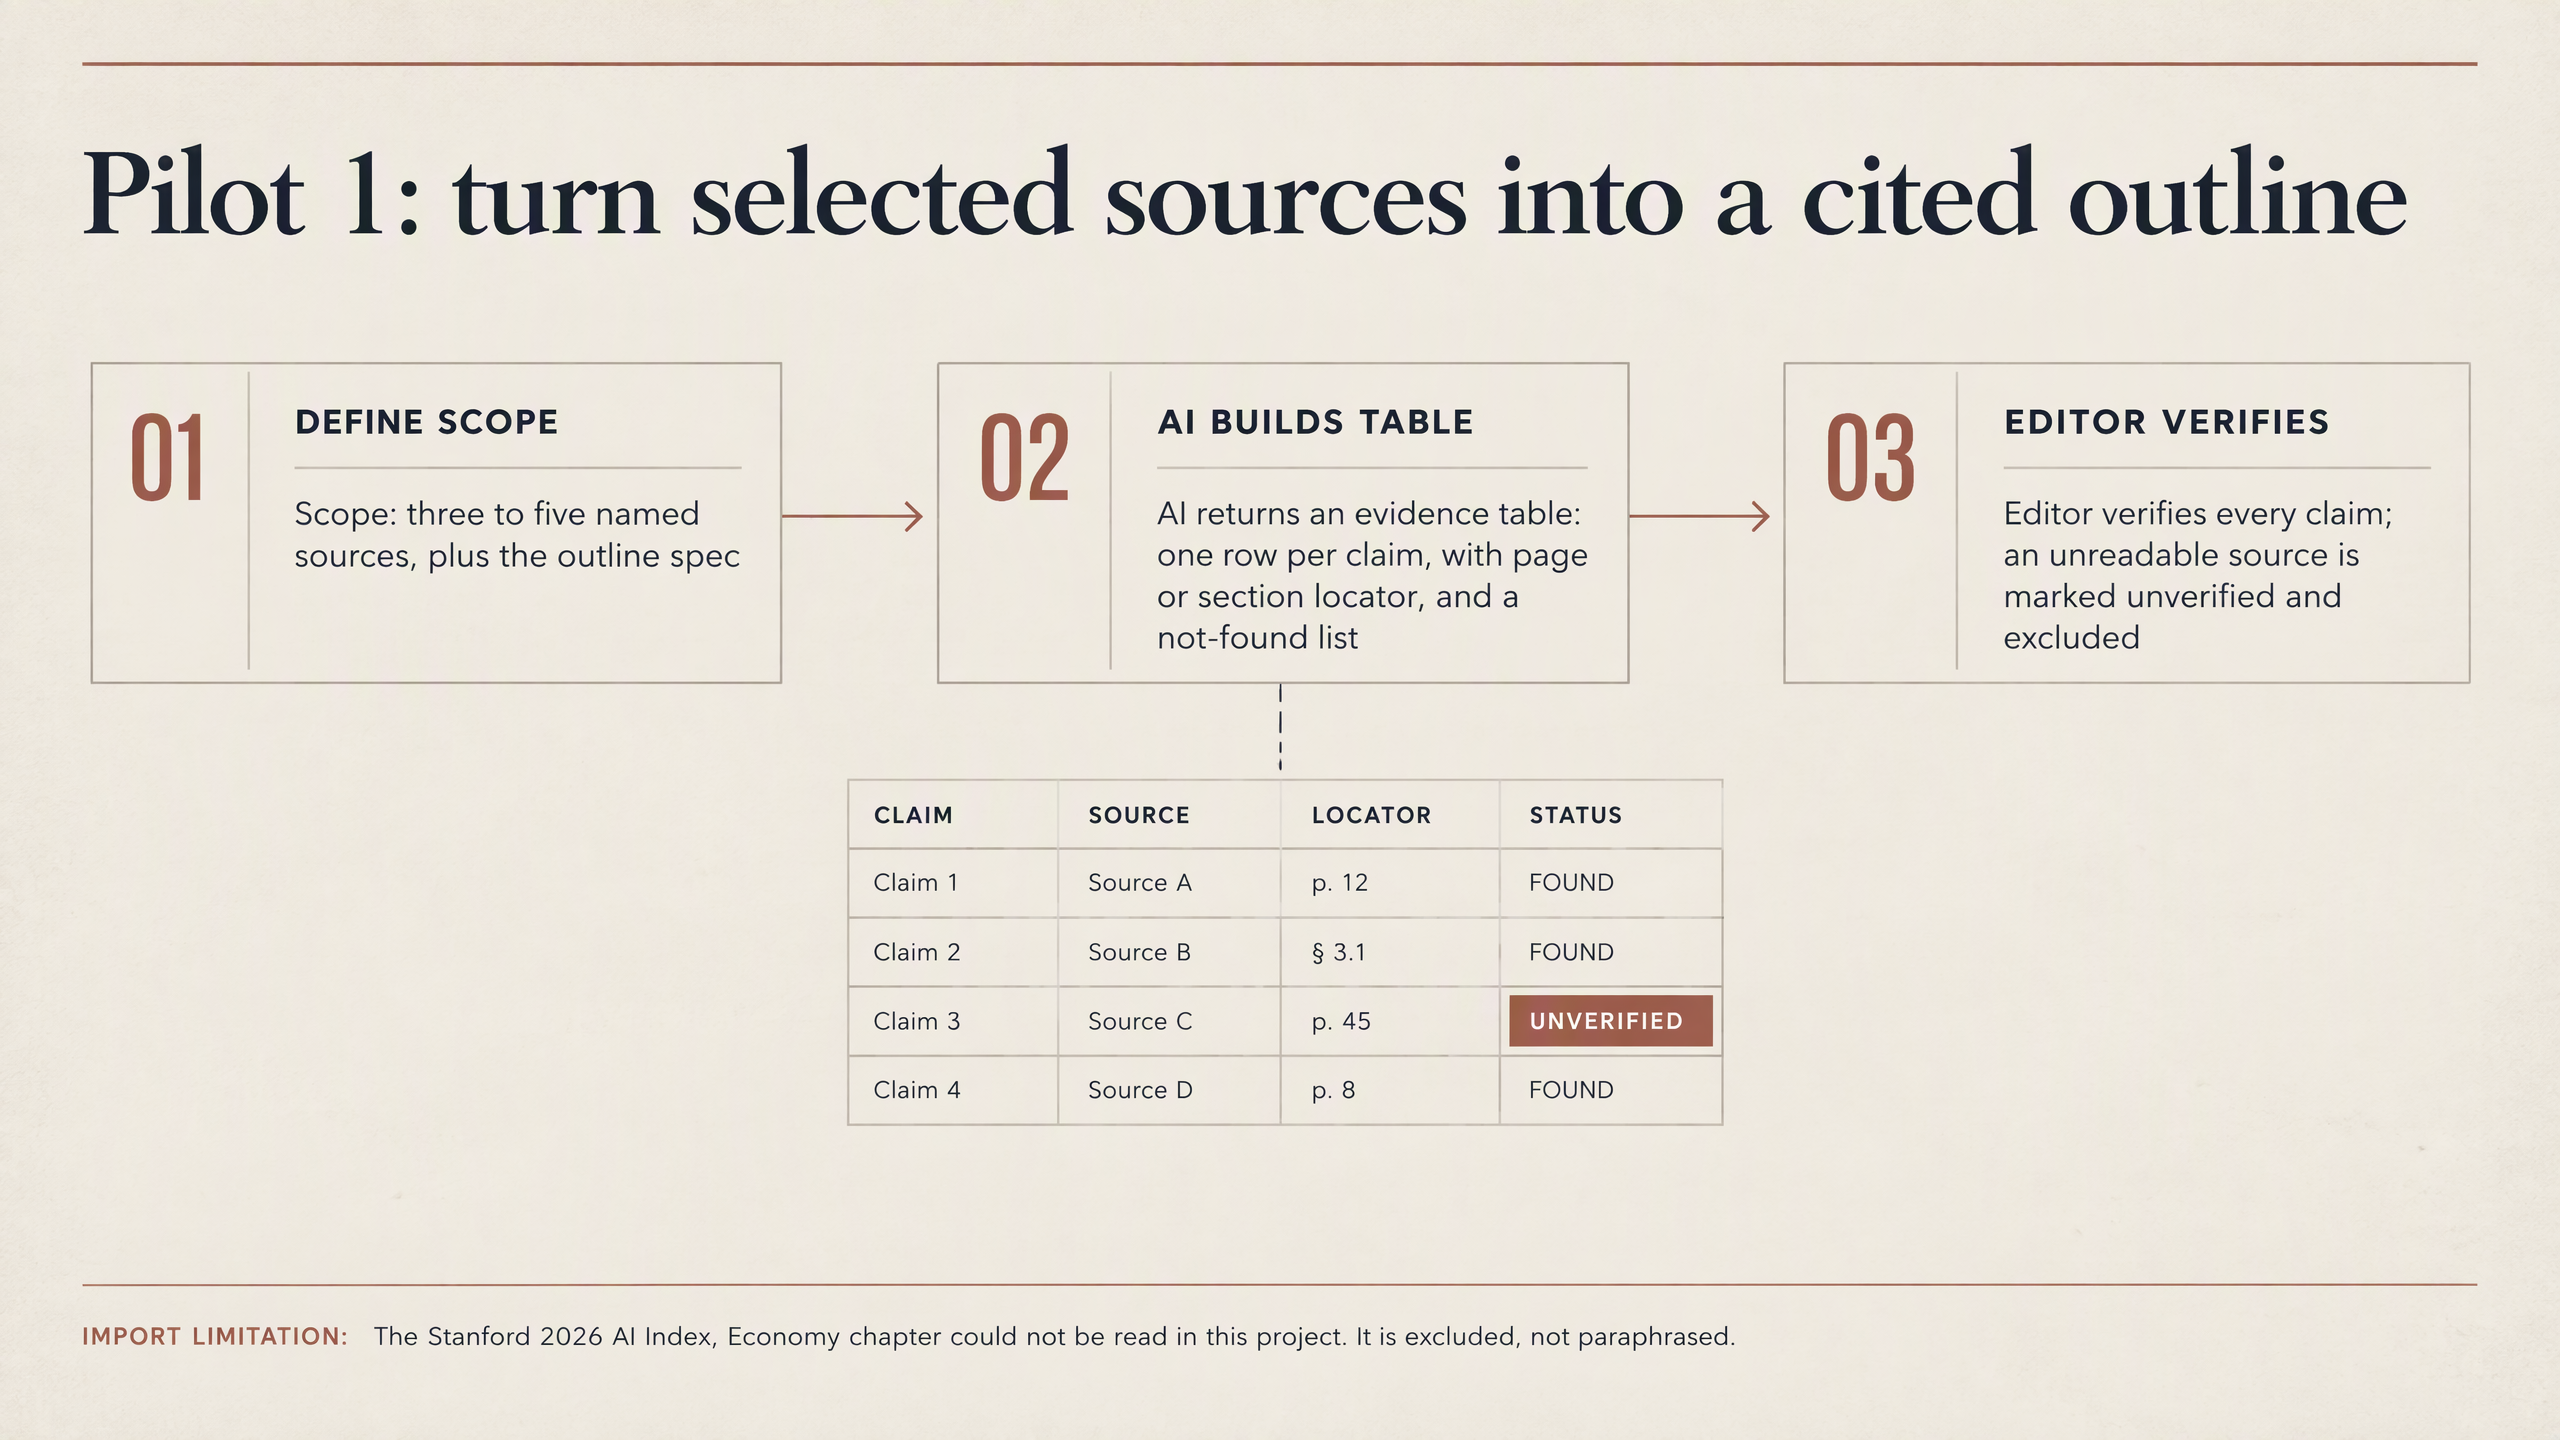
- Les pages problématiques étaient déjà intégrées : le tableau de preuves du pilote 1 affichait des espaces réservés comme « Claim 1 / Source A / p.12 » ; le pilote 2 utilisait des cartes CHANNEL A/B/C qui listaient en réalité des étapes de processus ; la page des modes d’échec n’avait pas d’en-têtes de colonnes et dupliquait la même phrase dans les cellules d’avertissement et de contrôle.
Polir le ton ne règle rien. On corrige en revenant aux sources. Tout ce qui suit provient du journal de révision du Board — de vraies modifications, pas une liste de bonnes pratiques reconstituée après coup.
Checklist de correction (le cœur de cet article)
1. Abandon de source : les captures vides doivent apparaître sur la slide
Stanford n’a pas seulement été écarté dans les notes. La bande de vérification des sources du deck final indique corps indisponible → Exclu. Dans un workflow de citation, le résultat honnête est souvent « non vérifié », pas une page inventée.
Il y a eu un second abandon, côté style : la refonte Soft-Glow a été entièrement générée puis non retenue. Le journal enregistre deux erreurs HTTP 404 lors de la tentative d’annulation, si bien que la tâche a continué — c’est une annulation échouée, pas un test A/B serein. Ne reformulez pas cela en double livraison intentionnelle.
2. Réécriture de la structure : la limite du pilote 2
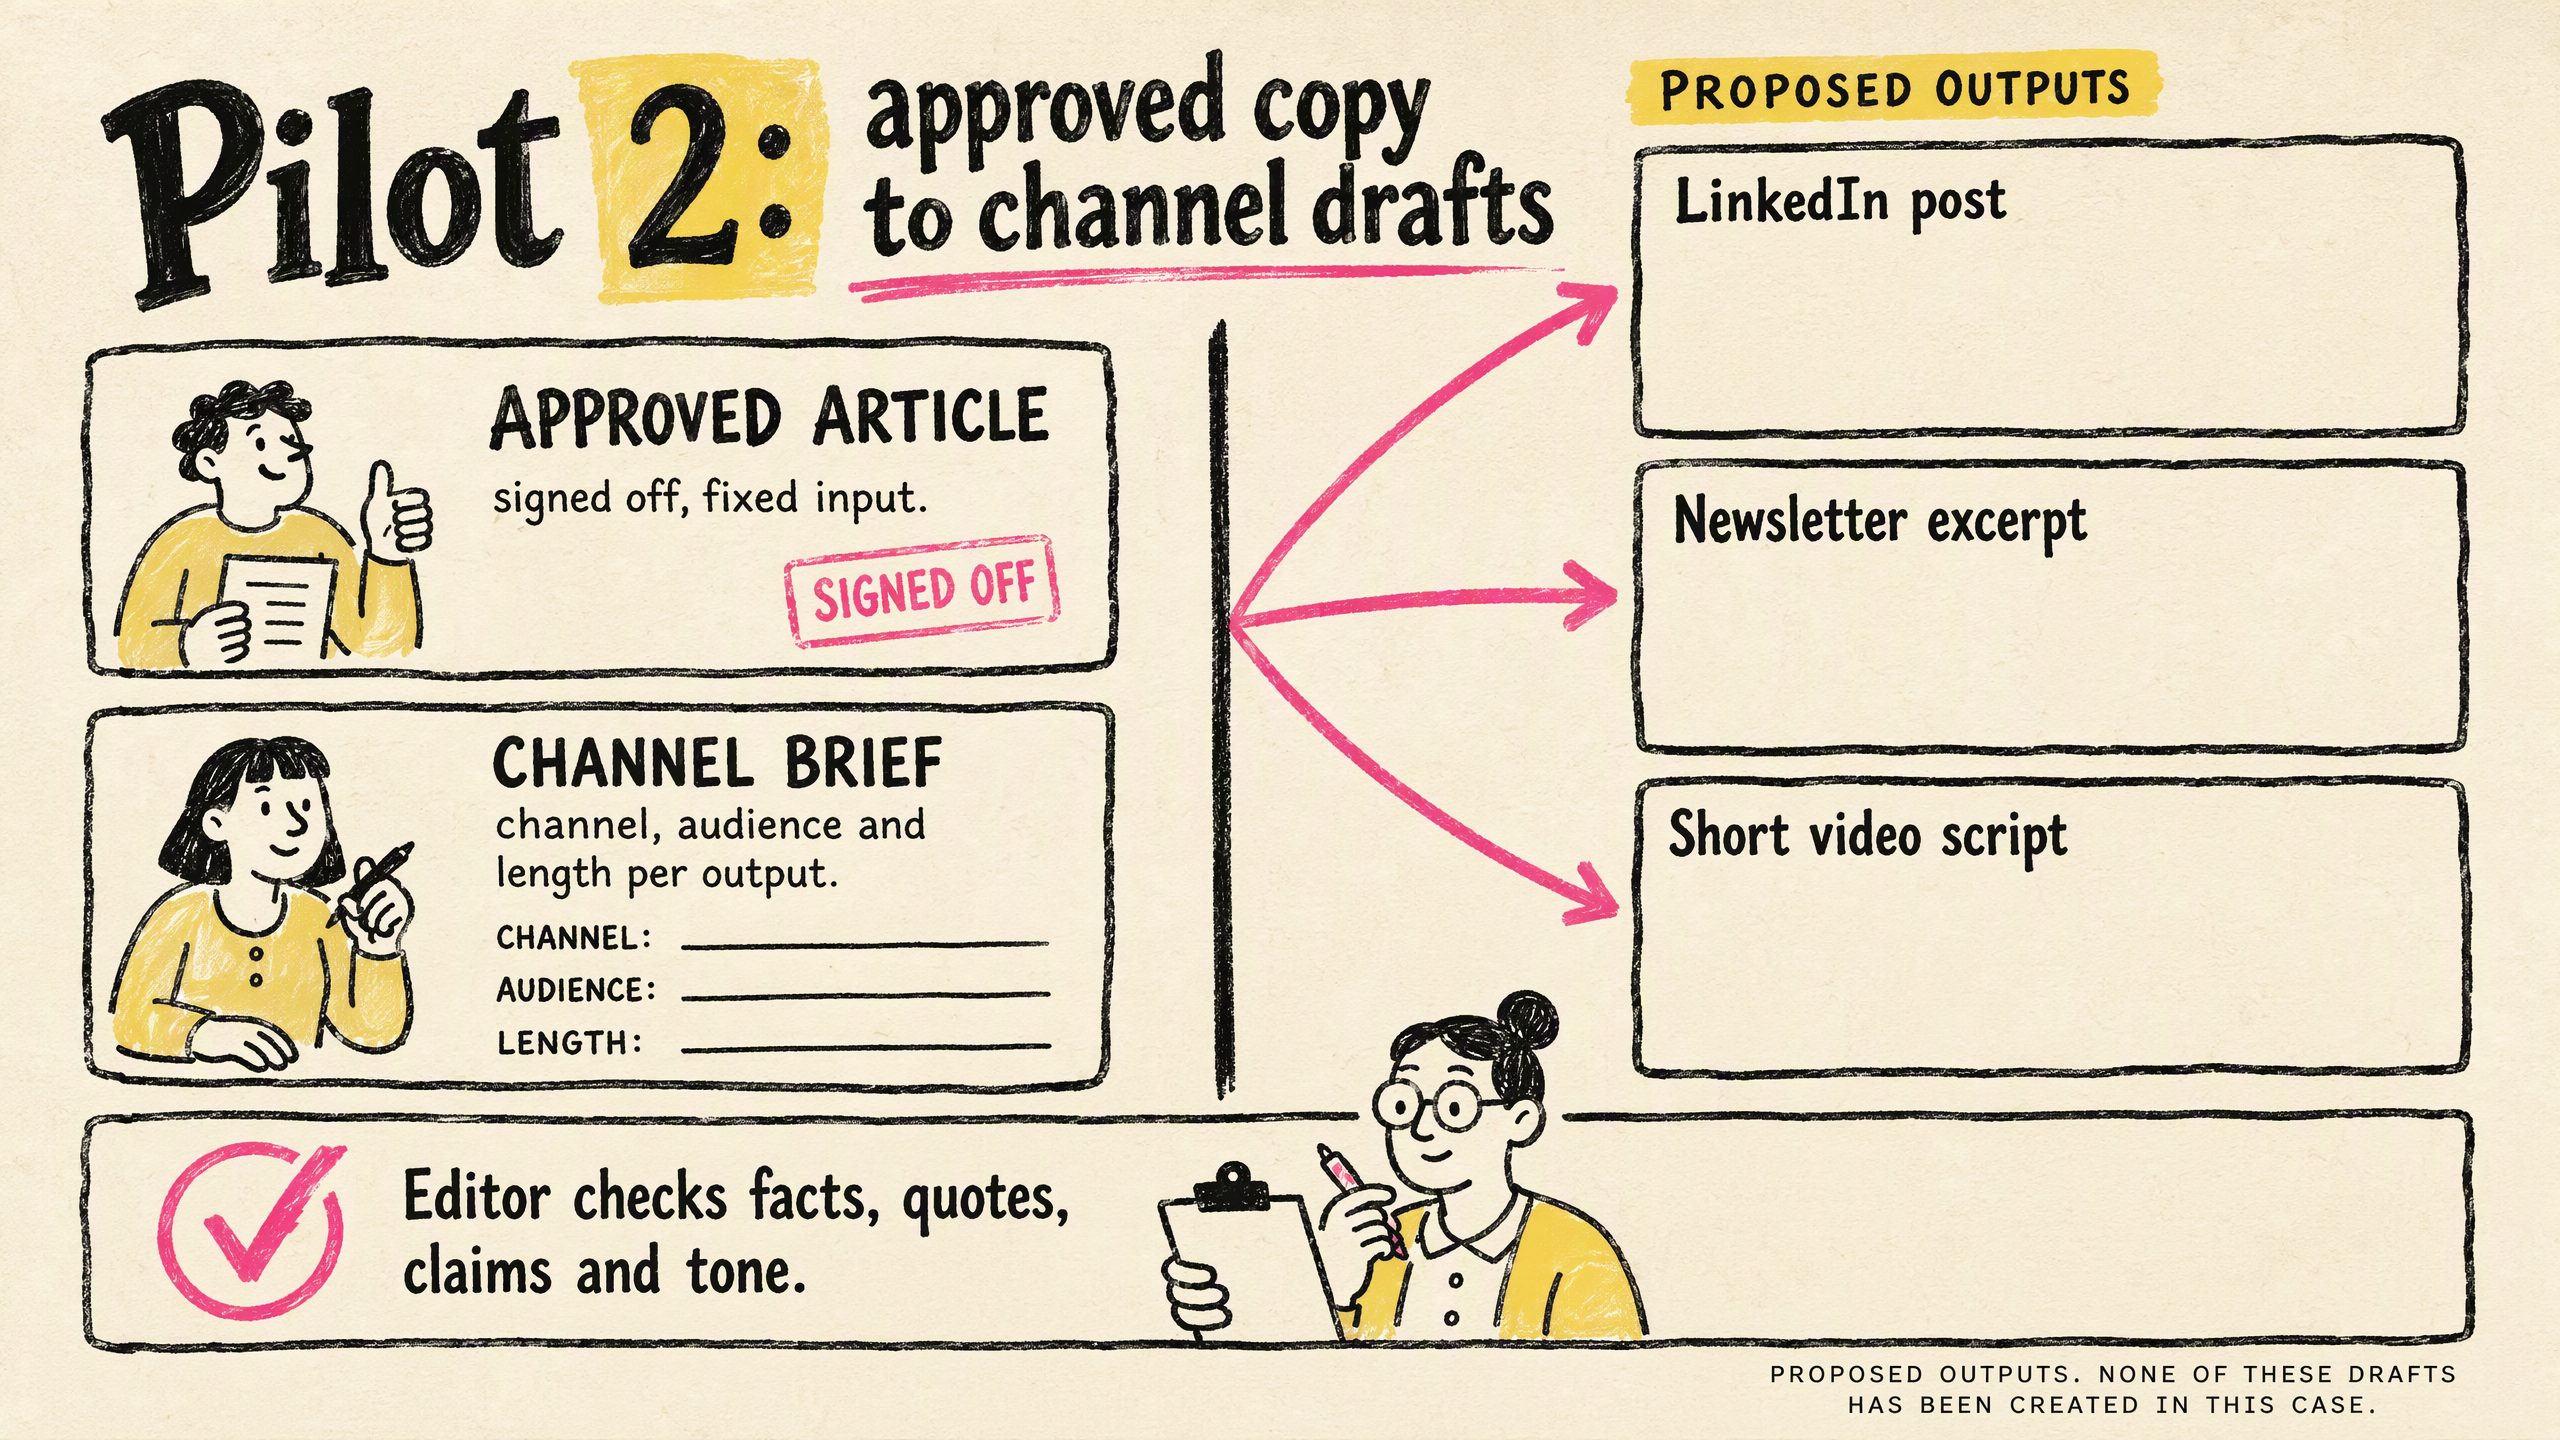
- Problème · Avant : les cartes CHANNEL A/B/C contenaient des étapes alors que le schéma parlait de « canal » · Après : gauche : article validé + brief canal ; droite : trois outputs proposés nommés et vides (LinkedIn, newsletter, vidéo courte) ; une barre de validation commune
- Pourquoi · Avant : aucun brouillon par canal n’existe encore dans ce cas · Après : pied de page : outputs proposés ; aucun créé ici
- Deuxième passe · Avant : le texte d’instruction (« Gauche :… », « Droite :… ») avait fui dans le corps des cartes · Après : supprimé lors de la régénération
Affirmation verrouillée : le contenu validé est la frontière ; l’IA ne modifie pas l’original.
3. Vérification des chiffres et citations : espaces réservés → vrai tableau de sources
Slide 3 (Pilote 1), Round 1
- Problème : « Claim 1 / Source A / p.12 » et autres — des localisateurs inventés sur la page justement consacrée à la rigueur des citations.
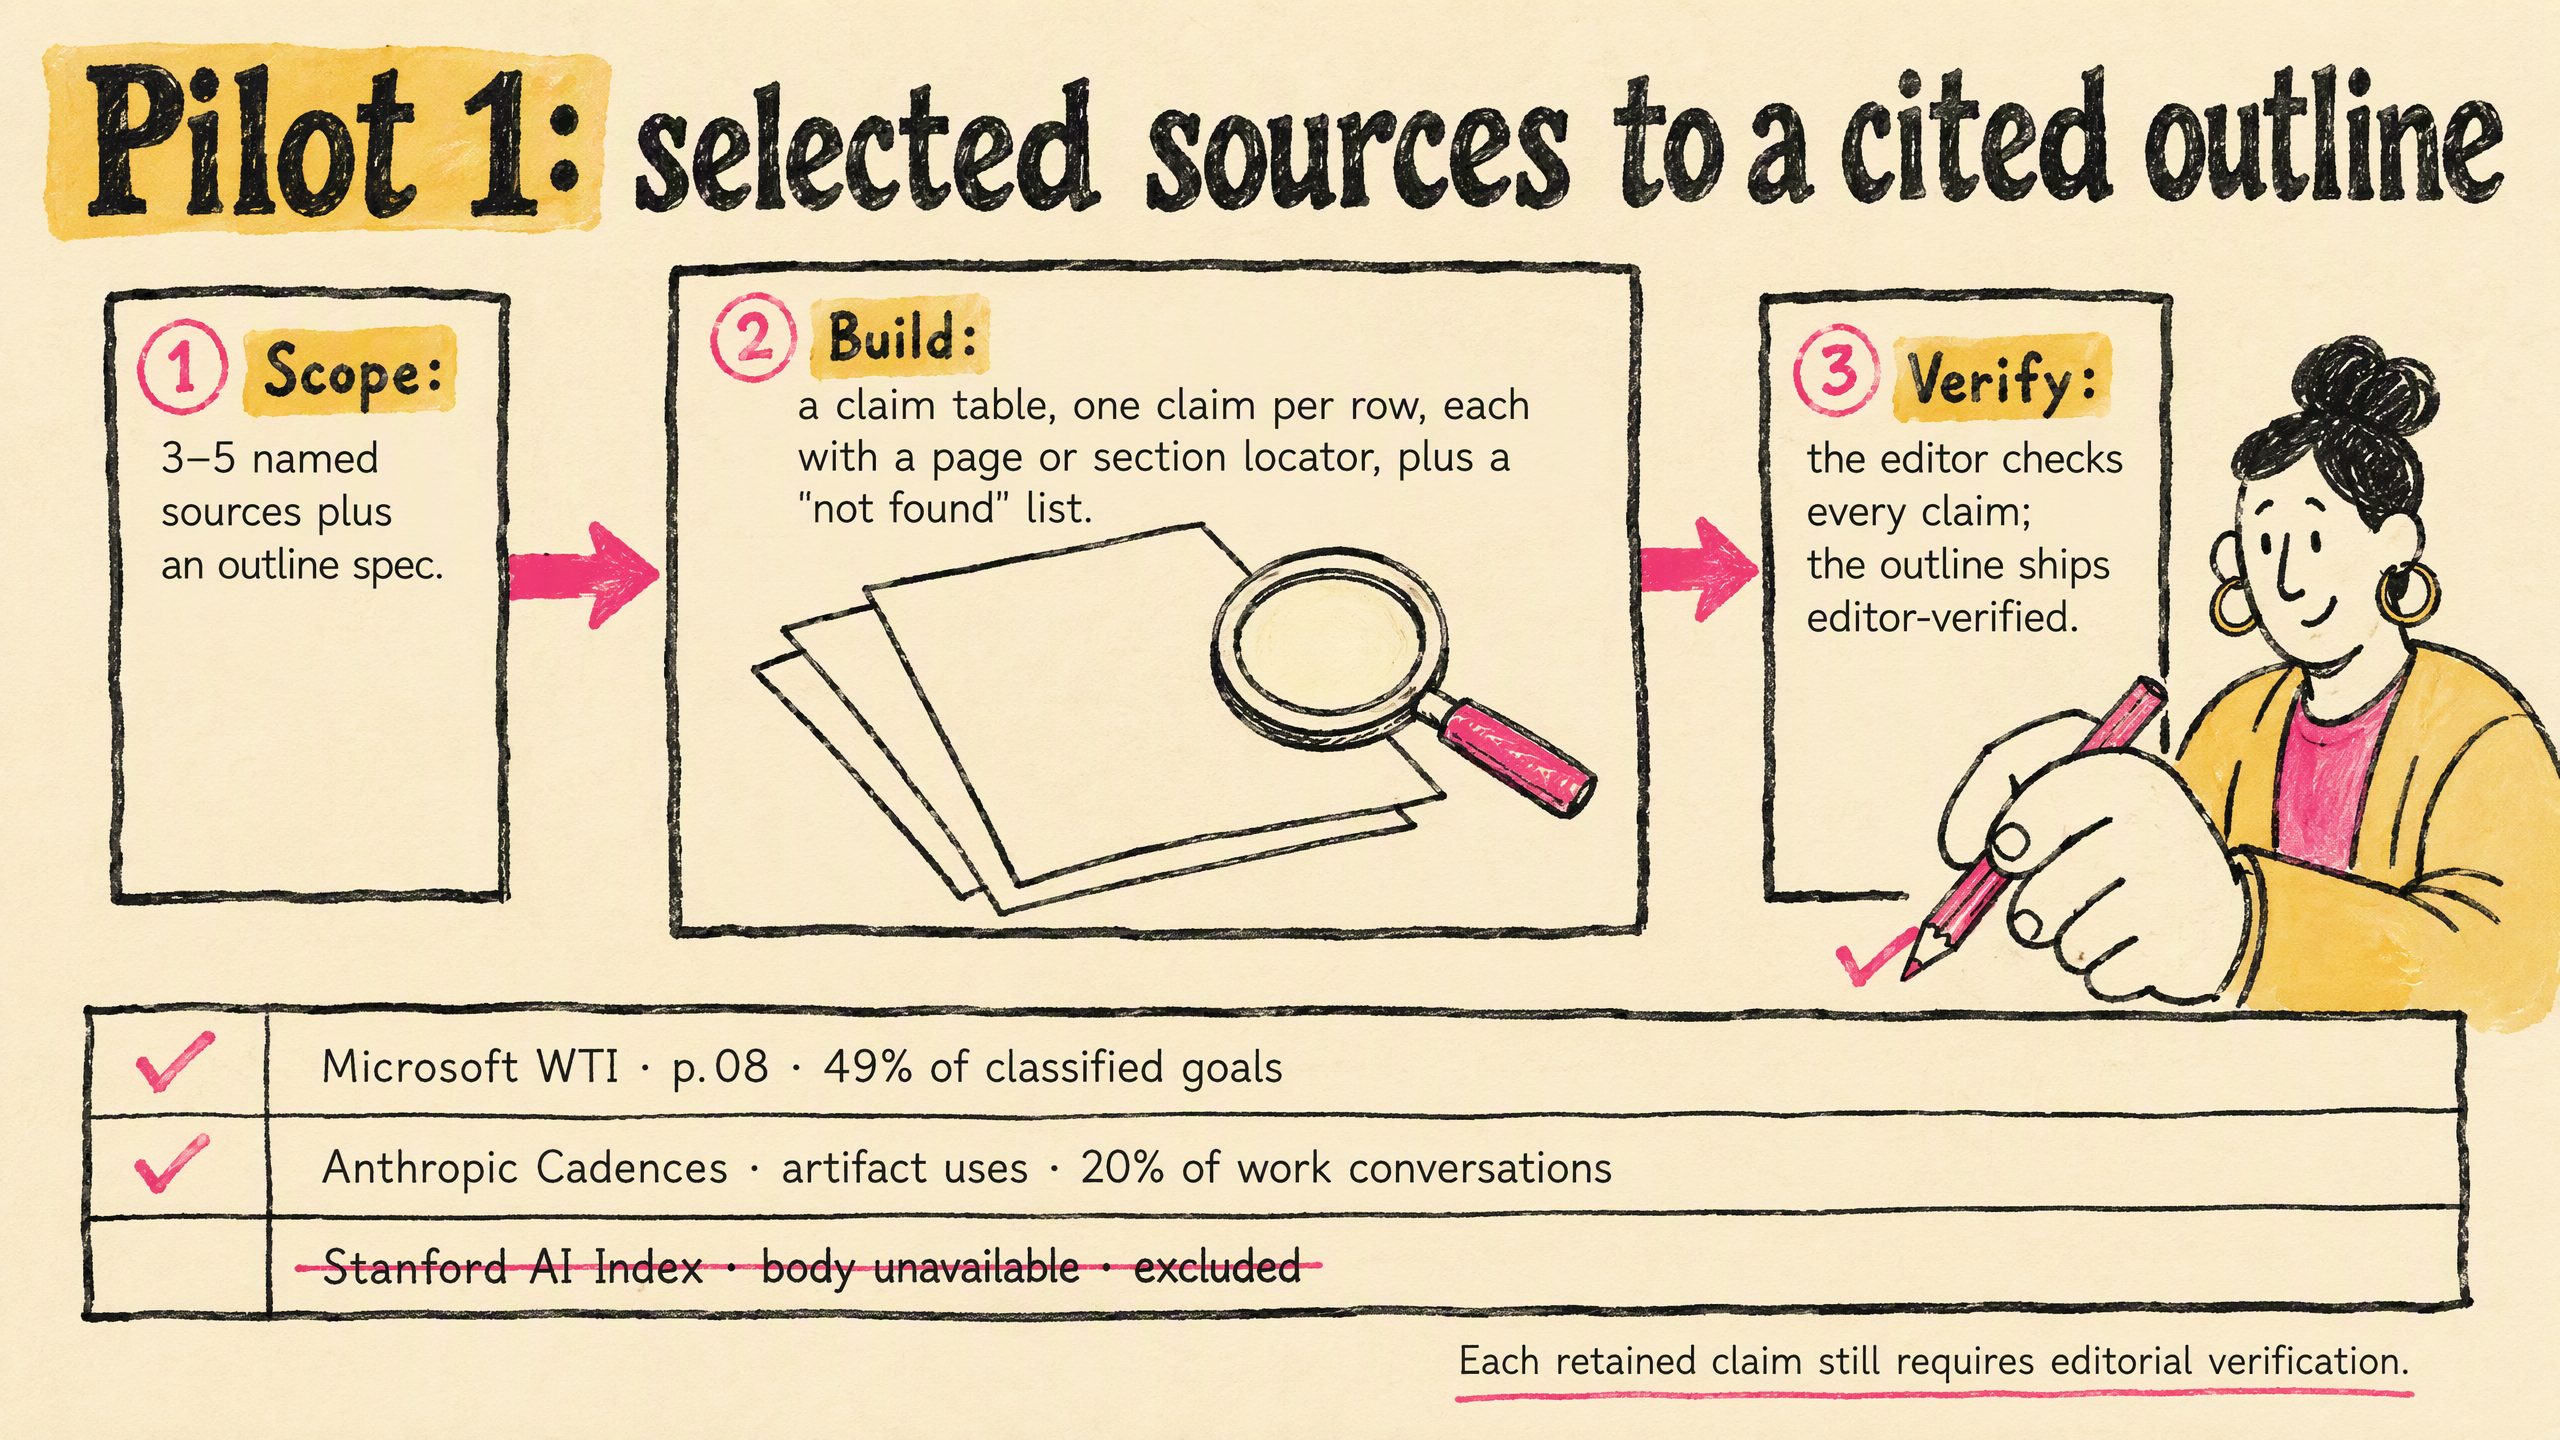
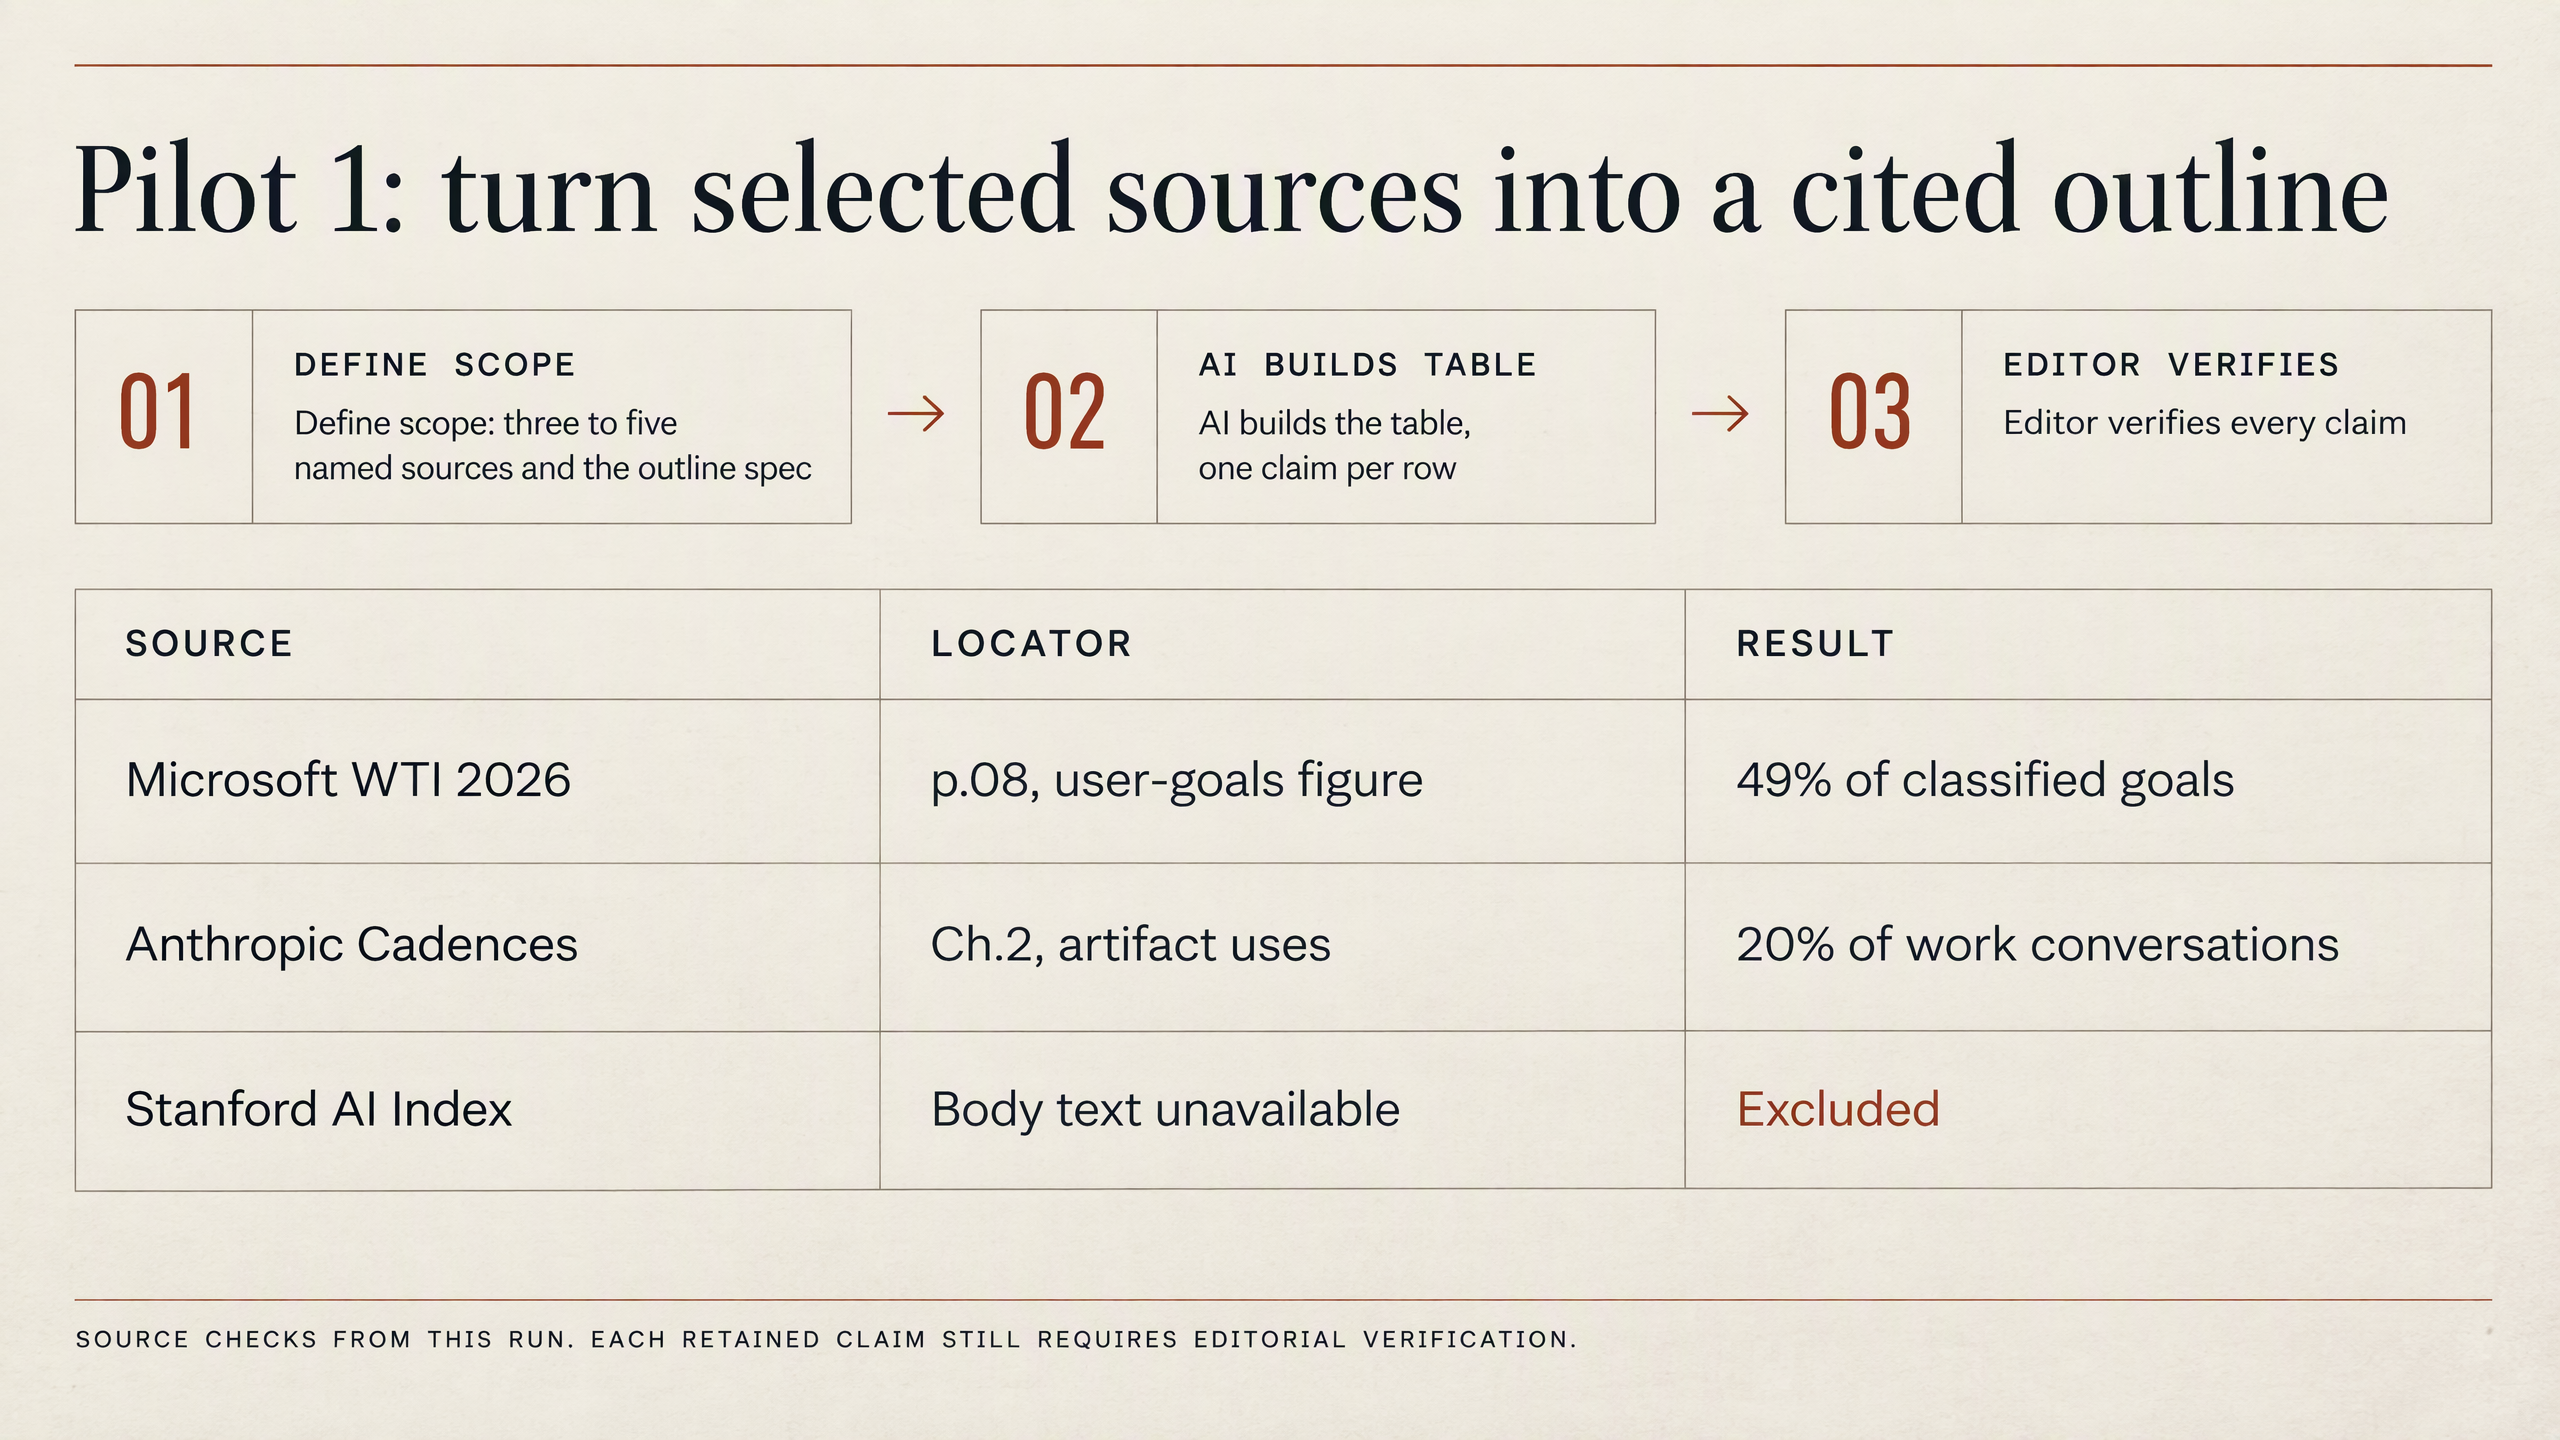
- Correction : trois vraies lignes — Source / Localisateur / Résultat :
- Microsoft WTI 2026 → p.08 → 49 % des objectifs classifiés
- Anthropic Cadences → usages d’artefacts ch.2 → 20 % des conversations professionnelles
- Stanford AI Index → corps indisponible → Exclu
- Pied de page : vérifications de sources issues de ce parcours ; les affirmations conservées nécessitent encore une validation éditoriale.
Round 3 (inspection des images après export) : un mini-tableau central a réintroduit de faux localisateurs (« p.12 », « § 3.1 »). Correction : supprimer entièrement le mini-tableau ; le remplacer par une pile de feuilles dessinée à la main sans étiquette ; conserver la vraie bande de trois lignes en dessous.
4. Correction de clarté : page des modes d’échec
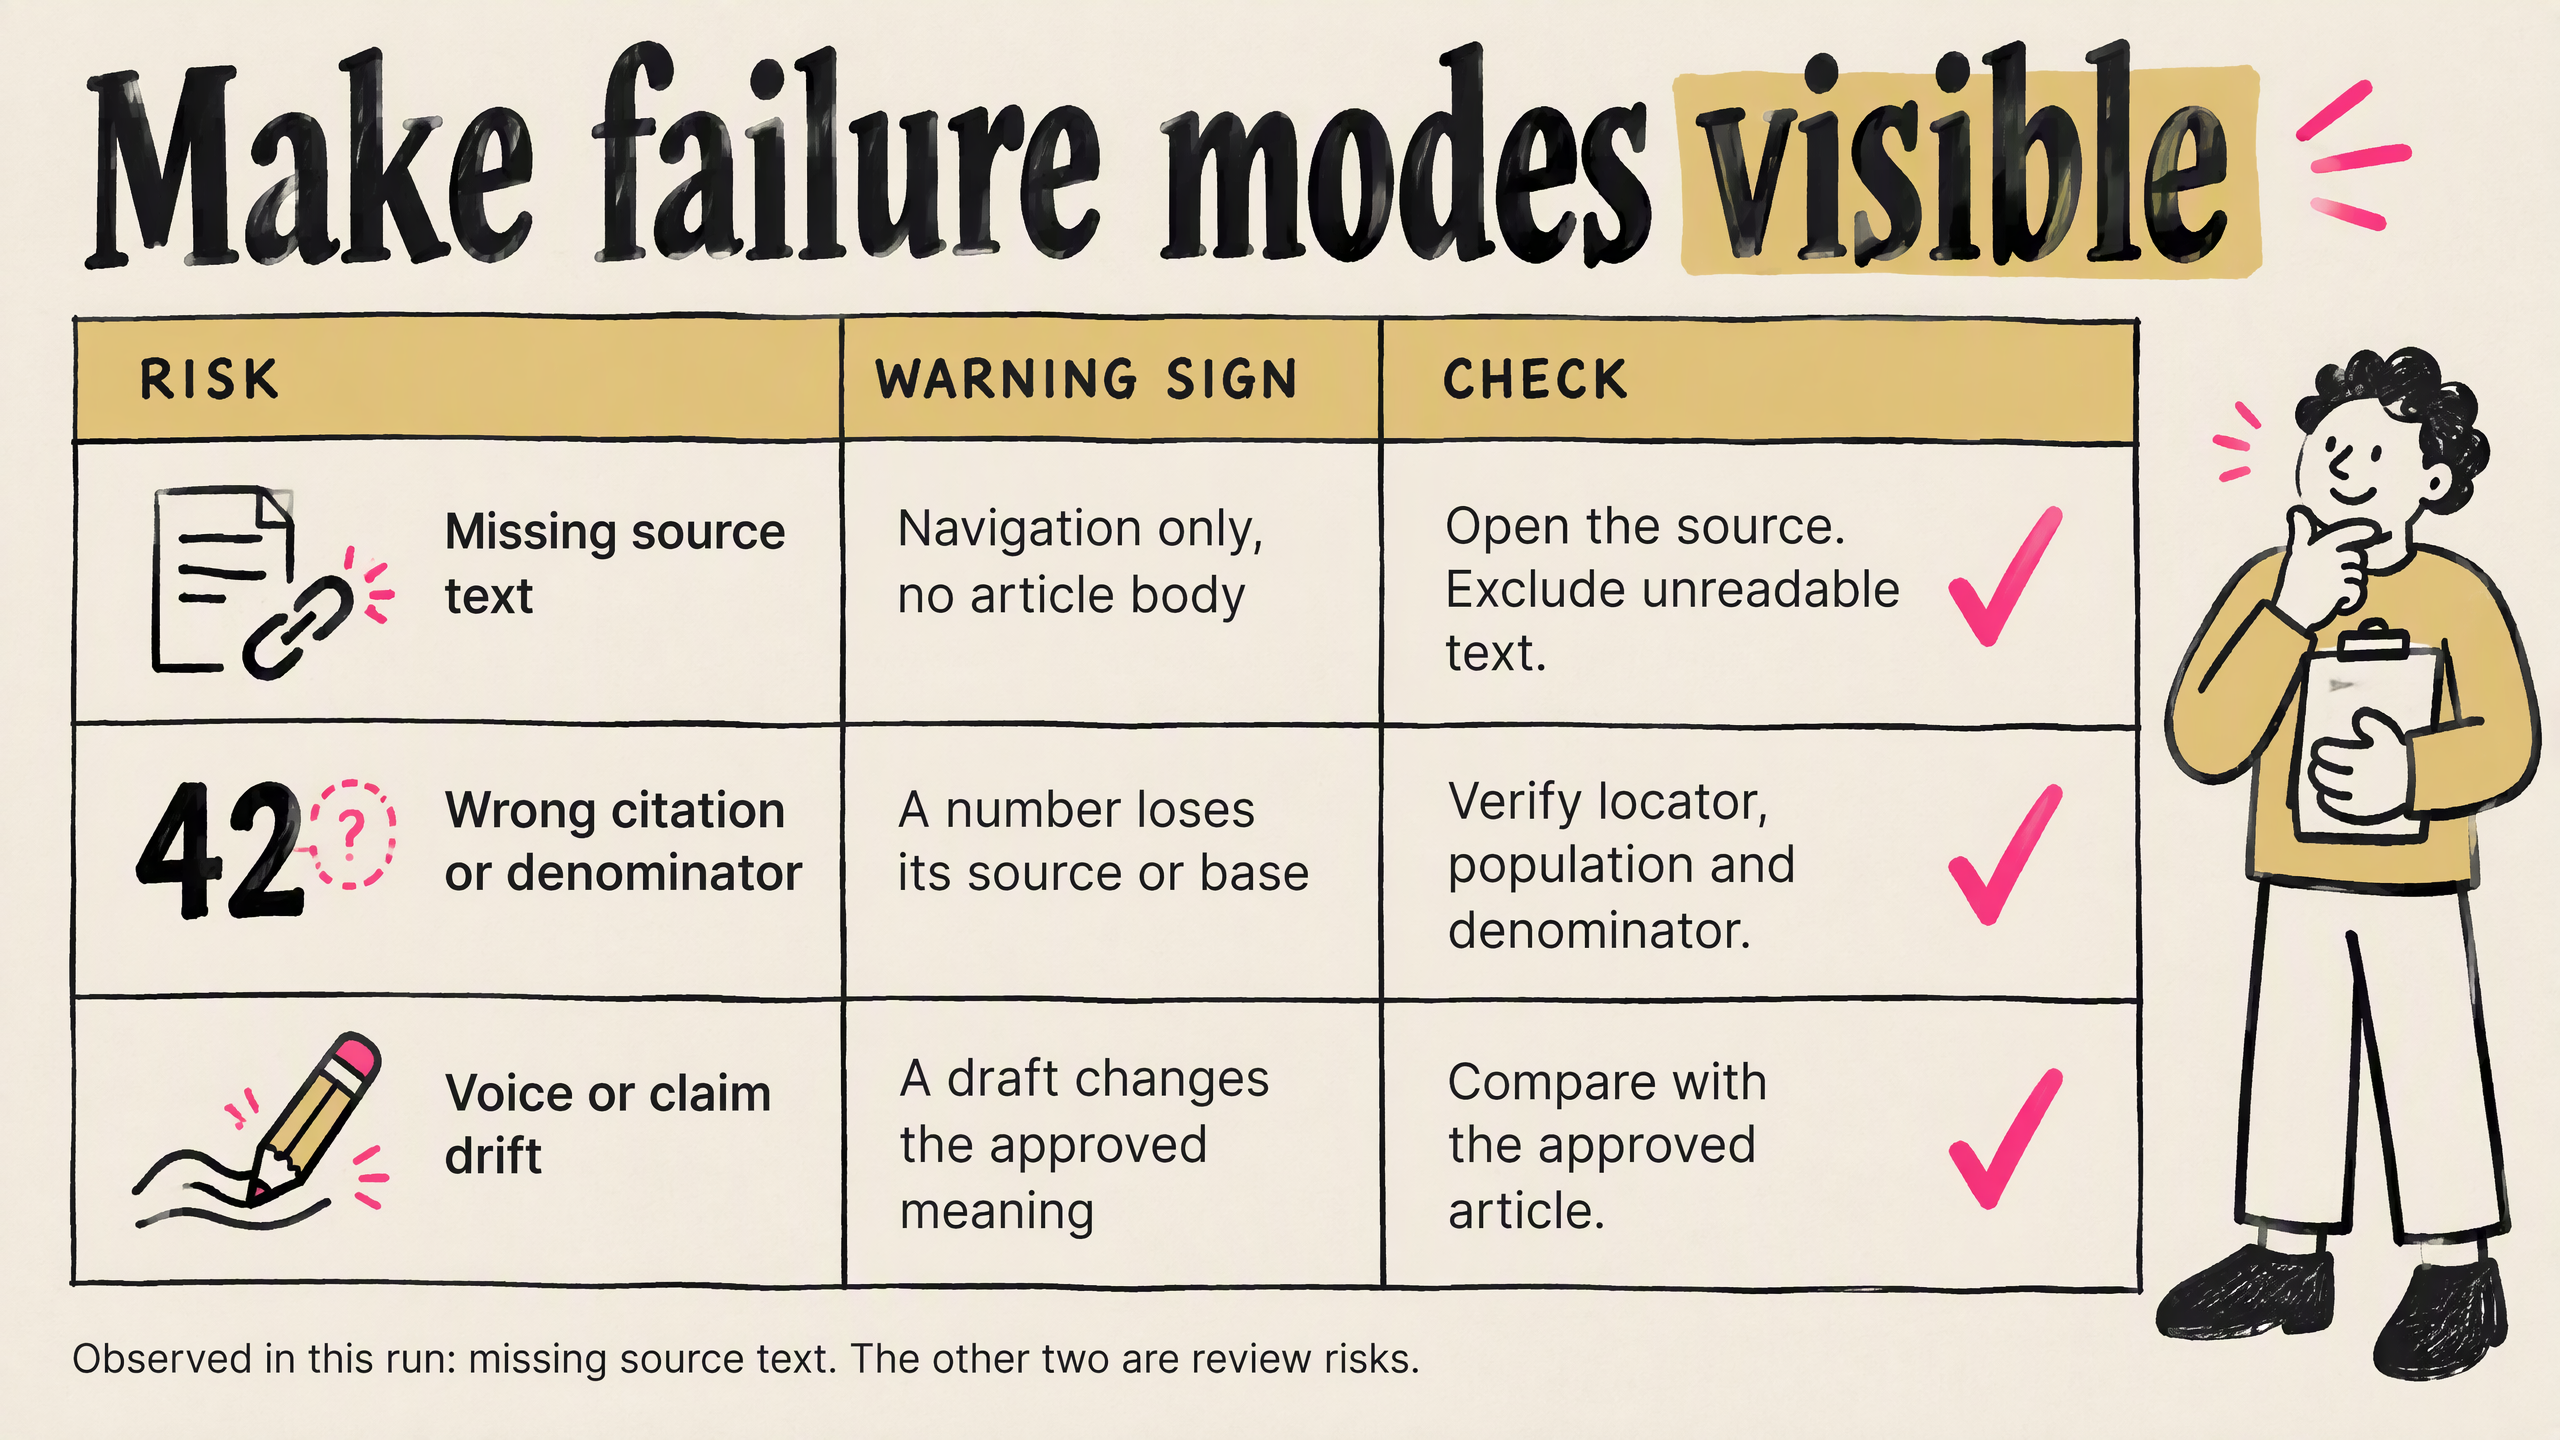
- Pas d’en-têtes de colonnes ; la deuxième ligne répétait la même phrase dans les colonnes d’avertissement et de contrôle, effaçant le sens intermédiaire.
- Après : en-têtes Risque / Signal d’alerte / Contrôle ; trois lignes distinctes (texte source manquant ; mauvaise citation ou dénominateur ; dérive de ton ou d’affirmation) avec des contrôles concrets.
- Round 3 : CHECK chevauchait des coches décoratives au lieu de la colonne d’action → reconstruction sur une véritable grille à trois colonnes.
5. Dans l’éditeur / régénérer : on ne peut pas « corriger un seul mot »
- La note de bas de page de la slide 6 se terminait par un glyphe illisible → régénérer toute la page ; verrouiller la phrase exacte : Week 1 establishes the manual baseline.
- Un préfixe inventé « SOURCE: INTERNAL RESEARCH TEAM » est apparu une fois → supprimé (aucune source interne de ce type dans ce cas).
- Les quatre métriques restent À MESURER — aucun faux chiffre.
6. Choix de style : même contenu validé, deux langages visuels
Une fois le contenu du Round 1 validé, le brouillon papier/encre paraissait trop sobre — argumentation solide, mise en page faible. Donc :
- Round 2a : Vibrant handdrawn for young professional (v1) → sélectionné comme Deck final (contours dessinés à la main, blocs de couleurs vives, types de pages volontairement variés).
- Round 2b : Modern Light Soft-glow (v9) → non retenu, archivé.
Le contenu est resté identique malgré la refonte : formulation du dénominateur de 49 %, deux panneaux de faits séparés, exclusion de Stanford, outputs proposés vides pour le pilote 2, métriques non mesurées, responsable à définir, règle d’arrêt étiquetée comme proposée.
7. Après l’export : les limites qui changent la promesse
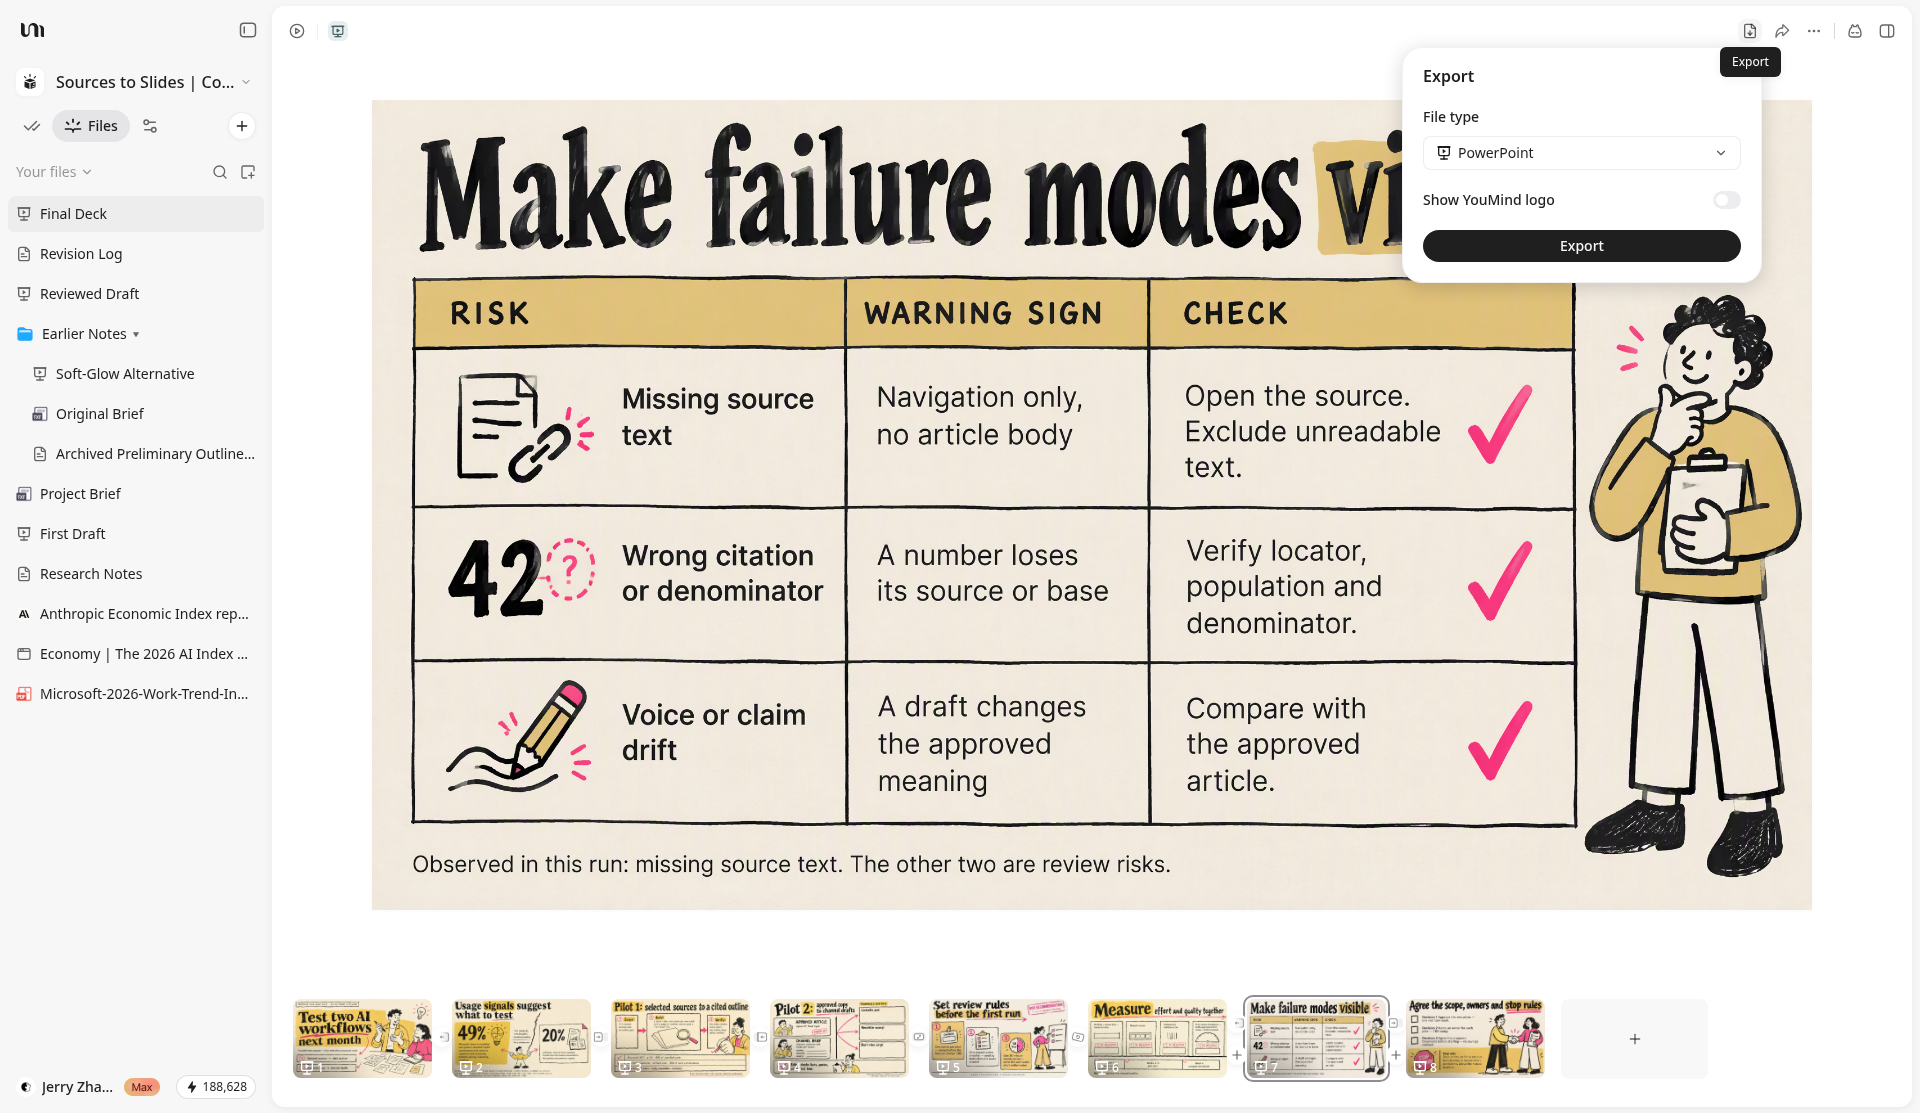
Le PPTX issu de ce deck correspond à une image matricielle par slide (ex. 2560×1440) — aucun objet texte modifiable, aucune piste de notes du présentateur. Changer un mot implique de régénérer l’image de cette page et de remplacer le segment. La narration vit dans les notes de recherche ; présentez à partir de là. Les notes de bas de page lisibles sur un ordinateur portable peuvent devenir illisibles au fond d’une salle.
Pour savoir où se trouvent les boutons et les formats d’export, consultez la page produit : nano-banana-pro-slide. Ne décrivez pas ce fichier comme un PowerPoint classique à texte modifiable.
Le deck final en un coup d’œil
- N° : 1 · Orientation du titre final : Tester deux workflows IA le mois prochain · Jugement protégé par la page : Un plan, pas des résultats ; les résultats non étiquetés seront mesurés
- N° : 2 · Orientation du titre final : Les signaux d’usage indiquent quoi tester · Jugement protégé par la page : Deux faits, deux dénominateurs ; raison de tester ≠ prévision d’économies
- N° : 3 · Orientation du titre final : Pilote 1 : sources sélectionnées → plan cité · Jugement protégé par la page : Vrai tableau de vérification des sources ; illisible → exclure
- N° : 4 · Orientation du titre final : Pilote 2 : contenu validé → brouillons par canal · Jugement protégé par la page : Frontière du contenu validé ; outputs uniquement « proposés »
- N° : 5 · Orientation du titre final : Définir les règles de validation avant le premier lancement · Jugement protégé par la page : La gouvernance est notre recommandation, pas un résultat de recherche
- N° : 6 · Orientation du titre final : Mesurer effort et qualité ensemble · Jugement protégé par la page : Inclure le temps de relecture ; la semaine 1 établit la base de référence
- N° : 7 · Orientation du titre final : Rendre les modes d’échec visibles · Jugement protégé par la page : Trois risques + contrôles peu coûteux ; seul le « texte source manquant » a été observé ici
- N° : 8 · Orientation du titre final : S’accorder sur le périmètre, les responsables et les règles d’arrêt · Jugement protégé par la page : Slide de décision ; règles d’arrêt avant le début des travaux
Checklist à copier-coller
- Les trois questions d’ouverture rédigées (décision / affirmation / interdictions)
- Sources inutilisées consignées (y compris les captures web vides)
- Une affirmation par slide ; les chiffres clés renvoient au PDF/page + dénominateur
- Espaces réservés, fuites d’instructions et schémas mal étiquetés nettoyés
- Si deux styles ont été générés, raisons de la sélection et du rejet consignées (y compris annulations échouées)
- Validation du contenu avant export + vérification après export : modifiable ou non, emplacement des notes
- Aucun faux client, fausse économie ou expression de recherche non prouvée traitée comme trafic vérifié
FAQ
Comment transformer un PDF, des pages web et des notes en PPT de rapport avec l’IA ?
Placez les sources ainsi qu’un public et une affirmation clairs dans un même espace de travail → produisez un plan vérifiable (une affirmation par slide) et validez-le → générez un premier brouillon via une conversation ou un Skill → modifiez les titres, supprimez le bruit et revérifiez les chiffres face aux sources → confirmez ce que l’export fournit réellement, puis livrez. L’enjeu n’est pas la perfection en un clic, mais la traçabilité, un plan validé et la correction humaine après génération.
Que corrige-t-on généralement après que l’IA a généré un PPT ?
Quatre gestes récurrents : (1) écarter les sources qui ne servent pas l’affirmation ou sont illisibles ; (2) reformuler les titres vagues en affirmations conclusives ; (3) vérifier chiffres et citations dans le PDF ou la page d’origine ; (4) s’adapter à la forme réelle de l’export — si les slides sont des images pleine page, prévoyez de régénérer une page lorsqu’un mot est erroné.
En quoi cela diffère-t-il du parcours importer → générer → exporter sur la page outil ?
La page outil montre le parcours fonctionnel. Cet article expose les décisions et les avant/après sur un même jeu de documents, afin que vous sachiez où vous arrêter pour corriger. Les boutons se trouvent sur la page outil ; la capacité à être livré repose sur la checklist de correction.
Vous comparez encore les solutions ? Voir /compare/autoppt.
Prochaine étape
Ouvrez un Board avec l’un de vos propres PDF et vos notes. Appliquez la même checklist : trois questions → sélections dans le plan → génération → correction d’au moins un titre et un chiffre face à la source. Bloqué sur le choix du Skill ? Retournez à la collection. Besoin du parcours produit ? Utilisez la page outil.
Des questions sur cet article ?
Demander à l'IA gratuitementArticles connexes
Instantanément reconnaissable : utilisez Image-to-Prompt pour créer une identité visuelle de marque cohérente
Prenez vos dix dernières images et alignez-les. Si elles semblent appartenir à dix marques différentes – l'une minimaliste et froide, une autre jaune chaleureux dessinée à la main, et la suivante soudainement très saturée – le problème n'est pas qu'une image en particulier soit ratée. Le problème, c'est qu'elles racontent chacune une histoire différente. Dans un flux saturé de contenu, ce qui fait que les gens se souviennent de vous, ce n'est pas une seule image époustouflante, mais un sentiment de continuité qui leur fait penser : « Je reconnais que c'est toi avant même de voir le pseudo. » Et cette continuité n'est pas un talent – c'est un système. La cohérence visuelle semble réservée aux grandes marques et aux designers professionnels, mais dans son principe, c'est en fait très simple : le même éclairage, la même palette de couleurs, la même texture de médium, la même composition, répétés jusqu'à devenir votre identité. La difficulté n'est jamais de « créer une belle image » – c'est de « faire en sorte que la centième image semble toujours appartenir à la même famille que la première ». Et ironiquement, les outils de génération d'images par IA ont rendu cela plus difficile. Ce qui rend le texte-à-image si séduisant est précisément ce qui le rend dangereux pour l'image de marque : chaque génération est un peu différente. Le même prompt, « style illustration chaleureuse et apaisante », peut vous donner une lumière douce et crémeuse aujourd'hui et une intensité orangée riche demain. Le même « shot produit minimaliste » peut sortir avec un fond blanc pur cette fois, et inexplicablement ajouter une ombre la fois suivante. Le modèle réinterprète votre description vague à chaque fois, et il n'intériorise jamais vraiment ce que « votre marque devrait ressembler » dans votre esprit. Vous tombez donc dans une boucle familière : vous décrivez chaque image à partir de zéro, elle est toujours un peu à côté, vous vous contentez et la publiez, et des mois plus tard, vous regardez en arrière et votre compte semble avoir été géré par trois ou quatre personnes aux esthétiques complètement différentes. est souvent utilisé comme un outil simple pour « faire de la rétro-ingénierie sur la façon dont une image a été créée ». Mais dans le contexte de l'image de marque, il fait quelque chose de bien plus important : il prend un style visuel que vous reconnaissez instantanément mais que vous avez du mal à décrire, et le fixe en un bloc de texte que vous pouvez copier et réutiliser. L'approche est simple. Premièrement, choisissez une image « d'ancrage de style » qui représente l'ambiance de votre marque – cela peut être votre publication la plus performante, une image de référence à laquelle vous revenez sans cesse, ou une image de base que vous avez spécialement créée pour cette marque. Transmettez-la à l'outil, et il « lira » cette image pour produire une description structurée : quel est le sujet, d'où vient la lumière, si la palette de couleurs est froide ou chaude, s'il s'agit de photographie ou d'illustration, la profondeur de champ et la texture, et l'ambiance générale. Cette description est la version textuelle de l'ADN visuel de votre marque. Désormais, vous n'avez plus besoin de tout réécrire à l'instinct à chaque fois. Vous disposez d'un modèle que vous pouvez réutiliser tel quel. Dans un prompt extrait, certains éléments sont les constantes de votre marque, et d'autres ne sont que le contenu de cette image particulière. Les séparer est la clé de toute la méthode. Ce que vous devez verrouiller comprend généralement ceci : la palette de couleurs – l'ensemble des teintes qui permet aux gens de vous reconnaître au premier coup d'œil ; l'éclairage – lumière douce du matin ou lumière latérale dure ; la texture du médium – photographie réaliste, illustration semi-réaliste ou rendu 3D ; l'habitude de composition – beaucoup d'espace négatif, sujet centré ou décalé ; et l'ambiance générale – calme, nette ou dynamique. Ensemble, ils constituent la partie qui fait dire aux gens : « Je te reconnais avant même de voir clairement. » Ce que vous devez changer à chaque fois, c'est uniquement le contenu lui-même : cette fois, le sujet est le Produit A, la prochaine fois le Produit B ; cette image concerne une scène de petit-déjeuner, celle-là un bureau. Vous préservez les « gènes » de votre style, remplacez uniquement cette variable, et régénérez – l'éclairage et la palette de couleurs se reportent, et seul ce que vous avez changé change réellement. C'est la véritable ligne de démarcation entre « produire un ensemble d'images qui appartiennent à la même marque » et « miser sur la chance à chaque fois ». Le vrai test de la cohérence visuelle d'une marque n'est pas une seule image – c'est à travers les contextes. Une couverture d'article de blog, un ensemble d'images pour les réseaux sociaux, un PPT externe – s'ils ont tous des styles différents, même un excellent contenu semble fragmenté. Avec ce prompt fixe, vous pouvez diffuser le même langage visuel sur tous les points de contact : utilisez-le pour générer une couverture de blog qui porte le ton de votre marque, créez un ensemble d'images pour des posts sociaux qui semblent aller ensemble, et même définissez un look unifié pour les illustrations de vos présentations. Dans YouMind, à partir de ce prompt, vous pouvez enchaîner toutes ces tâches de manière fluide – couvertures, images d'accompagnement et diapositives partagent la même lumière et la même palette de couleurs, au lieu de suivre chacune leur propre chemin. Comme un prompt est un texte brut, il fonctionne avec différents outils : Nano Banana Pro, GPT Image 2, Midjourney et Stable Diffusion peuvent tous lire la même description. Le style de votre marque n'est pas enfermé dans un seul modèle. Il y a une ligne qu'il vaut la peine de tracer clairement. S'inspirer de l'éclairage, de la composition et de l'atmosphère d'une image est sain. Mais si votre « ancrage de style » provient directement du visuel signature d'un concurrent, d'un personnage célèbre sous droits d'auteur, ou du logo d'une autre marque, et que vous l'utilisez comme votre propre visage – cela glisse de « construire un style » à « usurper une identité ». Un « style » générique n'appartient à personne, mais l'expression spécifique et reconnaissable d'une marque est son propre atout. L'approche la plus sûre est donc de vous ancrer sur votre propre matériel – vos produits, vos scènes, votre base – puis d'utiliser le prompt extrait pour le systématiser et le démultiplier. Chaque image que vous produirez sera alors à la fois cohérente et véritablement vôtre. Autrefois, la cohérence visuelle d'une marque reposait sur un designer qui se souvenait de chaque détail, ou sur un guide de style que personne ne voulait lire. Maintenant, vous pouvez la compresser en un bloc de texte : extrayez une fois, réutilisez plusieurs fois, ne changez que ce qui doit changer. La prochaine fois que vous aurez besoin d'une image pour un nouveau contenu, vous n'aurez pas à miser sur la chance en fixant une boîte de prompt vide. Vous savez déjà à quoi ressemble votre marque, et vous pouvez lui donner cette apparence à chaque fois. Comment Image to Prompt aide-t-il à la cohérence visuelle de la marque ? Il traduit une image qui représente l'ambiance de votre marque en un prompt structuré. Vous verrouillez la palette de couleurs, l'éclairage, le médium et la composition, et à chaque fois vous ne remplacez que le sujet ou la scène. Les images produites garderont toujours le même style. Quelle image devrais-je utiliser comme « ancrage de style » ? Votre propre matériel est le plus sûr : votre publication la plus performante, une image de base que vous avez spécialement créée, ou une image finie qui représente le mieux l'ambiance de votre marque. Essayez d'éviter d'utiliser des concurrents ou des personnages sous droits d'auteur comme ancrage. Ce prompt peut-il être utilisé avec différents outils d'IA ? Oui. Le résultat est un texte brut, et les principaux outils texte-à-image comme Nano Banana Pro, GPT Image 2, Midjourney et Stable Diffusion peuvent tous l'utiliser directement. Le style de votre marque ne sera pas enfermé dans un seul modèle. Cela rendra-t-il toutes les images exactement identiques ? Non. Cela verrouille les constantes stylistiques, mais le contenu reste différent à chaque fois. L'objectif est de les faire ressembler à « une seule famille », pas de copier-coller la même image. Ai-je besoin d'expérience en design ou en rédaction de prompts ? Non. L'étape d'extraction traduit le visuel en texte pour vous. Vous avez simplement besoin de décider quels éléments sont les constantes de votre marque et lesquels remplacer, et vous pouvez commencer à réutiliser.
Transformez une image en prompts de génération d'images IA réutilisables
Vous avez probablement déjà vécu ce moment : vous faites défiler votre fil, vous voyez une image et vous ne pouvez plus détourner le regard — l'éclairage, la palette de couleurs, l'ambiance que vous cherchiez depuis des semaines, tout capturé dans une seule image. Vous voulez créer quelque chose de similaire, alors vous ouvrez votre générateur d'images IA, fixez la zone de prompt vide et tapez quelque chose de vague comme « photo cinématographique, bel éclairage, ambiance complète ». Le résultat ? Quelque chose qui n'a rien à voir avec l'image que vous aviez en tête. Le problème n'est généralement pas votre goût, c'est la traduction. Reconvertir une image finie en texte qui pourrait la recréer est réellement difficile. Il faut un vocabulaire spécialisé autour de la composition, des angles de prise de vue, de l'éclairage, des palettes de couleurs et du style — un vocabulaire que la plupart des gens n'ont jamais l'occasion de développer. C'est exactement ce que fait pour vous : fournissez-lui une image, et il vous restitue le texte. Cet article explique ce que c'est, quand il fonctionne bien, ses limites, et comment obtenir votre premier prompt en quelques secondes. Image to Prompt est l'inverse du text-to-image. Normalement, vous écrivez une description et le modèle génère une image. Ici, vous donnez au modèle une image finie, et il écrit la description — le prompt qu'il aurait fallu saisir pour obtenir cette image. Vous avez peut-être entendu différents noms : reverse prompting, extraction de prompts, image-to-prompt, ou simplement « rétro-ingénierie de prompts à partir d'images ». Les noms varient, mais la tâche est la même : convertir des informations visuelles en une description textuelle structurée et réutilisable que n'importe quel outil text-to-image peut comprendre. Une extraction utile va bien au-delà de quelque chose d'aussi vague qu'« un chat ». Elle capture les éléments qui définissent réellement une image : Vous téléversez une image, et l'outil la « lit » comme un œil exercé, en identifiant les éléments qui déterminent réellement l'impact visuel : sujet et composition, direction et qualité de la lumière, palette de couleurs globale, style et médium, ainsi que les détails techniques comme la profondeur de champ et la texture. Ensuite, il traduit ce qu'il voit en un langage précis et assemble un prompt cohérent, prêt à l'emploi. Une certaine lumière devient « douce lumière du matin », une certaine tonalité devient « style chaleureux semi-réaliste ». En quelques secondes, vous disposez d'un prompt utilisable immédiatement. Dans YouMind, vous pouvez l'utiliser comme point de départ pour créer une couverture d'article ou même générer des illustrations pour une présentation. Mais rappelez-vous : cette sortie est un premier jet solide, pas une vérité absolue. C'est la meilleure interprétation que l'outil peut faire de l'image — ce que la section suivante aborde. Voici un déroulement complet en conditions réelles. Tout d'abord, vous téléversez une image de référence (dans ce cas, une illustration doucement éclairée d'une personne tenant un chat blanc). La carte de téléversement indiquera : fichier prêt, prêt à traiter. Cliquez sur Générer le prompt, et voici la sortie réelle : Vous voyez ? Cela va bien au-delà d'« une personne tenant un chat ». Il précise la direction de la lumière, la palette de couleurs, la profondeur de champ, la composition et l'ambiance — exactement les facteurs qui déterminent si votre prochaine image correspondra à la référence. En plus du prompt, l'outil propose des étapes suivantes claires : générez-le tel quel, remplacez un élément tout en conservant la composition d'origine, ou réutilisez le style pour des couvertures ou des visuels de réseaux sociaux. À partir de là, vous n'avez pas à repartir de zéro — changez simplement une variable. Remplacez le chat blanc par un chien, changez la couleur du pull ou déplacez la scène dans un coin lecture, puis régénérez. La composition et l'éclairage seront conservés ; seul l'élément que vous avez modifié sera différent. Vous conservez l'« ADN » de l'image de référence — son éclairage, son cadrage et son atmosphère — tandis que le résultat final est indubitablement le vôtre. La plupart des outils image-to-prompt s'arrêtent à « voici une description » — et cette étape est désormais pratiquement standard. Là où le brille véritablement, c'est ce qui se passe après l'obtention de la description : Il excelle avec les sujets uniques et clairs : portraits, photos de produits, paysages et images ayant un style cohérent et reconnaissable. Les images de référence propres et bien éclairées, en particulier, ont tendance à produire des prompts tout aussi propres. Dans quelques domaines prévisibles, il devient peu fiable. Les compositions chargées à plusieurs sujets peuvent le dérouter quant à l'élément que le prompt doit mettre en avant. L'art abstrait est difficile à retranscrire en texte et perdra toujours une partie de son essence. Les images avec beaucoup de texte (affiches, infographies, mèmes) renvoient souvent un texte déformé ou halluciné, car les modèles de vision ne sont pas très doués pour transcrire le texte. Et, comme tout modèle d'IA, l'outil d'extraction peut halluciner : il peut décrire avec assurance un matériau, une marque ou un détail qui ne figure pas réellement dans l'image. Traitez donc la sortie comme un brouillon à vérifier par rapport à l'image d'origine, et non comme une transcription exacte : lisez-la, supprimez ce qui ne va pas, conservez ce qui est utile. En une dizaine de secondes, vous pouvez extraire un prompt. Extraire un prompt décrit un style ; cela ne transfère pas la propriété. Bien utilisé, c'est un outil d'apprentissage et d'idéation — un moyen de comprendre pourquoi une image fonctionne et de créer quelque chose de nouveau dans la direction que vous admirez. Utilisé avec négligence, il glisse vers le plagiat. Une limite raisonnable est la suivante : inspirez-vous de l'éclairage, de la composition et de l'atmosphère, mais ne reproduisez pas l'œuvre emblématique d'un artiste vivant, un personnage protégé par le droit d'auteur ou un logo de marque pour le faire passer pour le vôtre, surtout à des fins commerciales. Un « style » général n'appartient à personne, mais une expression spécifique et reconnaissable peut appartenir à quelqu'un. C'est exactement à cela que sert le workflow de « remplacement » : changez le sujet, la scène ou l'angle, et rendez le résultat réellement vôtre. L'outil Image to Prompt est-il gratuit ? Oui. Vous pouvez téléverser une image et générer un prompt sur YouMind sans payer. Quels formats d'image sont pris en charge ? JPG et PNG, entre autres, ce qui couvre la plupart des photos, captures d'écran et images exportées. Avec quels outils d'IA les prompts générés peuvent-ils être utilisés ? Avec n'importe quel modèle text-to-image. La sortie est du texte brut, elle fonctionne donc avec Nano Banana Pro, GPT Image 2, Midjourney, Stable Diffusion, DALL·E, et plus encore. Va-t-il recréer exactement la même image ? Non, et c'est voulu. Il vous donne le prompt qui se cache derrière le style afin que vous puissiez générer votre propre version, et non une copie pixel par pixel. Ai-je besoin d'expérience pour écrire des prompts ? Non. Tout l'intérêt d'image-to-prompt est de vous épargner la rédaction manuelle. Vous pouvez affiner le résultat, mais vous n'avez pas à repartir de zéro. La prochaine fois qu'une image arrête votre défilement, vous n'avez pas à deviner le texte qui se cache derrière, et vous n'avez pas à vous contenter de la copier. , façonnez-le selon vos envies et créez quelque chose de réellement vôtre.
L'IA Brise les Anciens Conteneurs de la Pensée Humaine
La première fois que c'est arrivé, tout le bureau s'est figé. Puis quelqu'un a murmuré : « Putain de merde. » Un chœur entier a suivi. Un texte statique sur un écran venait de se transformer – juste devant nous – en quelque chose de réactif, de fluide, presque respirant. C'était la première exécution réussie de la Vue Dynamique de Gemini 3 au sein de YouMind, avec Nano Banana Pro et son moteur de génération d'images. Et bien sûr, j'ai dû l'essayer moi-même. Le problème, c'est que… je n'avais aucune imagination à ce moment-là. J'ai donc choisi la première idée qui m'est venue à l'esprit : Et si je transformais ma fastidieuse newsletter sur l'IA en La Gazette du Sorcier – le journal aux portraits animés de Harry Potter ? Je l'ai construite. Ça a marché. La Gazette du Sorcier interactive, édition Newsletter IA. Obtenez le même effet Et pendant un instant, j'ai honnêtement cru que j'allais pleurer. Le contenu n'avait rien de spécial – juste les mises à jour habituelles sur l'IA que je publie chaque semaine. Mais maintenant, ces mêmes mots dansaient dans un grand format vivant et enchanté qui ondulait de mouvement et d'émotion. Je ne pouvais pas détourner le regard. Et c'est là que la vraie question m'a frappé : Si cette chose peut rendre un contenu médiocre si captivant, que pourrait-elle faire avec quelque chose de vraiment génial ? À première vue, cela ressemble à un tour visuel sympa. Une animation sophistiquée. Un journal magique. Mais c'est la petite histoire. La grande histoire, c'est que cela brise un sort sous lequel nous sommes depuis des milliers d'années – un sort qui ressemble étrangement à une version plus douce de la Novlangue d'Orwell. En 1984, le régime crée la Novlangue, une langue qui réduit l'étendue de la pensée humaine. Supprimez le mot liberté, et les gens finissent par perdre le concept de liberté. Compressez le langage, compressez la pensée. Mais voici la vérité inconfortable : vous et moi avons également vécu sous notre propre forme de Novlangue. Non pas imposée par un régime, mais par quelque chose de plus subtil : La technique. Dans votre esprit, les idées ne sont pas linéaires. Elles sont tridimensionnelles, superposées, spatiales – comme un palais avec des pièces, des escaliers et des portes cachées. Mais à moins d'être peintre, architecte ou musicien, vous ne pouvez pas l'exprimer de la manière la plus vivante. Vous êtes obligé de tout aplatir sur la bande étroite du texte linéaire. Une phrase après l'autre. Une idée pressée derrière la suivante. Dès que la pensée quitte votre esprit, elle perd sa profondeur. Même à l'ère d'Internet, ce problème n'a pas disparu. Vous savez qu'une page web pourrait être spatiale, interactive, dynamique – mais vous ne savez pas coder, ni concevoir, ni orchestrer une mise en page. Alors vous vous repliez sur des documents statiques, la zone de sécurité où la complexité doit se réduire pour s'adapter. La technique compresse l'expression. Et en compressant l'expression, elle compresse la pensée elle-même. C'est pourquoi votre idée semble brillante dans votre tête mais décevante sur la page. Le conteneur tue l'énergie bien avant que le monde n'ait la chance de la voir. Mais lorsque Gemini 3 fusionne avec Nano Banana Pro au sein de YouMind, ce plafond se fissure enfin. Pour la première fois, le texte, les visuels, le mouvement et l'interaction s'écoulent ensemble dans un seul médium que n'importe qui peut contrôler. Pour la première fois, vous pouvez exprimer une pensée spatiale comme une pensée spatiale. Non pas parce que vous connaissez le design – mais parce que l'IA rend le design perméable. C'est le charme anti-Novlangue : l'IA rend le droit de penser – auparavant volé par la technique – aux créateurs. Lorsque le conteneur s'étend, l'esprit s'étend avec lui. Il y a une autre barrière que l'IA dissout discrètement : l'esthétique. Autrefois, la beauté était un privilège. À l'École des Beaux-Arts de Paris, les professeurs parcouraient les ateliers d'examen et triaient silencieusement les dessins des étudiants en deux piles : continuer et partir. Aucun critère. Aucune explication. L'esthétique était un langage privé, accessible uniquement à ceux qui avaient du temps, de la richesse et une formation. YouMind peut désormais générer des interfaces avec un rythme, une hiérarchie et une harmonie naturels. Vous n'avez pas besoin de « connaître le design » pour exprimer quelque chose qui a l'air conçu. La beauté devient une infrastructure publique. Et une fois que la peur de « rendre les choses jolies » disparaît, les créateurs peuvent enfin revenir à la vraie question : quel genre de monde spirituel est-ce que je veux construire ? Si l'esthétique est le visage, la livraison de valeur est l'âme. Dans les années 1990, McKinsey a redéfini le conseil en passant des « Livres Bleus » denses aux présentations PowerPoint épurées et visuelles. Cela a changé non seulement la façon dont la connaissance était présentée, mais aussi la façon dont elle était valorisée. Aujourd'hui, YouMind se trouve au moment McKinsey, mais multiplié. Pour les consultants, les éducateurs, les chercheurs – tous ceux dont le travail est la connaissance – les documents ne sont plus le produit final. Ce sont des ingrédients bruts. Le véritable produit est l'interface : une expression vivante et interactive de vos idées. Vous ne vendez plus de l'information. Vous vendez une expérience de compréhension. Il y a un siècle, le Mouvement de la Nouvelle Culture en Chine a lutté pour le droit d'écrire en langue courante – le vernaculaire au lieu du classique. L'argument était simple : l'expression est un droit. Pas un privilège. Aujourd'hui, nous sommes dans un nouveau type de mouvement culturel : le droit d'utiliser l'espace, le mouvement et l'interaction pour construire les mondes que nous imaginons. Pour la première fois dans l'histoire : Un écrivain peut penser comme un architecte. Un étudiant peut composer des idées comme un réalisateur. Un chercheur peut présenter des informations comme un concepteur d'infographies. Vos créations ne restent pas simplement sur une page. Elles se tiennent debout. Elles respirent. Elles conversent. Il y a une ironie discrète ici. Vous lisez ceci dans un document texte – alors que j'explique pourquoi le texte ne suffit plus. Le texte reste le moyen le plus rapide de capturer une étincelle. Mais ce n'est plus la limite de ce que cette étincelle peut devenir. Tout comme la philosophie au cœur de YouMind : « Tout commence par un brouillon. Et un brouillon devient tout. » Le texte est la graine. Ne la laissez pas piégée dans le bocal. Ce brouillon et les visuels qui l'accompagnent ont été co-créés avec YouMind.