Deconstrucción visual 9D
Desmonta infografías y crea prompts replicables
Deconstrucción visual 9D
Desmonta infografías y crea prompts replicables
Vista previa
Descripción
Descompone una o varias infografías, visualizaciones de datos, diagramas de flujo, líneas de tiempo, mapas, mapas de conocimiento y organigramas en estructuras visuales y de información reutilizables. Te ayuda a entender con precisión por qué una imagen está organizada de determinada manera y a reconstruir un resultado expresivo similar. La habilidad analiza factores visuales como la composición espacial, las dimensiones y los materiales, la jerarquía cromática, la tipografía y la maquetación, y las relaciones entre módulos. También identifica la codificación de los gráficos, la ruta de lectura, las metáforas visuales y las relaciones geográficas o de red, para que el análisis no se limite a describir «a qué estilo se parece». Obtendrás un resultado de deconstrucción visual parametrizado que abarca la lógica del lienzo y la composición, la jerarquía visual, la densidad del texto, la topología de los módulos, las formas de expresar datos y relaciones, y el recorrido narrativo de la imagen. En contenidos como gráficos estadísticos, mapas o redes de relaciones, el resultado se centra en cómo los datos se representan mediante variables visuales como el color, la posición, el tamaño, las conexiones y los nodos. En el caso de diagramas temáticos complejos, también organiza las relaciones de colaboración entre los sistemas de formas, texto y metáforas. A partir de estos análisis, la habilidad genera prompts detallados y claramente estructurados en inglés para la generación de imágenes, adecuados para reproducir infografías, investigar referencias visuales, explorar diseños y contenidos de marca, y crear imágenes conceptuales. Tanto si proporcionas una imagen existente como una idea sobre el tema y la dirección visual, obtendrás prompts orientados a una reproducción estructural más fiel, en lugar de una descripción general del estilo.
Habilidades relacionadas
Ver todo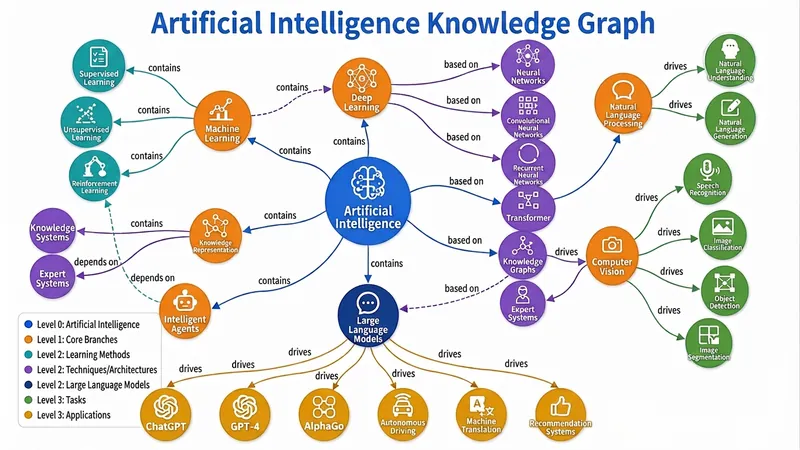
Motor de grafos de saber
Construye automáticamente cinco tipos de grafos (grafos de conocimiento, mapas mentales, mapas conceptuales, diagramas de flujo/arquitectura y diagramas de relaciones) a partir de texto, archivos o temas. Ofrece una solución triple que genera páginas web interactivas, imágenes estáticas y código de visualización con los más altos estándares. Integra las mejores prácticas de ingeniería de grafos de conocimiento y visualización de información, con control dinámico de granularidad, desambiguación y deduplicación, y validación cruzada multifuente. Convierte tu texto, archivos e incluso un pensamiento en un grafo de conocimiento interactivo, arrastrable, ampliable y buscable en un instante, y exporta imágenes de alta resolución y código listo para usar con un solo clic: este es el motor triple de visualización de conocimiento que nunca antes habías experimentado. 🧠 ¿Qué es el «Motor de grafos de saber»? No es la típica herramienta de dibujo que conoces, sino un ingeniero del conocimiento + experto en visualización que vive en tu navegador. Dale un texto de estudio, un artículo, un PDF, o solo una palabra clave, y automáticamente: 🔍 Extrae las entidades principales y aclara las relaciones profundas. 🧱 Construye un grafo JSON estructurado (grafo de conocimiento, mapa mental, mapa conceptual, diagrama de flujo, diagrama de relaciones). 🎨 Produce tres formas de primera clase: página web interactiva + imagen estática de alta resolución + código Markdown/Mermaid/Graphviz. A partir de ahora, organizar información ya no requiere dibujar cajas manualmente, y presentar conocimiento ya no es solo una imagen estática. ⚡ ¿Por qué decimos que es de primera clase? 1. Línea de producción completamente automática «del texto al grafo» No necesitas aprender ningún lenguaje de modelado, ni definir nodos y conexiones manualmente. Solo ingresa contenido y el motor determinará automáticamente el tipo de grafo: ¿Sistema de conocimiento de una materia? → Genera un grafo de conocimiento semánticamente rico. ¿Desglose de notas de lectura? → Genera un mapa mental con jerarquías claras. ¿Procesos y decisiones? → Genera un diagrama de flujo/arquitectura con ramificaciones. ¿Red de relaciones personales? → Genera un diagrama de relaciones multidimensional. Incluso si solo le das una palabra temática, puede recopilar información por sí mismo y completar el contenido antes de generar el grafo. 2. Salida triple que cubre todos los escenarios de uso 🖱️ Página web interactiva con D3.js: arrastra nodos, zoom con rueda, haz clic para ver detalles, resalta rutas de relación, búsqueda por palabras clave... como operar un mapa vivo. Archivo HTML único, sin backend, que se puede incrustar en cualquier página o enviar a cualquiera. 🖼️ Grafo estático de alta resolución: diseño de fuerza dirigida, clasificación por colores, listo para usar en ilustraciones de artículos, presentaciones PPT, materiales didácticos, tan claro que cada etiqueta es nítida y legible. 📜 Código de visualización: genera simultáneamente código fuente de Mermaid y Graphviz, que los desarrolladores pueden insertar directamente en documentación, wiki, Notion, con edición secundaria para una expansión ilimitada. 3. Diseño de experiencia de usuario extremo 🎨 Colores asignados automáticamente por tipo de entidad, jerarquías expresadas intuitivamente por el tamaño de los nodos. 🔗 Las etiquetas de relación se muestran directamente en las curvas, para entender de un vistazo «contiene», «causa», «soporta». 💡 Al hacer clic en cualquier nodo, las partes no relacionadas se desvanecen automáticamente, enfocando la ruta de pensamiento. 🔄 Restablecer diseño, búsqueda de ubicación, zoom y desplazamiento... todas las operaciones son fluidas. 4. Sabiduría de ingeniería que equilibra «amplitud» y «profundidad» Desde la desambiguación y deduplicación de entidades hasta la validación cruzada multifuente; desde el control de granularidad jerárquica hasta las conexiones de puntos para relaciones entre dominios: detrás de esto están las mejores prácticas de ingeniería de grafos de conocimiento. No es un juguete, es una herramienta de productividad. 👥 ¿Quién lo necesita más? Profesores y creadores de contenido educativo Convierte capítulos enteros de un libro de texto en un mapa de conocimiento interactivo; los estudiantes entienden las relaciones conceptuales con un solo clic. Investigadores y estudiantes Las revisiones bibliográficas ya no se basan solo en texto; un solo grafo aclara los hilos teóricos de decenas de artículos. Gerentes de producto y arquitectos empresariales Arquitectura de sistemas, procesos de negocio, descomposición de funciones: genera diagramas de arquitectura al instante, duplicando la eficiencia de la comunicación. Lectores y aprendices de por vida Las notas ya no son solo esquemas, sino redes de pensamiento explorables que hacen que el conocimiento realmente «crezca» junto. 🚀 Ahora, haz que tu conocimiento «cobre vida» Tú das contenido, él da perspectivas. Tú das un tema, él da un sistema. Tú das una necesidad, él da un entregable completo de página web, imagen y código. Esto no es una función, es un flujo de trabajo que eleva la información a cognición. Deja que el «Motor de grafos de saber» sea una extensión de tu pensamiento, visualiza tu experiencia y alcanza el «momento ajá» de cada audiencia. —— A partir de hoy, ya no «dibujes» grafos, sino «genera» grafos.
 Imagen
Infografías virales de todo
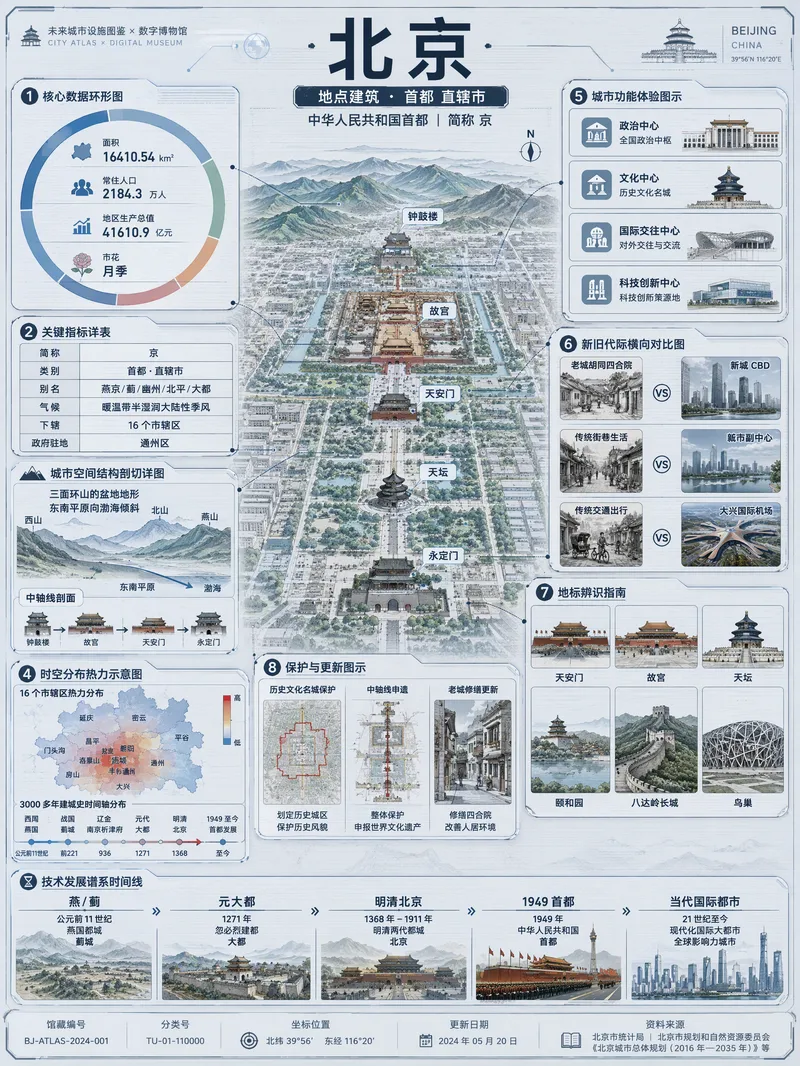
Convierte rápidamente el nombre de un objeto en un póster de atlas científico que combina gran densidad de conocimiento y una potente expresión visual. Ya se trate de un ser vivo, un mineral o material, un objeto creado por el ser humano, un lugar o edificio, un concepto cultural o una figura histórica, organiza la información según tu público, tus prioridades y el idioma que indiques, para crear contenidos adecuados para mostrar y compartir. Primero, la skill verifica mediante búsquedas web en tiempo real datos como la definición, las cifras clave, la composición estructural, la distribución, las aplicaciones, la evolución y los rasgos de identificación. Después, organiza el contenido en una infografía vertical de proporción 3:4. El póster toma como centro visual un sujeto principal con aspecto de espécimen y lo rodea con nueve grupos de módulos informativos adaptables, que abarcan indicadores clave, análisis estructural, distribución en el espacio y el tiempo, explicaciones de contexto, comparaciones, claves de identificación, consejos de conservación o mantenimiento y una línea temporal de desarrollo. Los temas y el foco de los módulos se ajustan al tipo de objeto. El resultado utiliza cartulina tecnológica en gris azulado claro, trazos técnicos precisos, colores aguamarina y azul verdoso de baja saturación y una textura de escaneo semitransparente. Así presenta un estilo visual que combina un atlas de infraestructuras urbanas del futuro con un panel de museo digital, conservando la identificación del objeto en la parte superior y la zona de datos de la colección en la inferior. Cuando los datos son insuficientes o el objeto es poco conocido, las posibles inferencias se distinguen mediante un área de avisos visuales. Es adecuado para educación divulgativa, presentaciones de exposiciones, intercambio de conocimientos y publicaciones en redes sociales.
 Imagen
Generador de aware, wabi y yūgen
Convierte temas, escenas, personas, poemas clásicos chinos o fotografías en imágenes basadas en la estética japonesa, con referencias conceptuales y visuales claras. Es ideal para creadores que necesitan una narrativa delicada y dirección artística. La habilidad elige entre mono no aware, wabi-sabi o yūgen como enfoque principal según el contenido: mono no aware expresa la belleza de lo que se desvanece; wabi-sabi muestra las huellas que dejan los materiales y el paso del tiempo; yūgen crea una profundidad sutil mediante lo oculto, la distancia, el espacio vacío y lo que no se ve. Solo los combina cuando el tema presenta realmente varias lógicas estéticas. Obtendrás un análisis claro del tema, la estética dominante, la relación entre los enfoques, referentes de historia del arte y la narrativa central. Después, generará prompts visuales profesionales que incluyen sujeto, entorno, composición, capas espaciales, materiales, color, luz, emoción y restricciones negativas, evitando tratar «japonés», «zen» o «sofisticado» como etiquetas vacías. En el caso de fotografías de personas, intentará conservar su identidad, estructura facial, edad aparente, complexión y rasgos principales de la vestimenta, y realizará la transformación estética mediante el entorno, la luz y la narrativa, en lugar de convertirlas por defecto en personajes con kimono. Tras tu confirmación, la habilidad mostrará el prompt completo y generará la imagen. También ofrecerá una explicación estética para ayudarte a entender cómo la escena refleja la belleza de lo que se desvanece, de las huellas del tiempo o de lo invisible. Es adecuada para arte conceptual, transformación de estilos fotográficos, visualización de poemas clásicos, creación de escenas con personas, narrativa espacial y generación de imágenes con IA inspirada en la estética japonesa.
Información
- Versión
- v3
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Automático