Cómo convertir un PDF, páginas web y notas en una presentación para clientes con YouMind (Guía completa)
Relacionado: Elegir una Skill de presentación → 10 Skills para presentaciones profesionales. Terminar una presentación a partir de tus materiales → este artículo.
Qué resuelve este tutorial (30 segundos)
Ya tienes un informe en PDF, dos páginas de referencia y tus propias notas. Necesitas una presentación ejecutiva lista para entregar en unas horas, no otro resumen de cinco pasos del tipo “recopilar → estructurar → generar → editar → exportar”.
Este artículo recorre un caso real de YouMind de principio a fin: la lista de fuentes, qué descartamos, qué falló en el primer borrador, correcciones página por página, una opción de estilo que rechazamos y los límites de exportación que debes conocer antes de prometer un “PowerPoint editable”. Cuando termines, deberías poder repetir el proceso con tu PDF y tus notas, y saber exactamente qué corregir después de la generación.
Escenario (fijo): un briefing interno al estilo de un trabajador del conocimiento o asesor. En esta demo, el briefing plantea qué dos flujos de trabajo con IA podría probar un pequeño equipo de contenidos el próximo mes. Aquí no nos extendemos a casos de uso estudiantiles, comerciales ni de formación; si buscas Skills o estilos, usa la colección enlazada arriba.
Configuración del caso y lista de fuentes
- **Objetivo** — Proponer dos pilotos de cuatro semanas de flujos de trabajo con IA a un responsable de contenidos y a los editores; aclarar qué depende de las personas y cómo decidirás si se continúa
- **Audiencia — Equipo de contenidos pequeño · ~10 minutos · 8 diapositivas en inglés**
- **Nivel de exigencia** — Longitud controlable, afirmaciones listas para presentar, cada cifra clave trazable a una fuente: nada de clientes, plantillas, presupuestos o “tiempo ahorrado” inventados
- **Etiqueta** — Demostración tutorial con fuentes públicas; no es un proyecto con cliente ni un plan interno aprobado
Fuentes
- Fuente: Microsoft 2026 Work Trend Index (PDF) · Rol: Principal · Resultado: Conservada; números de página impresos usados para verificación
- Fuente: Anthropic Economic Index: Cadences (web) · Rol: De apoyo · Resultado: Conservada; citada por capítulo
- Fuente: Stanford 2026 AI Index — Economy (web) · Rol: Apoyo previsto · Resultado: Excluida: la captura solo trajo navegación/CSS, sin cuerpo de texto
- Fuente: Brief del proyecto / Notas de investigación / Brief original · Rol: Afirmación, prohibiciones, audiencia · Resultado: Conservada; la configuración empezó en chino, pero el idioma de entrega se fijó en inglés antes de generar las diapositivas
Tres preguntas antes de generar (criterio #0)
Escríbelas primero. Cada decisión posterior depende de ellas.
- ¿Qué decisión debe tomar la audiencia? Aprobar dos pilotos de cuatro semanas —y sus reglas de parada— antes de que nadie empiece.
- ¿Qué afirmación estamos defendiendo? Los datos de uso son una razón para hacer una prueba pequeña, no una previsión de ahorro. Ambos flujos son propuestas; aún no se ha medido nada.
- ¿Qué está prohibido? Inventar clientes, plantillas, presupuestos o ganancias de eficiencia; generalizar los usuarios de un producto a toda una industria; cualquier cifra sin fuente, población y denominador.
Una decisión más en esta ejecución: la nota de tarea original y el esquema preliminar estaban en chino. Antes de generar las diapositivas, el idioma de entrega se fijó en inglés; el Project Brief en inglés prevalece sobre la nota anterior.
De las fuentes al esquema: qué se quedó y qué descartamos
Subir el PDF, las páginas y las notas a un mismo Board es la parte fácil. El tiempo se va en el esquema: en la selección, no en la maquetación.
Descartado (a propósito, y con registro)
- Capítulo de economía de Stanford: cuerpo de texto ilegible → excluido del argumento y etiquetado como límite de importación en la presentación y en las Research Notes. Nada de suposiciones.
- Una docena de porcentajes “disponibles pero no esenciales” (mix de resultados, mejoras autodeclaradas, comparativas salariales, etc.) → eliminados para que la presentación no sea un museo de estadísticas.
- Ventanas exactas de trabajo de campo de encuestas → las notas de la fuente se contradecían entre sí; la presentación solo dice “encuesta de 2026”.
- Plantear el Piloto 1 como una “delegación” sin revisión y el Piloto 2 como reescribir el artículo original en un “segundo borrador” → corregido: ambos pilotos requieren revisión editorial; el Piloto 2 parte de texto aprobado y nunca reescribe el artículo fuente.
- Presentar el 49 % como “de todas las conversaciones” → corregido según la nota de la cifra: proporción de objetivos de usuario clasificados (Microsoft WTI, p. 08 impresa); no es tiempo ni número de sesiones.
Solo dos datos sobrevivieron hasta las diapositivas
- D1: En las conversaciones de Copilot muestreadas, el 49 % de los objetivos de usuario clasificados apoyan trabajo cognitivo (análisis, resolución de problemas, evaluación, pensamiento creativo y afines). Fuente: Microsoft 2026 Work Trend Index, p. 08. Denominador: objetivos de usuario clasificados.
- D2: Entre las conversaciones de Claude clasificadas como relacionadas con el trabajo, los documentos e informes son el artefacto más común, con cerca del 20 %. Fuente: Anthropic Cadences, capítulo 2. Denominador: conversaciones clasificadas como trabajo.
Los denominadores distintos van en paneles separados. Nunca los fusionamos en una afirmación de ahorro.
Regla del esquema: una afirmación por diapositiva; señalar pruebas faltantes; mantenerlo en ocho diapositivas para una charla de diez minutos.
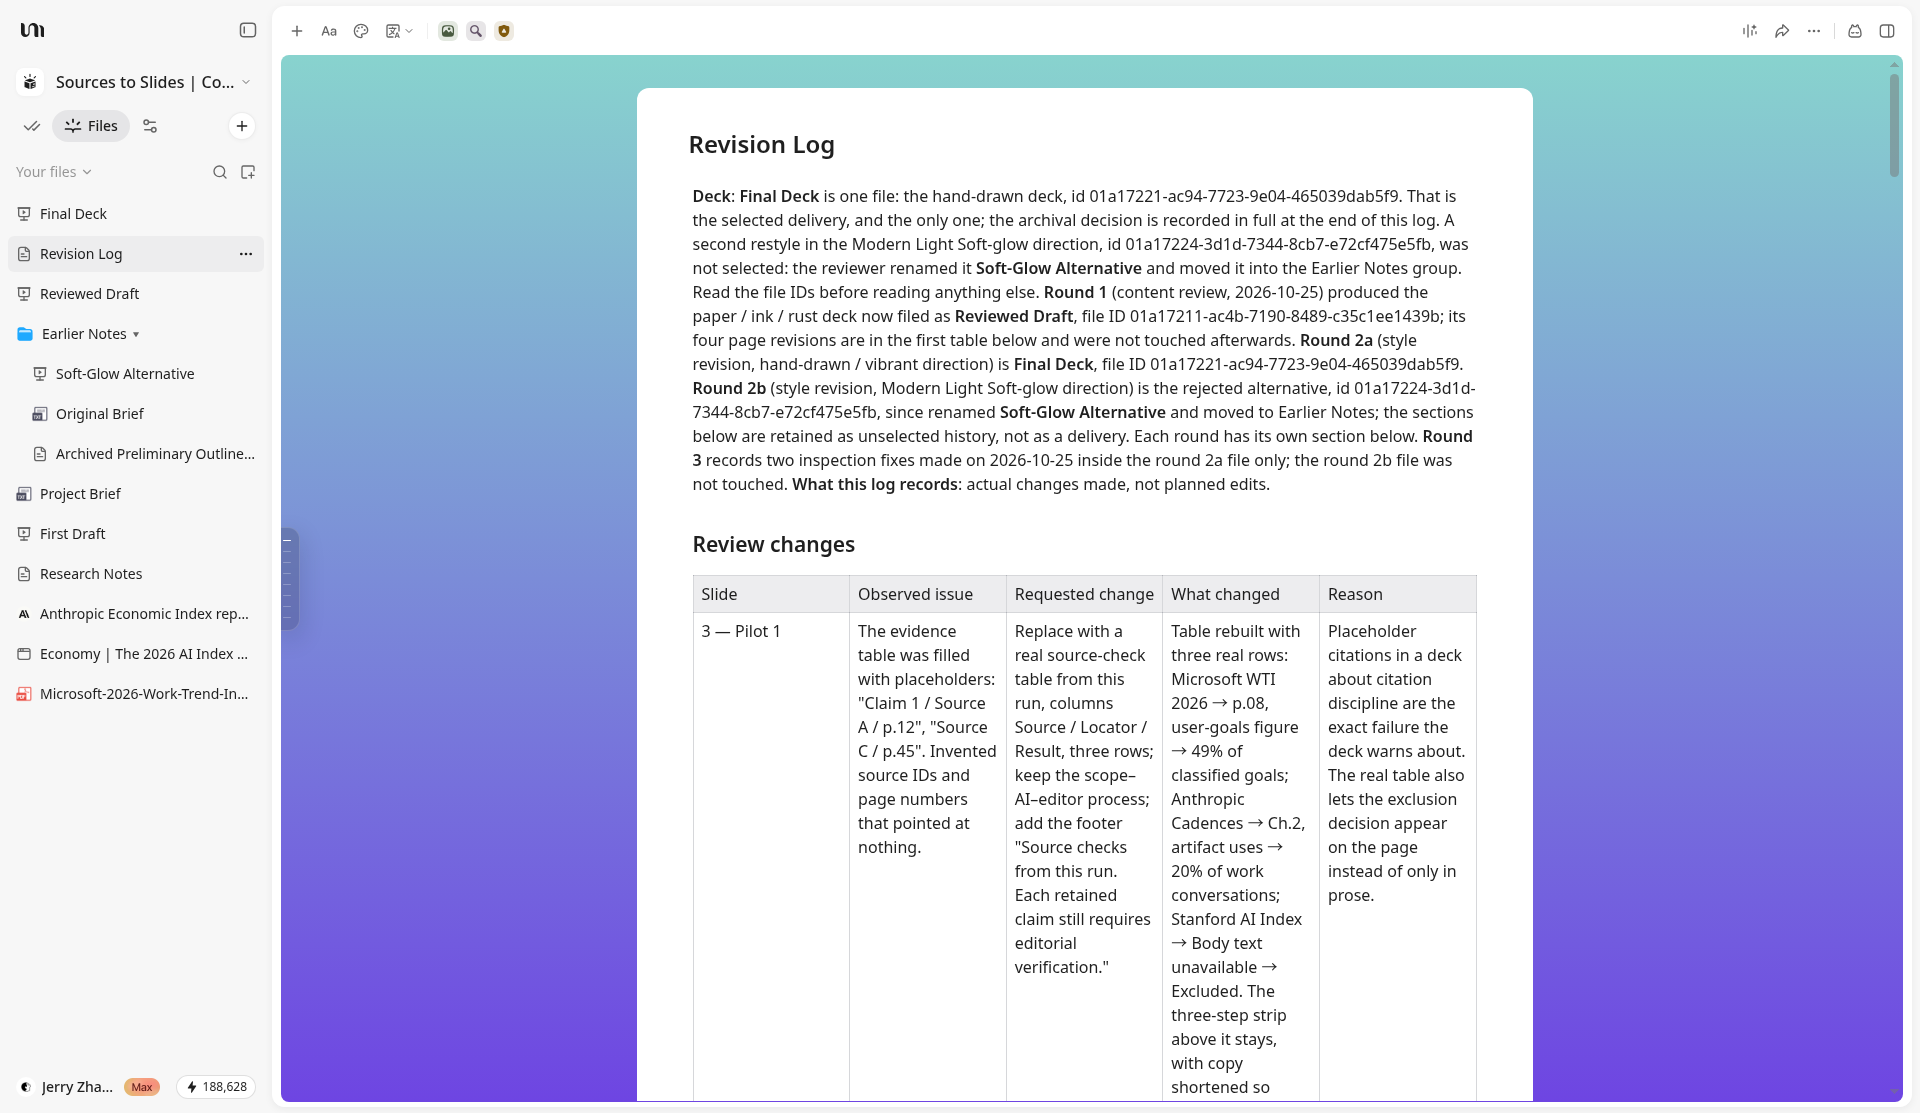
Cómo se generó realmente la presentación en este caso
- Fase: Primer borrador · Qué hicimos: Conversación en el Board “Build the Content Team Pilot Deck” (no una Skill “Architect PRO” aparte; no la nombres aquí)
- Fase: Revisión de contenido · Qué hicimos: Ronda 1 → Borrador revisado (correcciones de contenido a nivel de página)
- Fase: Visual final · Qué hicimos: Restyling completo con Vibrant handdrawn for young professional Skill (v1) → Presentación final
- Fase: Alternativa rechazada · Qué hicimos: Modern Light Soft-glow Skill (v9) → renombrada como Alternativa Soft-Glow, movida a Notas anteriores
Si aún necesitas elegir un estilo o Skill para otro trabajo, usa la colección de Skills y la galería de Skills. Las Tareas Programadas y el “mismo Board, otros formatos” ocupan como máximo una frase en este artículo: no son el eje central.
Cómo quedó el primer borrador
El Primer Borrador ya tenía una estructura completa de ocho páginas en inglés… y aun así no estaba listo para entregar.
- La portada y las páginas de recomendación se veían relativamente limpias.
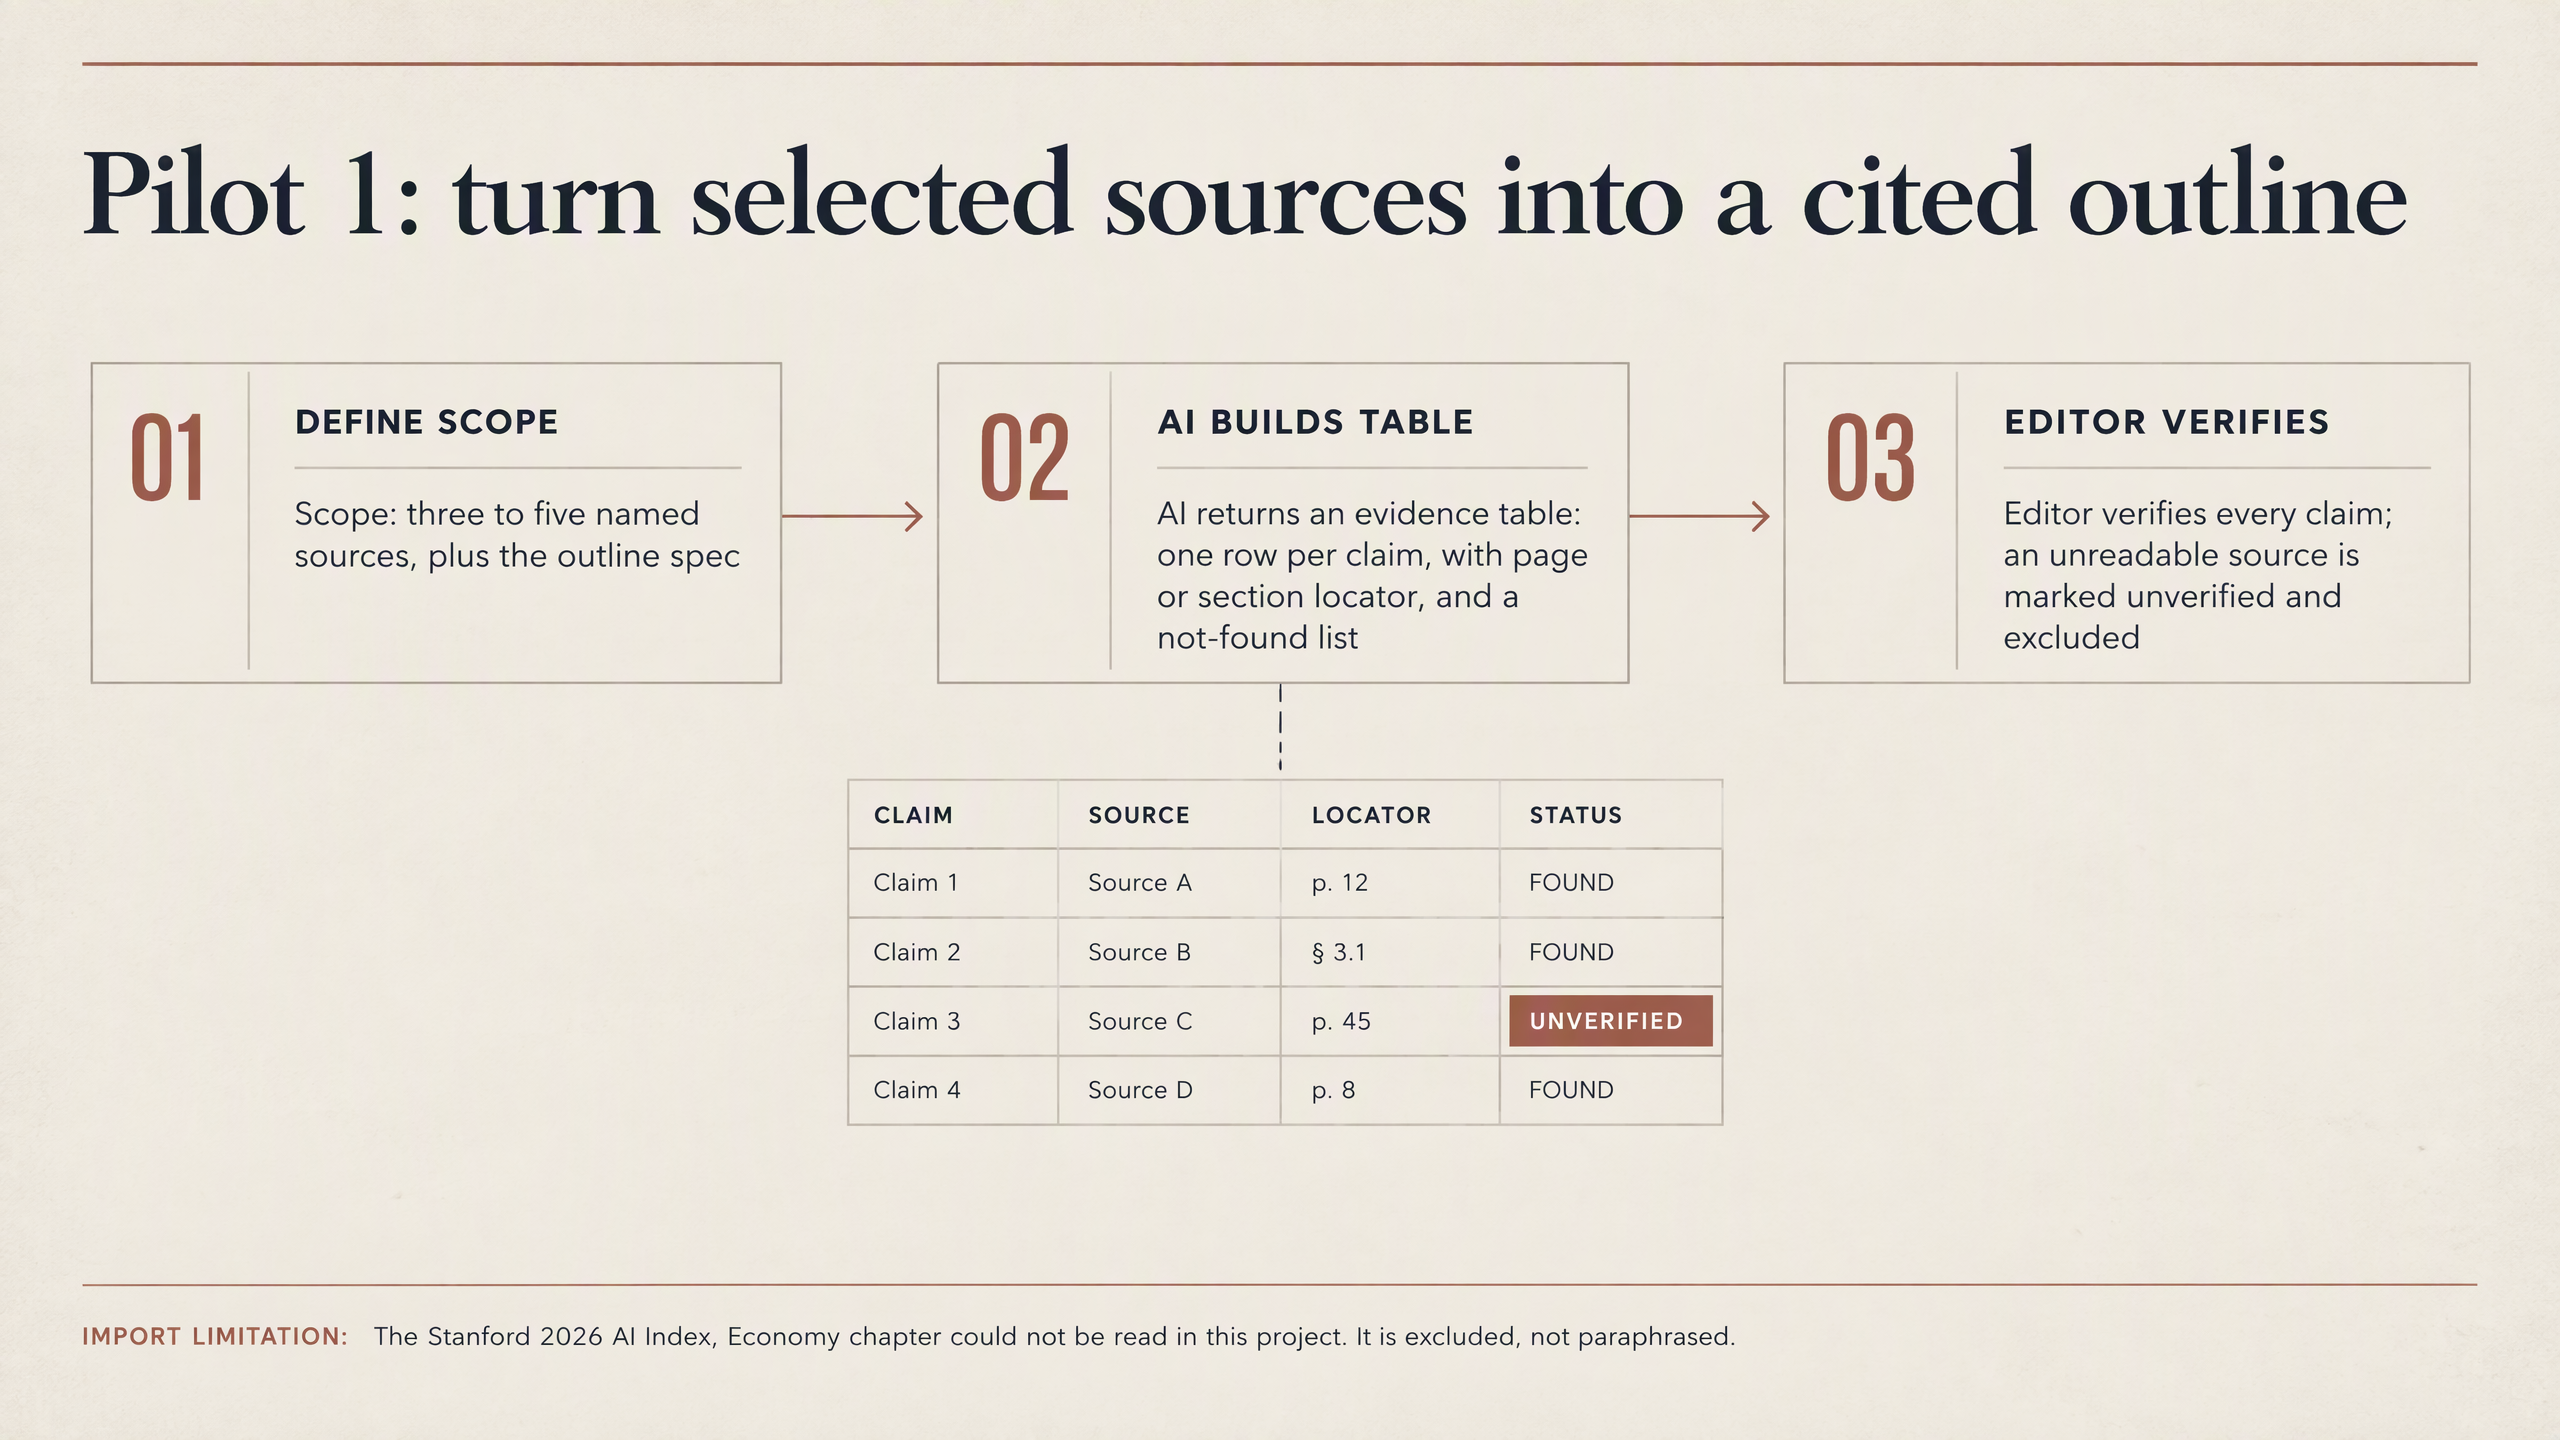
- Las páginas problemáticas ya venían de fábrica: la tabla de evidencias del Piloto 1 mostraba marcadores como “Claim 1 / Source A / p.12”; el Piloto 2 usaba tarjetas CHANNEL A/B/C que en realidad listaban pasos del proceso; la página de modos de fallo no tenía encabezados de columna y repetía la misma frase en las celdas de advertencia y de comprobación.
Pulir el tono no arregla eso. Lo arreglas contrastando con las fuentes. Todo lo que sigue viene del Registro de revisiones del Board: ediciones reales, no una lista de buenas prácticas escrita a posteriori.
Lista de comprobación de edición (el núcleo de este artículo)
1. Descarte de fuentes: las capturas vacías deben constar en la diapositiva
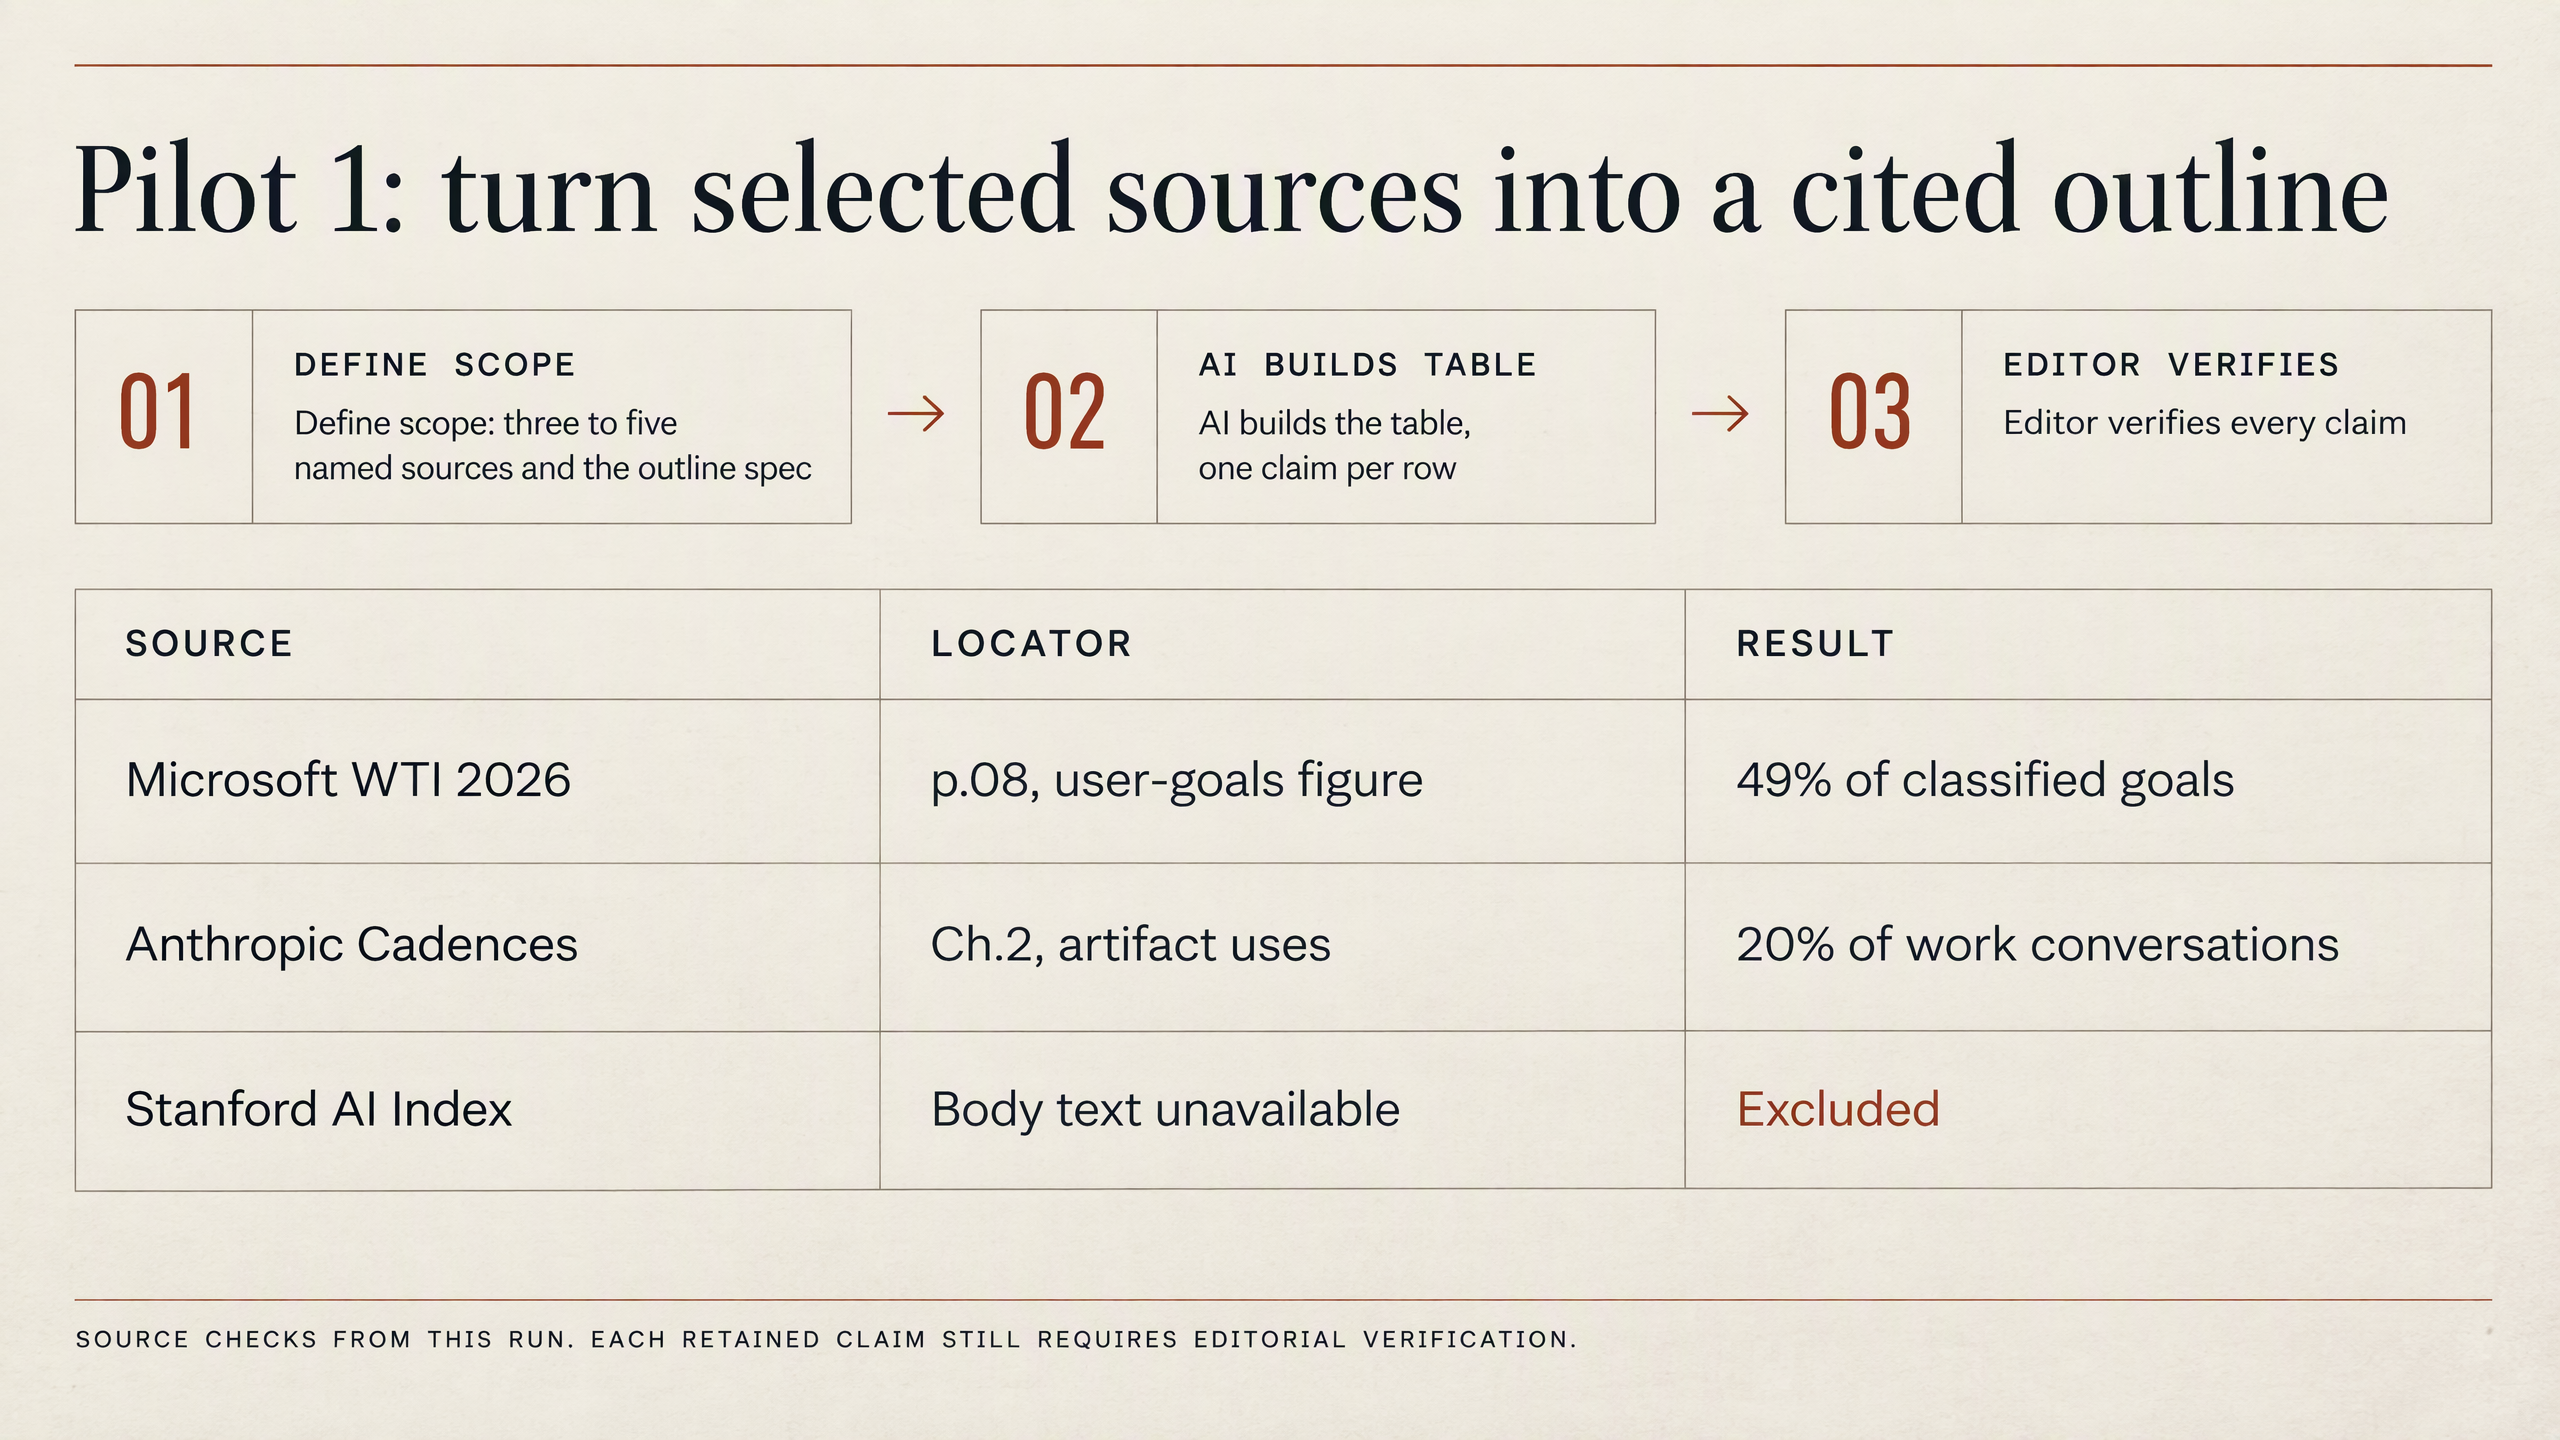
Stanford no solo se descartó en las notas. La franja de verificación de fuentes de la presentación final indica cuerpo no disponible → Excluido. En un flujo de citas, el resultado honesto suele ser “no verificado”, no una página inventada.
Hubo un segundo descarte de estilo: el restyling Soft-Glow se generó por completo y no fue seleccionado. El registro muestra dos errores HTTP 404 al intentar cancelar, por lo que el proceso siguió corriendo: es una cancelación fallida, no un test A/B tranquilo. No lo reescribas como una doble entrega intencionada.
2. Reescritura de estructura: el límite del Piloto 2
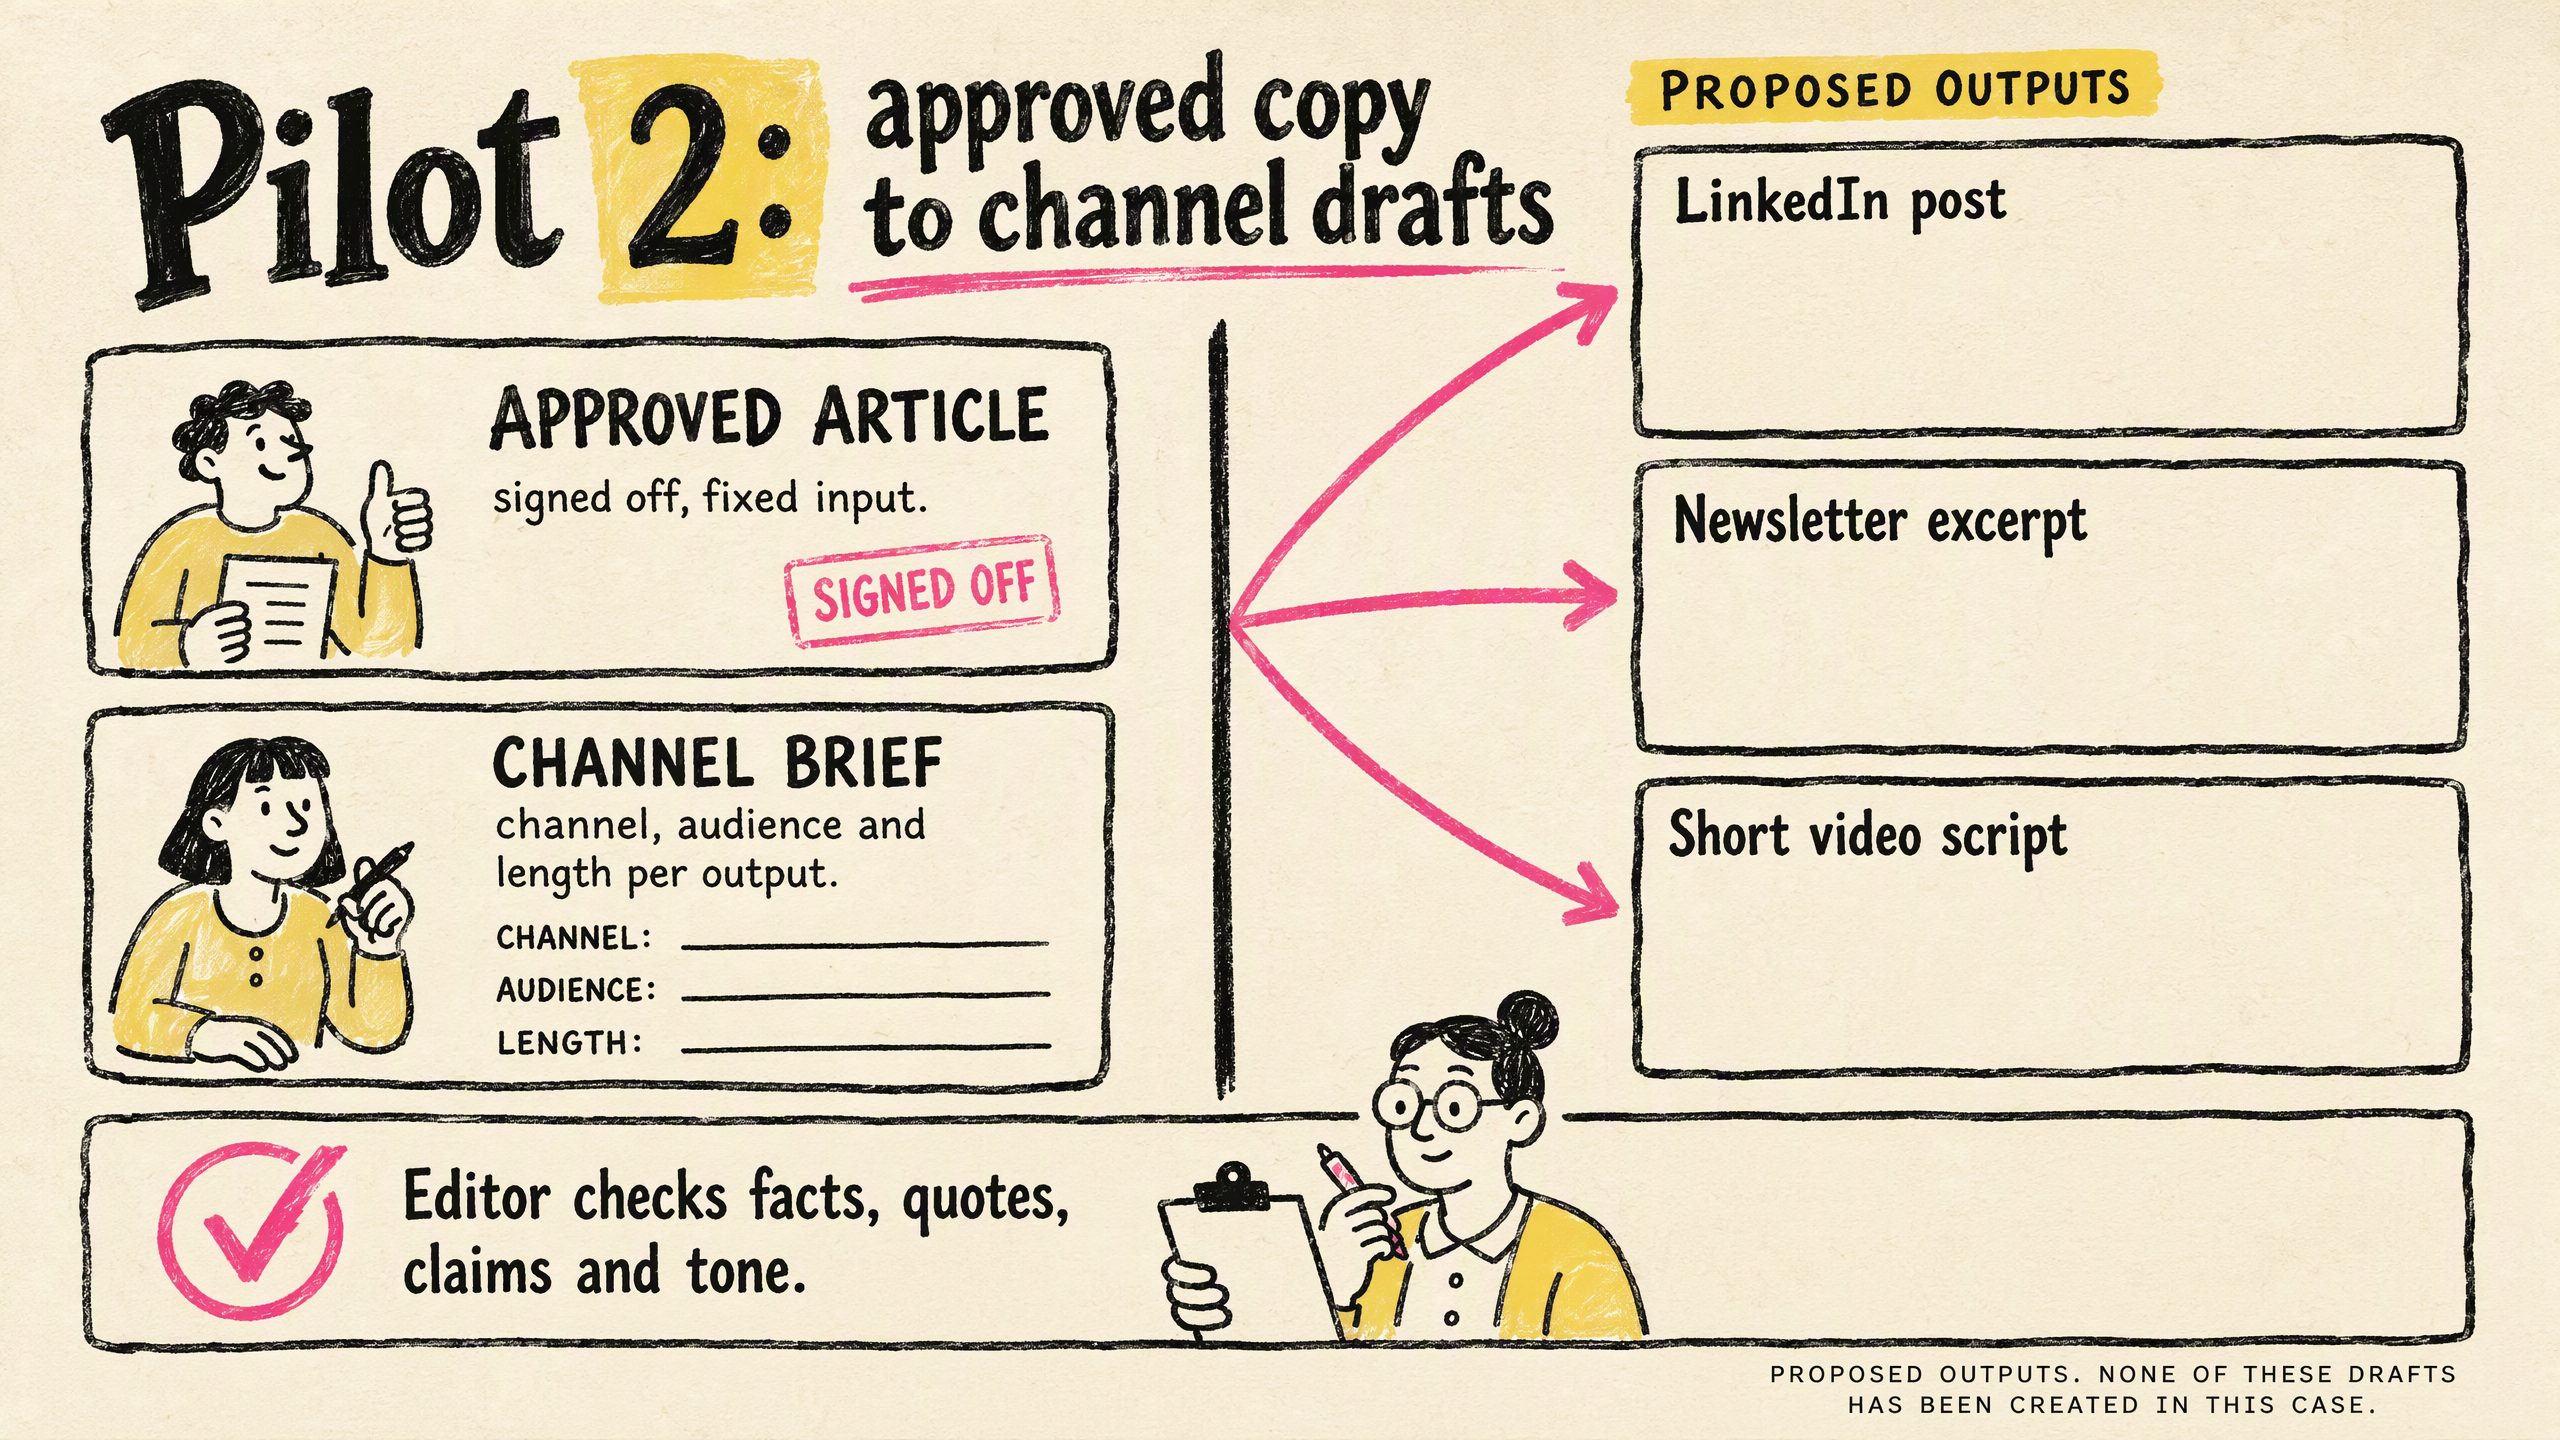
- Problema · Antes: Las tarjetas CHANNEL A/B/C contenían pasos mientras el diagrama decía “channel” · Después: Izquierda: artículo aprobado + brief de canal; derecha: tres resultados propuestos con nombre y vacíos (LinkedIn, newsletter, vídeo corto); una barra de revisión compartida
- Por qué · Antes: En este caso aún no existen borradores por canal · Después: Pie de página: resultados propuestos; ninguno creado aquí
- Segunda pasada · Antes: El texto de instrucción (“Izquierda:…”, “Derecha:…”) se coló dentro de las tarjetas · Después: Eliminado al regenerar
Afirmación bloqueada: el texto aprobado es el límite; la IA no edita el original.
3. Comprobación de cifras y citas: marcadores → tabla de fuentes real
Diapositiva 3 (Piloto 1), Ronda 1
- Problema: “Claim 1 / Source A / p.12” y similares: localizadores inventados justo en la página cuyo tema es la disciplina de citas.
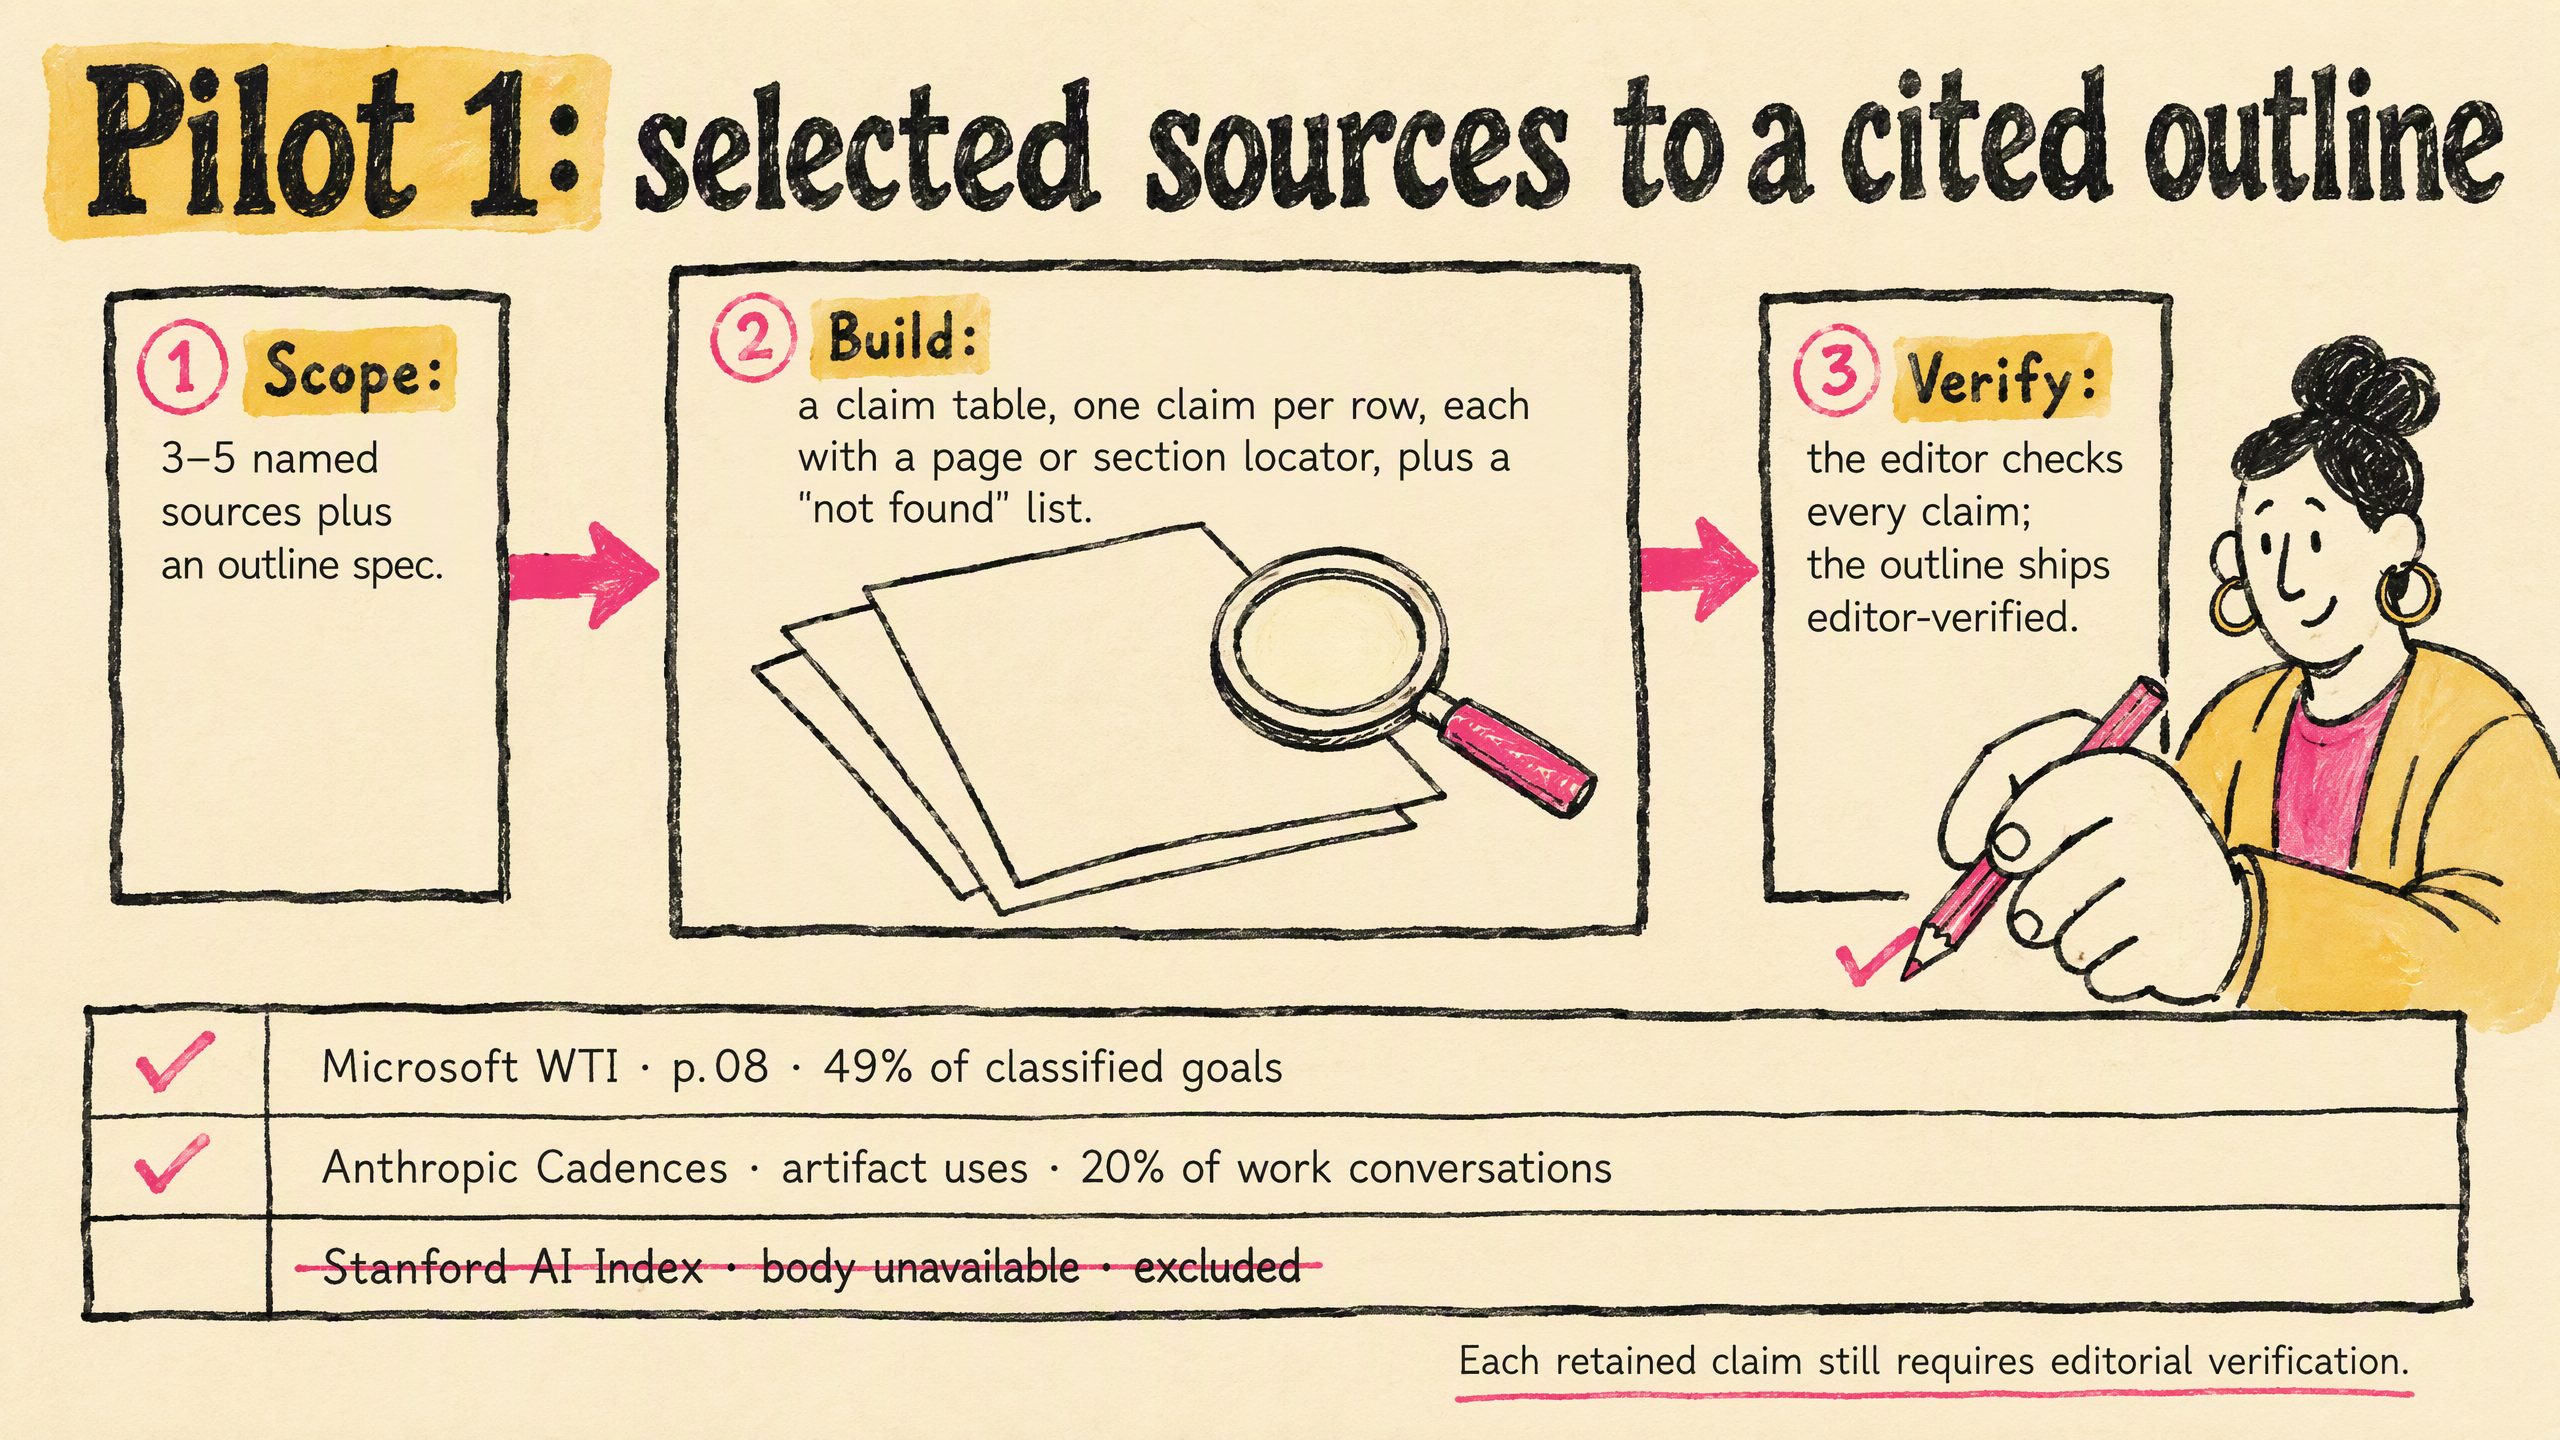
- Solución: tres filas reales — Fuente / Localizador / Resultado:
- Microsoft WTI 2026 → p. 08 → 49 % de objetivos clasificados
- Anthropic Cadences → Cap. 2 usos de artefactos → 20 % de conversaciones de trabajo
- Stanford AI Index → cuerpo no disponible → Excluido
- Pie de página: verificaciones de fuentes de esta ejecución; las afirmaciones conservadas aún requieren validación editorial.
Ronda 3 (inspección de imagen tras exportar): una minitabla central volvió a introducir localizadores falsos (“p.12”, “§ 3.1”). Solución: eliminar la minitabla por completo; sustituirla por una pila de papeles dibujada a mano sin etiquetas; conservar la franja real de tres filas debajo.
4. Corrección de claridad: página de modos de fallo
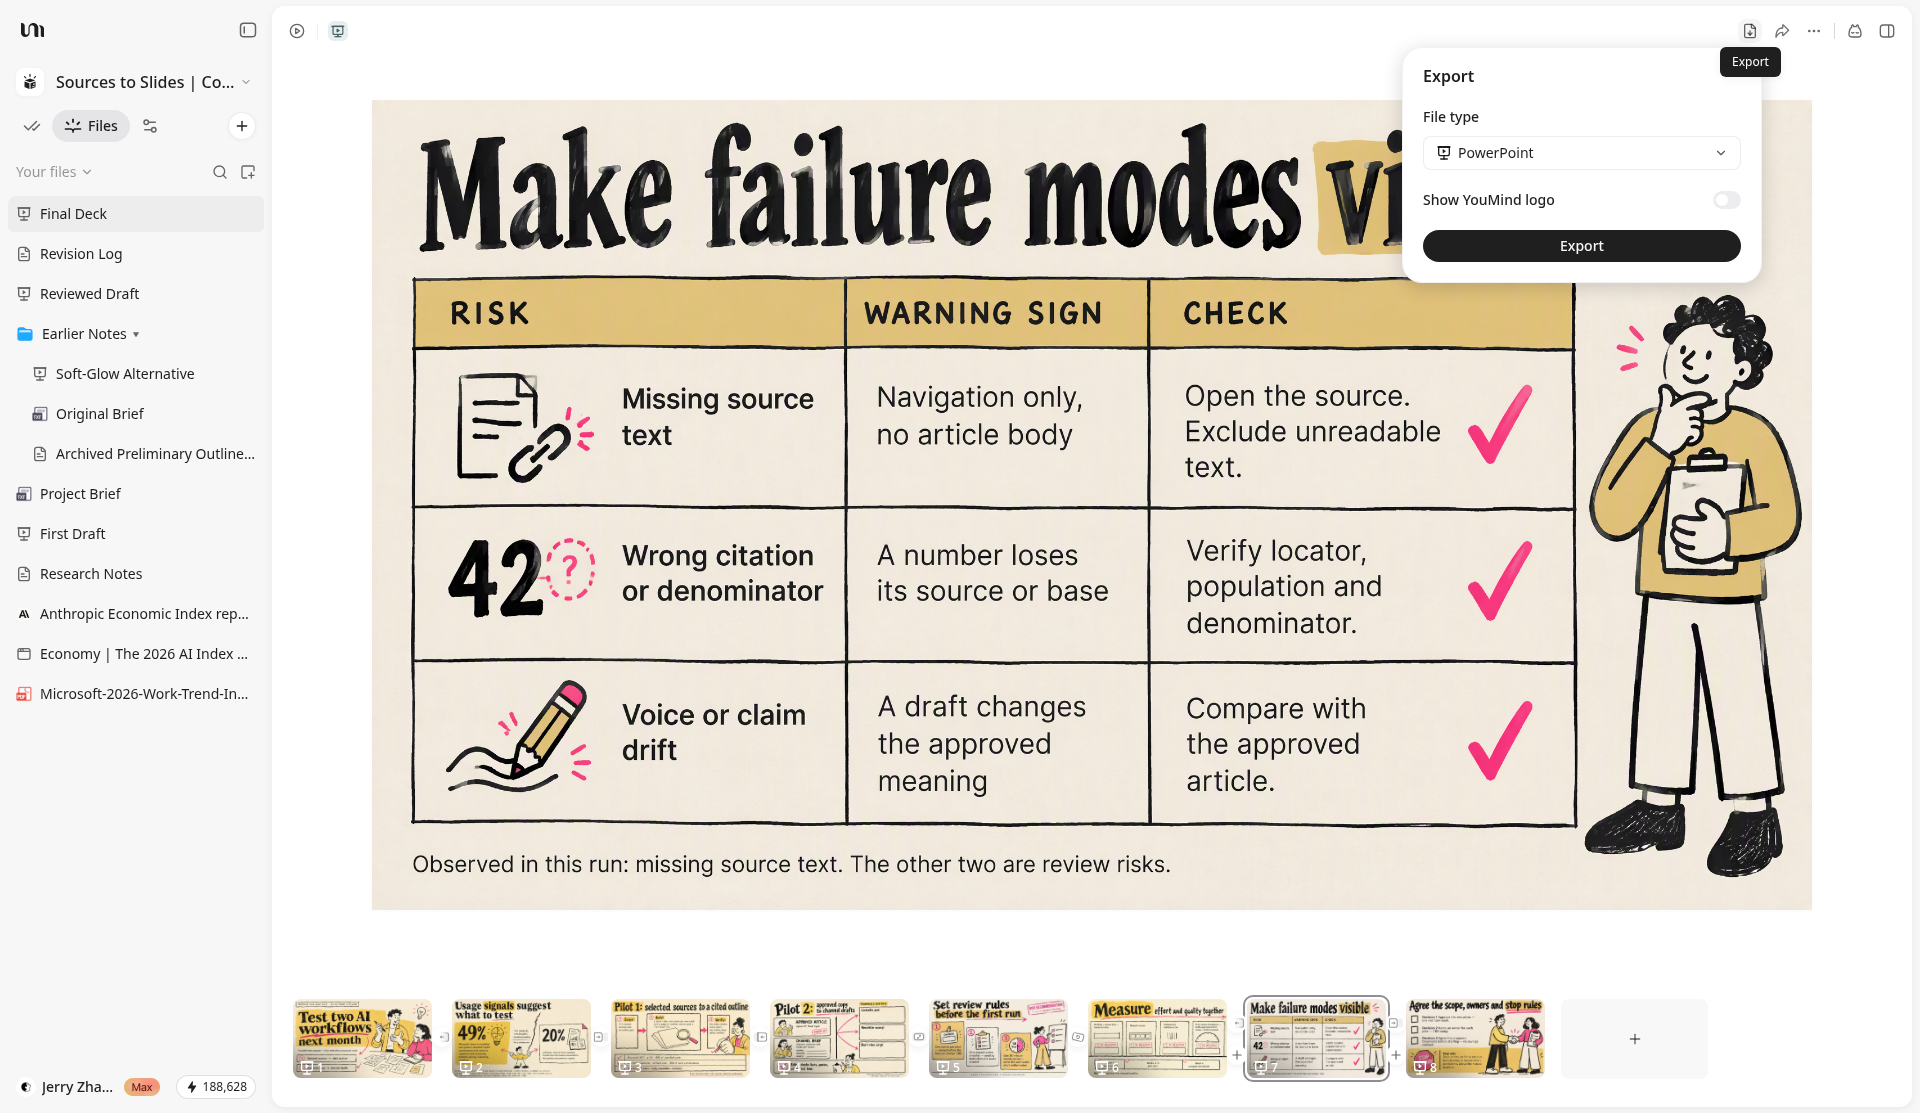
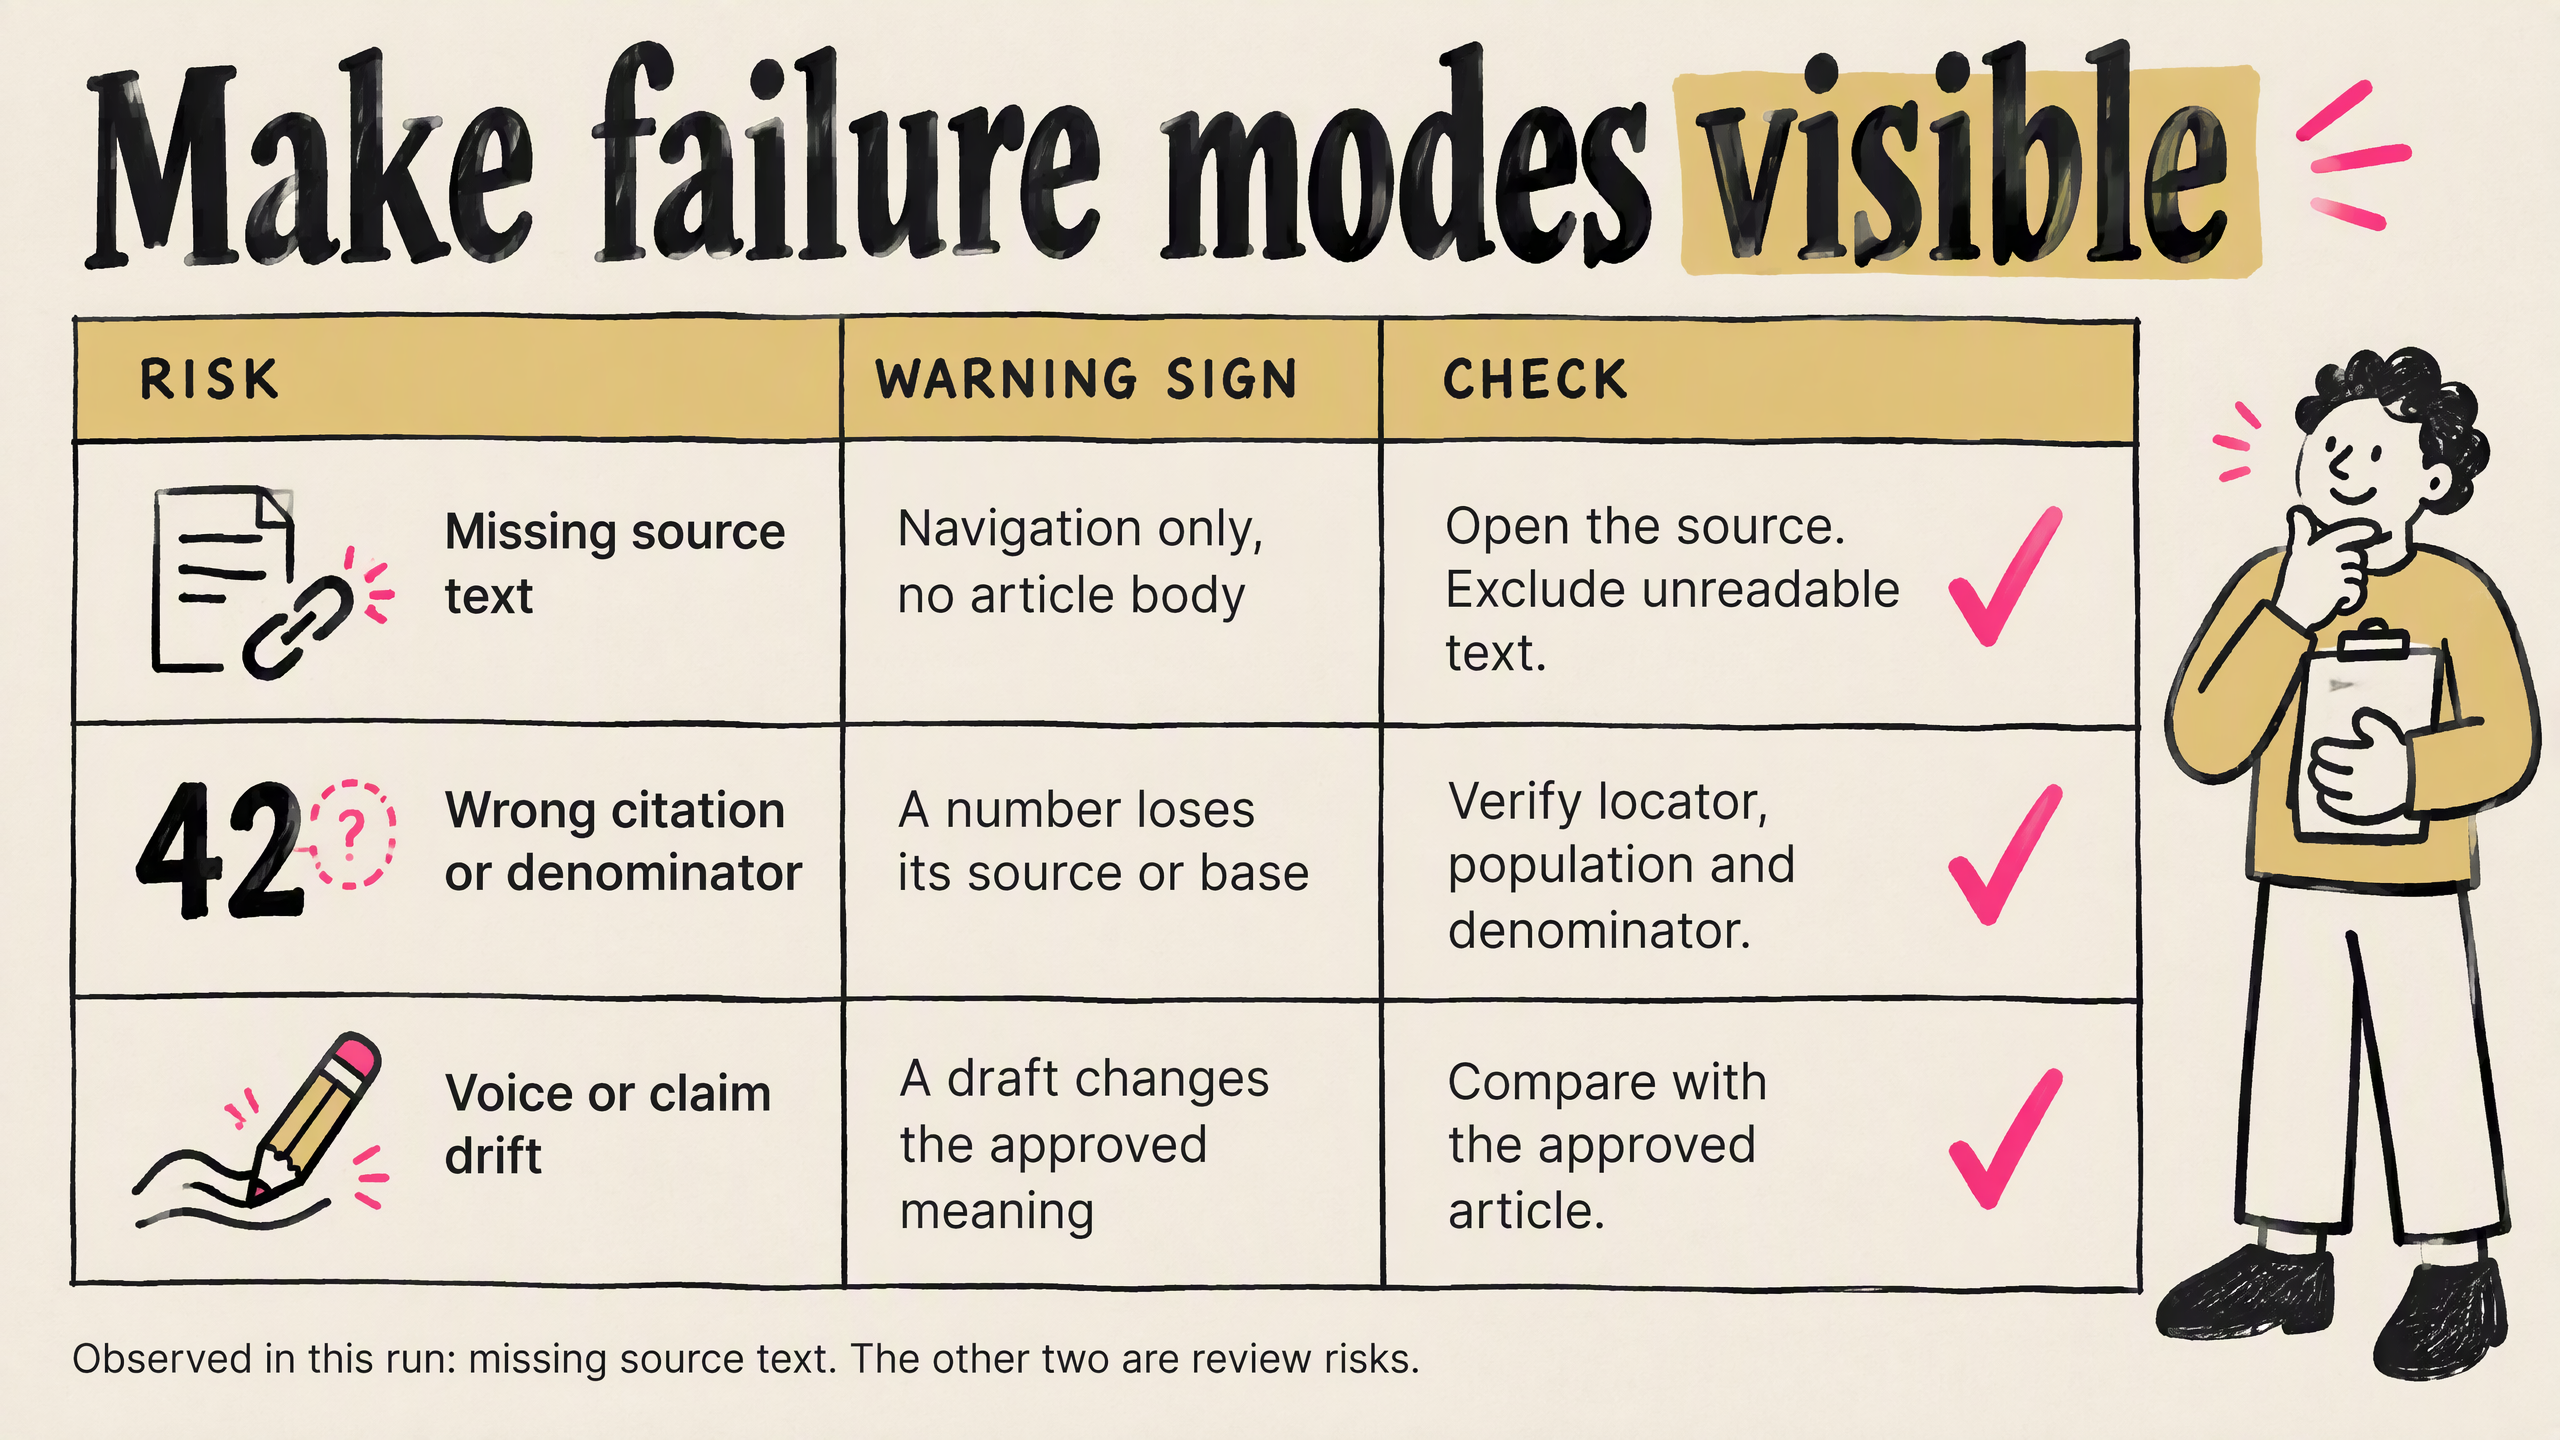
- Sin encabezados de columna; la segunda fila repetía la misma frase en las columnas de advertencia y comprobación, borrando el significado intermedio.
- Después: encabezados Riesgo / Señal de alerta / Comprobación; tres filas distintas (falta texto fuente; cita o denominador incorrectos; desvío de voz o de afirmación) con comprobaciones prácticas.
- Ronda 3: CHECK quedaba sobre marcas decorativas en lugar de sobre la columna de acción → reconstruir sobre una cuadrícula real de tres columnas.
5. Edición interna / regenerar: no puedes “corregir una sola palabra”
- La nota al pie de la diapositiva 6 terminaba en un glifo ilegible → regenerar toda la página; bloquear la frase exacta: Week 1 establishes the manual baseline.
- Apareció una vez un prefijo inventado “SOURCE: INTERNAL RESEARCH TEAM” → eliminado (no existe tal fuente interna en este caso).
- Las cuatro métricas siguen como POR MEDIR: nada de cifras falsas.
6. Elección de estilo: mismo contenido aprobado, dos lenguajes visuales
Cuando el contenido de la Ronda 1 pasó la revisión, el borrador de papel/tinta resultaba demasiado plano: argumento sólido, maquetación débil. Así que:
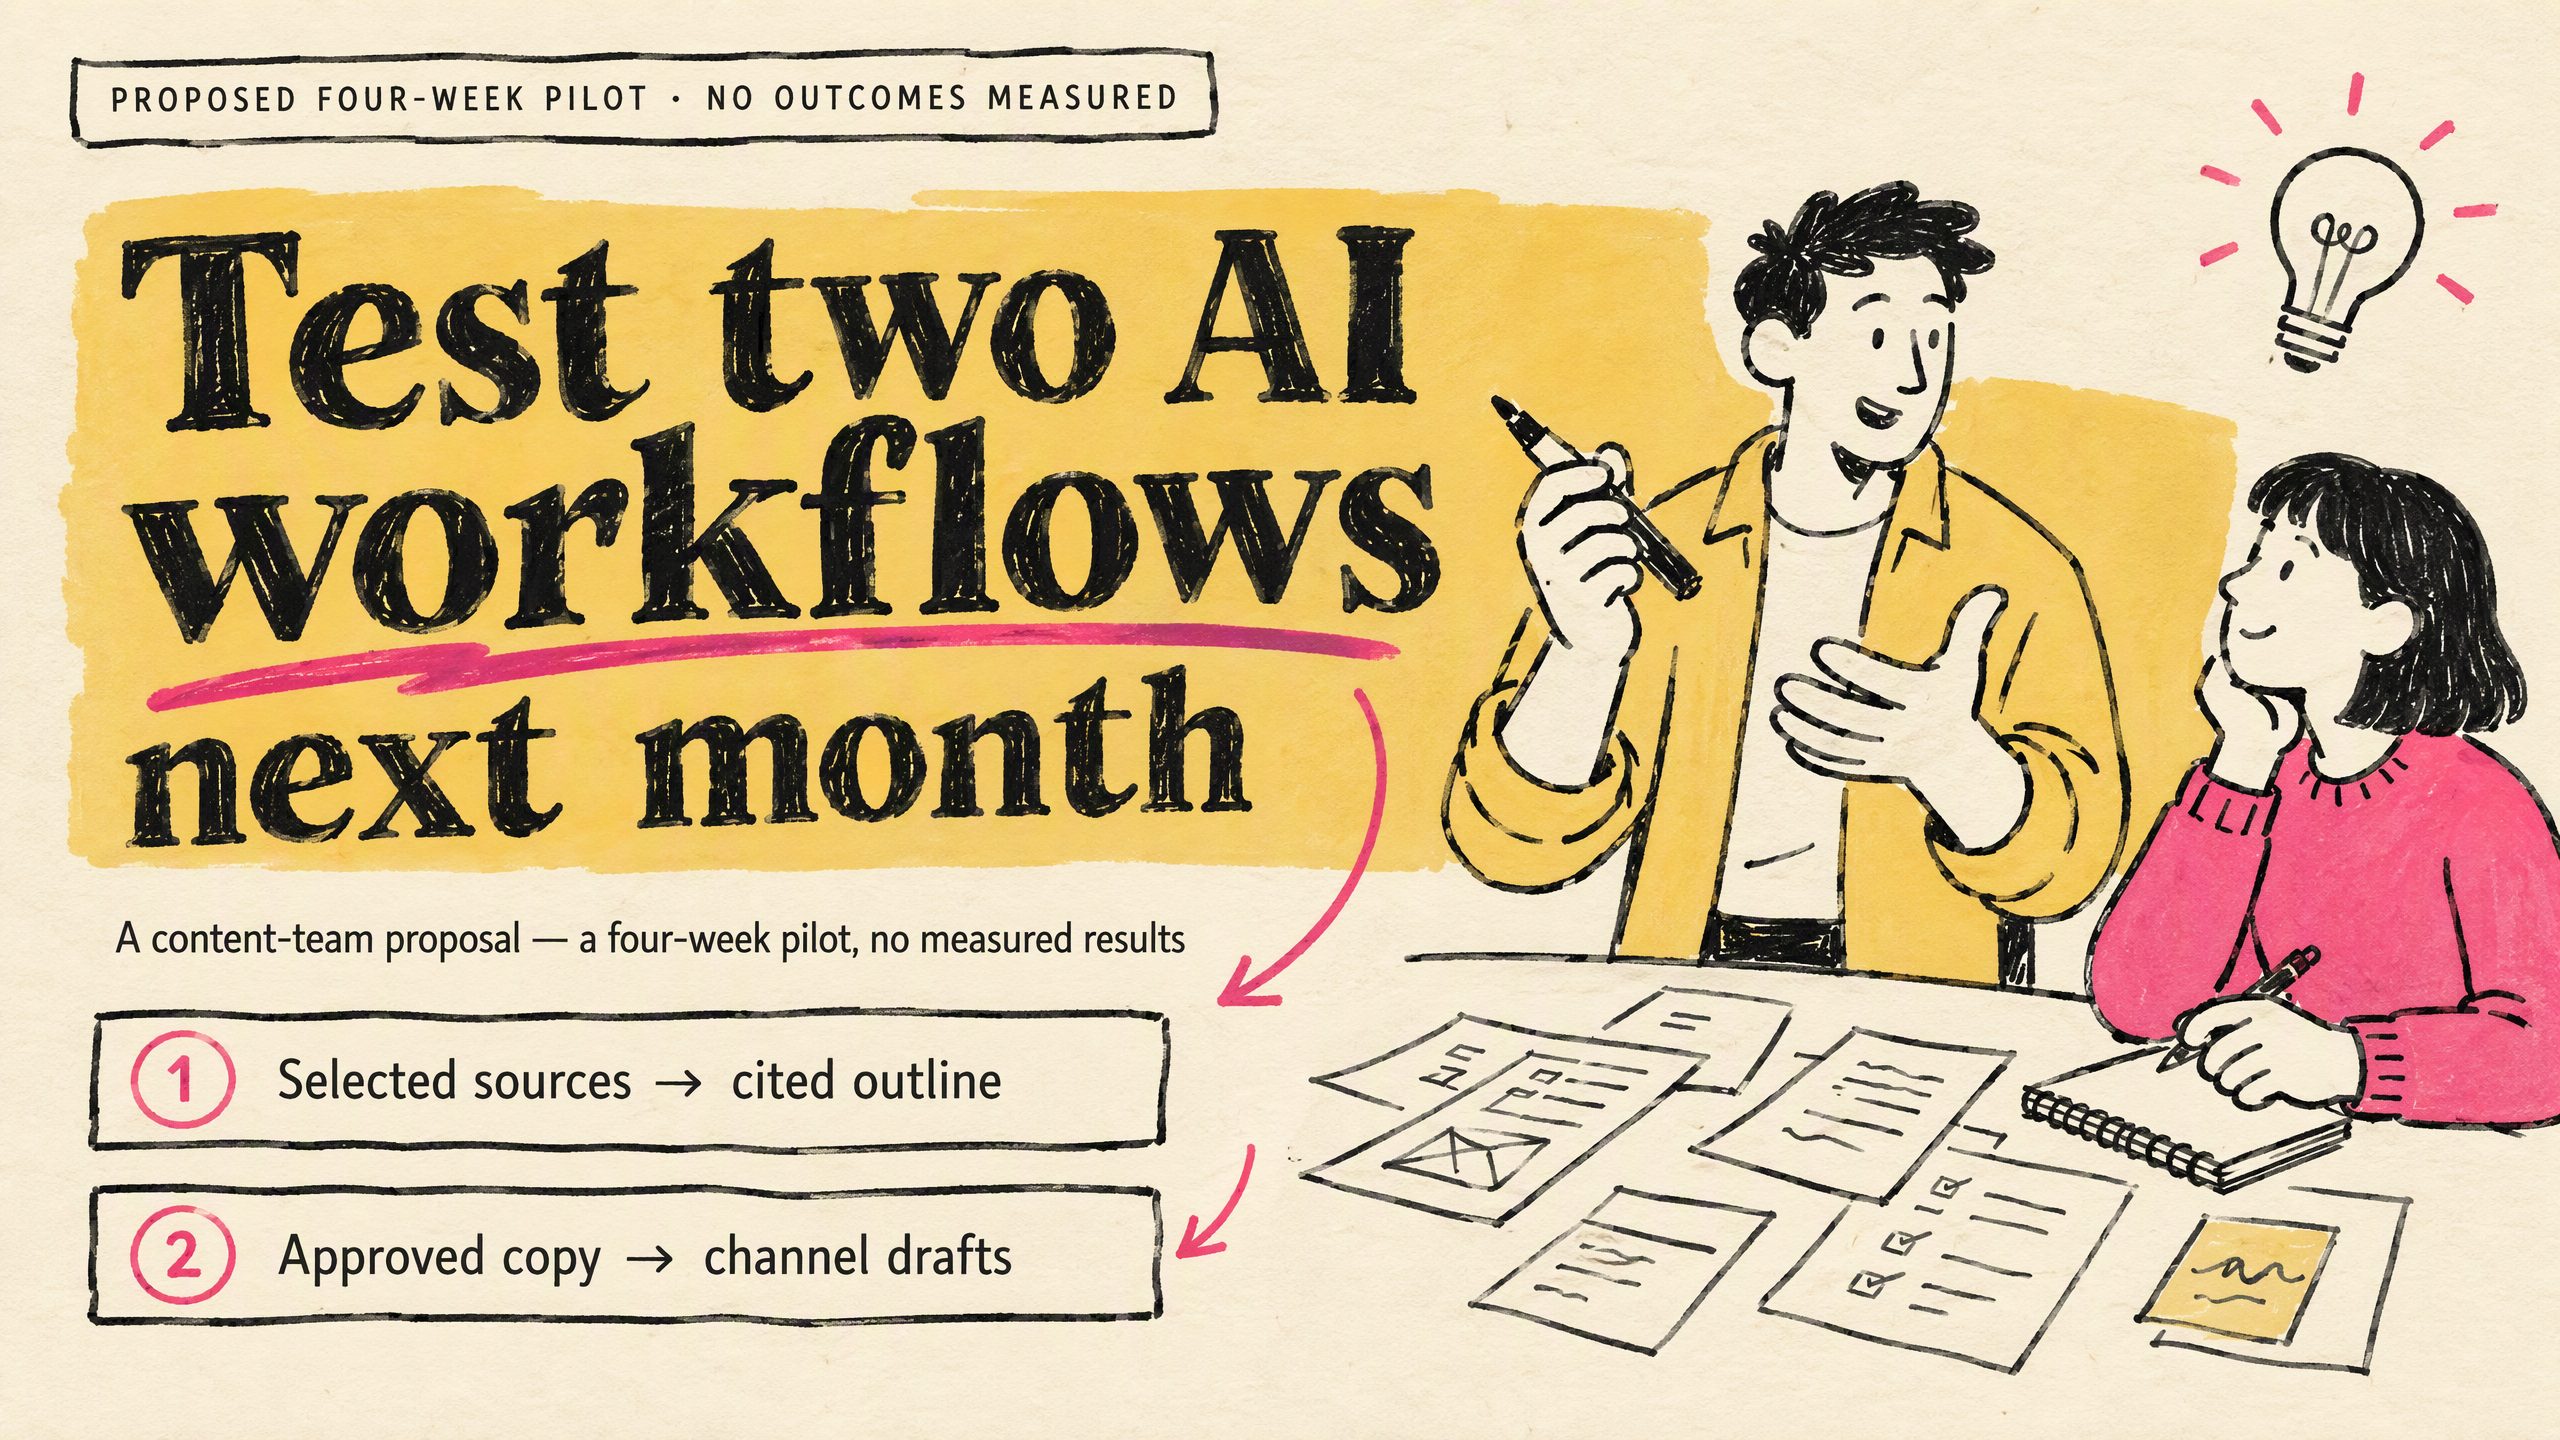
- Ronda 2a: Vibrant handdrawn for young professional (v1) → seleccionada como Presentación final (contornos dibujados a mano, bloques de color intensos, tipos de página deliberadamente distintos).
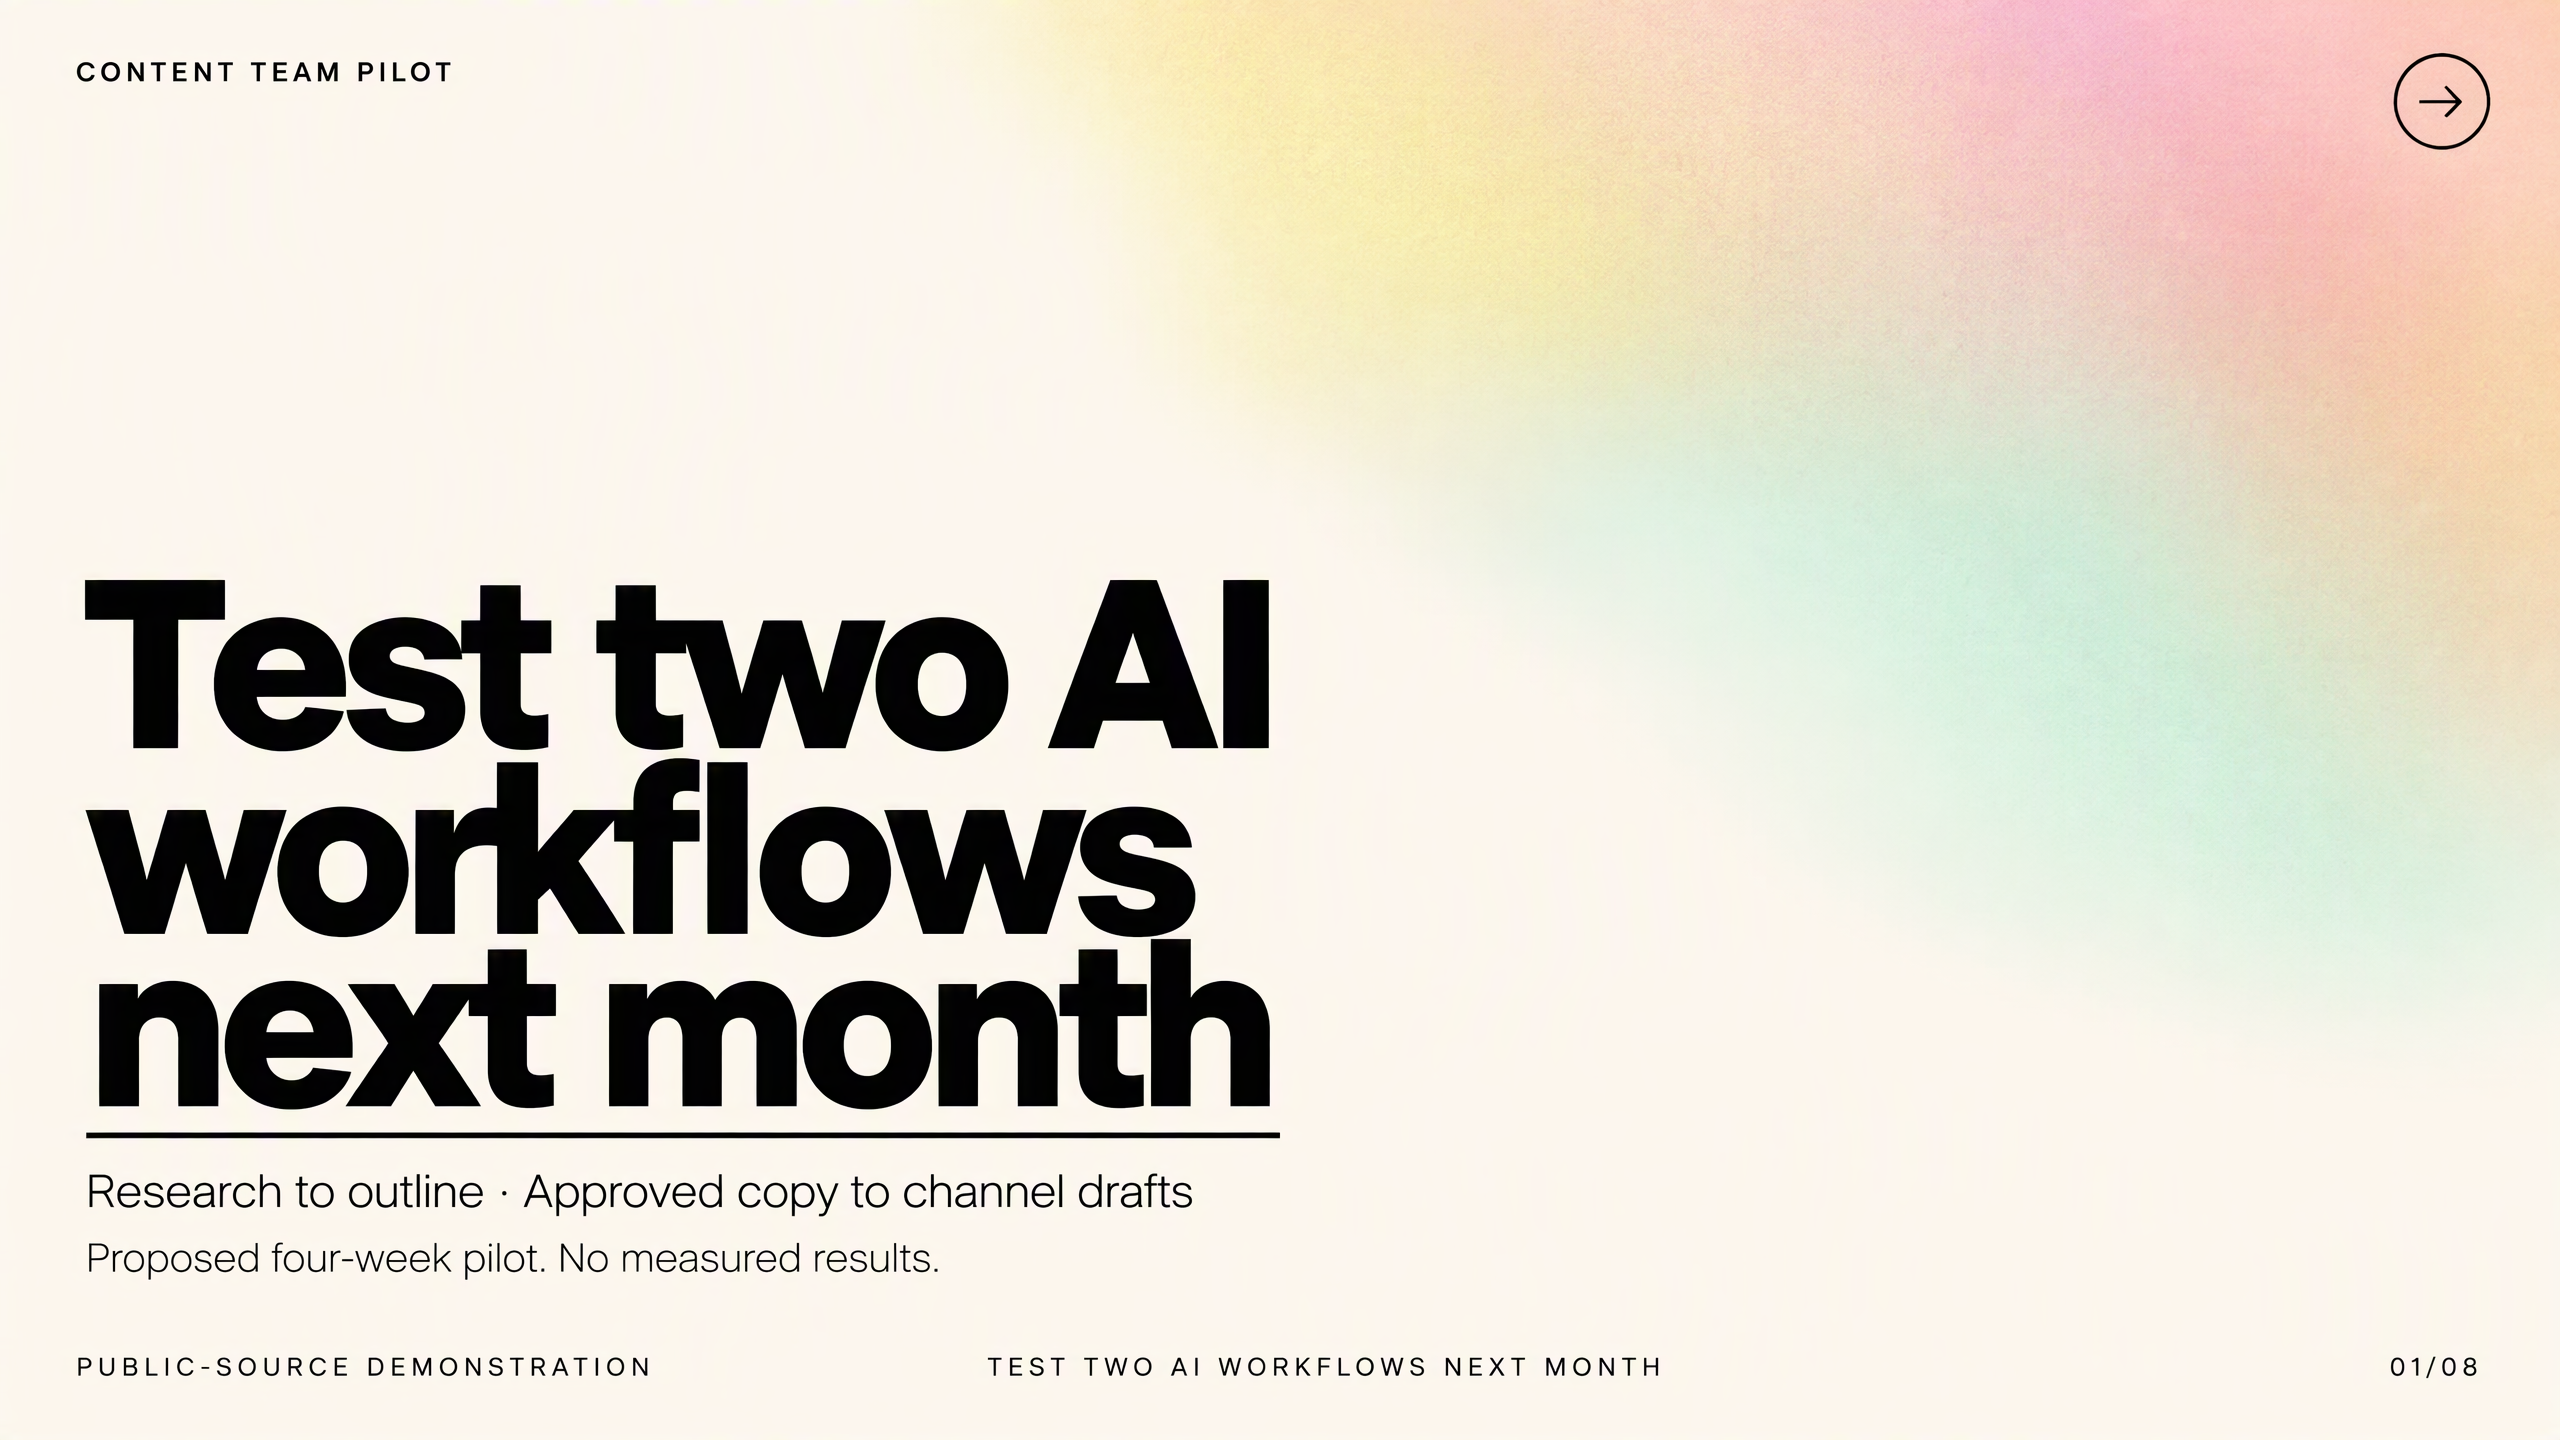
- Ronda 2b: Modern Light Soft-glow (v9) → no seleccionada, archivada.
El contenido se mantuvo constante durante el restyling: redacción del denominador del 49 %, dos paneles de datos separados, Stanford excluido, resultados propuestos vacíos en el Piloto 2, métricas no medidas, responsable por definir, regla de parada etiquetada como propuesta.
7. Tras la exportación: límites que cambian la promesa
El PPTX de esta presentación es una imagen ráster por diapositiva (por ejemplo, 2560×1440): sin objetos de texto editables, sin pista de notas del orador. Cambiar una palabra implica regenerar esa imagen de página y sustituir el segmento. La narración vive en las Research Notes; presenta desde ahí. Las notas al pie legibles en un portátil pueden fallar desde el fondo de la sala.
Para ver dónde están los botones y los formatos de exportación, usa la página del producto: nano-banana-pro-slide. No describas este archivo como un PowerPoint normal con texto editable.
La presentación final de un vistazo
- Nº: 1 · Título final: Probar dos flujos de trabajo con IA el próximo mes · Criterio que protege la página: Es un plan, no resultados; los efectos sin etiqueta se medirán
- Nº: 2 · Título final: Las señales de uso sugieren qué probar · Criterio que protege la página: Dos datos, dos denominadores; motivo para probar ≠ previsión de ahorro
- Nº: 3 · Título final: Piloto 1: fuentes seleccionadas → esquema citado · Criterio que protege la página: Tabla real de verificación de fuentes; ilegible → excluir
- Nº: 4 · Título final: Piloto 2: texto aprobado → borradores por canal · Criterio que protege la página: Límite del texto aprobado; resultados solo “propuestos”
- Nº: 5 · Título final: Definir reglas de revisión antes de la primera ejecución · Criterio que protege la página: La gobernanza es nuestra recomendación, no un hallazgo de investigación
- Nº: 6 · Título final: Medir esfuerzo y calidad juntos · Criterio que protege la página: Incluir el tiempo de revisión; la Semana 1 establece la línea base
- Nº: 7 · Título final: Hacer visibles los modos de fallo · Criterio que protege la página: Tres riesgos + comprobaciones baratas; aquí solo se observó “falta texto fuente”
- Nº: 8 · Título final: Acordar alcance, responsables y reglas de parada · Criterio que protege la página: Diapositiva de decisión; reglas de parada antes de empezar el trabajo
Lista de comprobación que puedes copiar
- Tres preguntas iniciales escritas (decisión / afirmación / prohibiciones)
- Fuentes no utilizadas registradas (incluidas capturas web vacías)
- Una afirmación por diapositiva; las cifras clave remiten al PDF/página + denominador
- Marcadores, textos de instrucción filtrados y diagramas mal etiquetados eliminados
- Si se generaron dos estilos, motivos de selección y rechazo registrados (incluidas cancelaciones fallidas)
- Revisión de contenido antes de exportar + comprobación tras exportar: si es editable o no, dónde están las notas
- Nada de clientes falsos, ahorros falsos ni tratar frases de búsqueda no probadas como tráfico verificado
Preguntas frecuentes
¿Cómo conviertes un PDF, páginas web y notas en un PPT de informe con IA?
Reúne las fuentes y una audiencia/afirmación clara en un mismo espacio de trabajo → produce un esquema revisable (una afirmación por diapositiva) y apruébalo → genera un primer borrador mediante conversación o una Skill → edita títulos, elimina ruido y vuelve a comprobar las cifras contra las fuentes → confirma qué te da realmente la exportación y entonces entrega. El objetivo no es la perfección en un solo intento, sino la trazabilidad, un esquema aprobado y la corrección humana tras la generación.
¿Qué sueles corregir después de que la IA genere un PPT?
Cuatro movimientos recurrentes: (1) descartar fuentes que no apoyan la afirmación o no son legibles; (2) reescribir títulos vagos como afirmaciones en forma de conclusión; (3) verificar cifras y citas en el PDF o la página original; (4) ajustarse a la forma real de exportación: si las diapositivas son imágenes ráster de página completa, asume que tendrás que regenerar una página cuando una palabra esté mal.
¿En qué se diferencia esto de subir → generar → exportar en la página de la herramienta?
La página de la herramienta muestra el camino de capacidades. Este artículo muestra decisiones y el antes/después sobre un mismo conjunto de materiales para que sepas dónde detenerte y editar. Los botones están en la página de la herramienta; la capacidad de entrega está en la lista de comprobación de edición.
¿Sigues comparando proveedores? Consulta /compare/autoppt.
Siguiente paso
Abre un Board con uno de tus propios PDF y notas. Aplica la misma lista: tres preguntas → recortes del esquema → generar → corregir al menos un título y una cifra contrastándolos con la fuente. ¿Atascado con la elección de Skill? Vuelve a la colección. ¿Necesitas la ruta del producto? Usa la página de la herramienta.
¿Tienes preguntas sobre este artículo?
Pregunta a la IA gratisArtículos relacionados
Reconocimiento instantáneo: utiliza Image-to-Prompt para crear un estilo visual de marca coherente
Toma tus últimas diez imágenes y colócalas en fila. Si parecen pertenecer a diez marcas diferentes — una minimalista y fría, otra amarilla cálida dibujada a mano, y la siguiente de repente con alta saturación — el problema no es que cada imagen individual se vea bien o mal. El problema es que cada una cuenta una historia distinta. En un feed saturado de contenido, lo que hace que la gente te recuerde no es una sola imagen impactante, sino una sensación de continuidad que les hace pensar: "Sé que eres tú incluso antes de ver el nombre de usuario". Y esa continuidad no es un talento — es un sistema. La consistencia visual suena como algo reservado para grandes marcas y diseñadores profesionales, pero en esencia es bastante simple: la misma iluminación, la misma paleta de colores, la misma textura de medio, la misma composición, repetidas hasta que se convierten en tu identidad. La parte difícil nunca es "hacer una imagen que se vea bien" — es "hacer que la imagen número cien todavía parezca parte de la misma familia que la primera". E irónicamente, las herramientas de generación de imágenes por IA han hecho esto más difícil. Justamente lo que hace que el texto a imagen sea tan atractivo es precisamente lo que lo hace peligroso para la identidad de marca: cada generación es un poco diferente. El mismo prompt, "estilo de ilustración cálida y acogedora", podría darte hoy una luz suave y cremosa, y mañana una intensidad naranja rojiza intensa. El mismo "foto de producto minimalista" podría salir con un fondo blanco puro esta vez, y agregar inexplicablemente una sombra la siguiente. El modelo reinterpreta tu descripción vaga desde cero cada vez, y nunca internaliza realmente cómo debería verse "tu marca" en tu mente. Entonces caes en un ciclo familiar: describes cada imagen desde cero, siempre sale un poco diferente, te conformas y la publicas, y meses después miras hacia atrás y tu cuenta parece haber sido manejada por tres o cuatro personas con estéticas completamente diferentes. se usa a menudo como una herramienta simple para "descubrir cómo se hizo una imagen". Pero en el contexto de la identidad de marca, hace algo mucho más importante: toma un estilo visual que reconoces al instante pero que te cuesta describir, y lo fija en un bloque de texto que puedes copiar y reutilizar. El enfoque es simple. Primero, elige una imagen "ancla de estilo" que represente la vibra de tu marca — podría ser tu publicación con mejor rendimiento, una imagen de referencia a la que siempre vuelves, o una imagen base que creaste específicamente para esta marca. Pásala por la herramienta, y ella "leerá" esa imagen y la convertirá en una descripción estructurada: cuál es el sujeto, de dónde viene la luz, si la paleta de colores es fría o cálida, si es fotografía o ilustración, la profundidad de campo y textura, y el estado de ánimo general. Esta descripción es la versión textual del ADN visual de tu marca. Desde ahora, no tienes que escribir desde cero sintiéndolo cada vez. Tienes una plantilla que puedes reutilizar tal cual. En un prompt extraído, algunos elementos son las constantes de tu marca, y otros son solo el contenido de esa imagen en particular. Separarlos es la clave de todo el método. Lo que deberías fijar generalmente incluye esto: la paleta de colores — el conjunto de tonos que hace que la gente te reconozca de un vistazo; la iluminación — luz suave de mañana o luz lateral dura; la textura del medio — fotografía realista, ilustración semirrealista o renderizado 3D; el hábito de composición — mucho espacio negativo, sujeto centrado o descentrado; y el estado de ánimo general — tranquilo, nítido o vibrante. Juntos, son la parte que hace que la gente diga: "Te reconozco incluso antes de verte claramente". Lo que deberías cambiar cada vez es solo el contenido en sí: esta vez el sujeto es el Producto A, la próxima vez el Producto B; esta imagen es sobre una escena de desayuno, esa otra sobre un escritorio. Preservas los "genes" de tu estilo, reemplazas solo esa variable, y regeneras — la iluminación y la paleta de colores se mantienen, y solo cambia lo que modificaste. Esa es la verdadera línea divisoria entre "producir un conjunto completo de imágenes que pertenecen a la misma marca" y "apostar a la suerte desde cero cada vez". La verdadera prueba de la consistencia visual de una marca no es una sola imagen — es a través de contextos. La portada de una entrada de blog, un conjunto de imágenes para redes sociales, una presentación externa — si todas tienen estilos diferentes, incluso el gran contenido se siente fragmentado. Con ese prompt fijo, puedes difundir el mismo lenguaje visual en cada punto de contacto: úsalo para generar una portada de blog que transmita el tono de tu marca, crea un conjunto de imágenes para publicaciones en redes sociales que parezcan hechas para estar juntas, e incluso establece una apariencia unificada para las ilustraciones en tus presentaciones. En YouMind, partiendo de este prompt, puedes fluir sin problemas a través de todas estas tareas — portadas, imágenes de apoyo y Slides comparten la misma luz y paleta de colores, en lugar de que cada una vaya por su lado. Como un prompt es texto plano, funciona en diferentes herramientas: Nano Banana Pro, GPT Image 2, Midjourney y Stable Diffusion pueden leer la misma descripción. El estilo de tu marca no queda encerrado en un solo modelo. Hay una línea que vale la pena trazar claramente. Inspirarse en la iluminación, composición y atmósfera de una imagen es saludable. Pero si tu "ancla de estilo" proviene directamente de un visual distintivo de un competidor, un personaje famoso con derechos de autor, o el logotipo de otra marca, y lo usas como tu propia cara — eso pasa de "construir un estilo" a "suplantar una identidad". El "estilo" genérico no es propiedad de nadie, pero la expresión específica y reconocible de una marca es un activo propio. Así que el enfoque más seguro es anclar en tu propio material — tus productos, tus escenas, tu línea base — y luego usar el prompt extraído para sistematizarlo y escalarlo. Cada imagen que produzcas será entonces tanto consistente como genuinamente tuya. Antes, la consistencia visual de una marca dependía de un diseñador que recordara cada detalle, o de una guía de estilo que nadie quería leer. Ahora, puedes comprimirla en un bloque de texto: extrae una vez, reutiliza repetidamente, cambia solo lo que necesita cambiar. La próxima vez que necesites una imagen para contenido nuevo, no tendrás que apostarle a la suerte mirando un cuadro de prompt vacío. Ya sabes cómo se ve tu marca, y puedes hacer que se vea así cada vez. ¿Cómo ayuda Image to Prompt con la consistencia visual de una marca? Traduce una imagen que representa la vibra de tu marca en un prompt estructurado. Fijas la paleta de colores, la iluminación, el medio y la composición, y cada vez solo reemplazas el sujeto o la escena. Las imágenes de salida mantendrán siempre el mismo estilo. ¿Qué imagen debería usar como "ancla de estilo"? Tu propio material es lo más seguro: tu publicación con mejor rendimiento, una imagen base que hayas creado específicamente, o una imagen terminada que mejor represente la vibra de tu marca. Trata de evitar usar competidores o personajes con derechos de autor como anclas. ¿Puedo usar este prompt en diferentes herramientas de IA? Sí. El resultado es texto plano, y herramientas principales de texto a imagen como Nano Banana Pro, GPT Image 2, Midjourney y Stable Diffusion pueden usarlo directamente. El estilo de tu marca no quedará encerrado en un solo modelo. ¿Hará que todas las imágenes se vean exactamente iguales? No. Fija las constantes de estilo, pero el contenido sigue siendo diferente cada vez. El objetivo es que parezcan "una misma familia", no copiar y pegar la misma imagen. ¿Necesito experiencia en diseño o redacción de prompts? No. El paso de extracción traduce lo visual a texto por ti. Solo necesitas decidir qué elementos son las constantes de tu marca y cuáles intercambiar, y puedes empezar a reutilizar.
Convierte una imagen en prompts reutilizables para generación de imágenes por IA
Seguro que te ha pasado alguna vez: estás haciendo scroll, ves una imagen y no puedes dejar de mirarla. La iluminación, la paleta de colores, la atmósfera que llevas semanas buscando, todo capturado en una sola imagen. Quieres crear algo parecido, así que abres tu generador de imágenes con IA, te quedas mirando el campo de prompt vacío y escribes algo vago como «foto cinematográfica, buena iluminación, mucha atmósfera». ¿El resultado? Algo que no tiene nada que ver con la imagen que tenías en mente. El problema no suele ser tu gusto, sino la traducción. Volver de una imagen terminada al texto que podría recrearla es realmente difícil. Requiere un vocabulario especializado en composición, ángulos de cámara, iluminación, esquemas de color y estilo: un vocabulario que la mayoría de la gente nunca tiene la oportunidad de desarrollar. Eso es exactamente lo que hace la : le das una imagen y te devuelve el texto. Este artículo explica qué es, cuándo funciona bien, dónde se queda corta y cómo obtener tu primer prompt en segundos. Image to Prompt es lo contrario de texto a imagen. Normalmente, escribes una descripción y el modelo genera una imagen. Aquí, le das al modelo una imagen terminada y él escribe la descripción: el prompt que habrías necesitado introducir para obtener esa imagen. Puede que lo hayas oído llamar de varias formas: reverse prompting, extracción de prompts, image-to-prompt o, simplemente, «ingeniería inversa de prompts a partir de imágenes». Los nombres varían, pero la tarea es la misma: convertir la información visual en una descripción de texto estructurada y reutilizable que cualquier herramienta de texto a imagen pueda entender. Una extracción útil va mucho más allá de algo tan vago como «un gato». Captura los elementos que realmente definen una imagen: Subes una imagen y la herramienta la «lee» como un ojo entrenado, identificando los elementos que realmente determinan el impacto visual: sujeto y composición, dirección y calidad de la luz, paleta de colores general, estilo y medio, y detalles técnicos como la profundidad de campo y la textura. Después, traduce lo que ve a un lenguaje preciso y compone un prompt coherente y listo para usar. Una luz concreta se convierte en «luz suave del sol de la mañana»; un tono concreto, en «estilo cálido y semirrealista». En segundos, tienes un prompt que puedes usar de inmediato. En YouMind, puedes usarlo como punto de partida para crear la portada de un artículo o incluso para generar ilustraciones de una presentación. Pero recuerda: el resultado es un primer borrador sólido, no una verdad absoluta. Es el mejor intento de la herramienta por interpretar la imagen, y eso es justo lo que veremos en la siguiente sección. Aquí tienes el proceso completo con un caso real. Primero, subes una imagen de referencia (en este caso, una ilustración con luz suave de una persona sosteniendo un gato blanco). La tarjeta de subida mostrará: archivo listo, listo para procesar. Haz clic en Generar prompt y este es el resultado real: ¿Ves? Va mucho más allá de «una persona sosteniendo un gato». Especifica la dirección de la luz, la paleta de colores, la profundidad de campo, la composición y el ambiente: exactamente los factores que determinan si tu próxima imagen se parecerá a la referencia. Además del prompt, la herramienta te indica claramente los siguientes pasos: generar la imagen tal cual, sustituir un elemento manteniendo la composición original o reutilizar el estilo para portadas o gráficos de redes sociales. A partir de aquí, no tienes que empezar de cero: solo cambia una variable. Sustituye el gato blanco por un perro, cambia el color del jersey o traslada la escena a un rincón de lectura y vuelve a generar. La composición y la iluminación se mantendrán; solo cambiará el elemento que hayas modificado. Conservas el «ADN» de la imagen de referencia (su iluminación, encuadre y atmósfera), mientras el resultado final es inconfundiblemente tuyo. La mayoría de las herramientas de image-to-prompt se quedan en «aquí tienes una descripción», y ese paso ya es prácticamente estándar. Donde el de YouMind brilla de verdad es en lo que ocurre después de obtener la descripción: Es excelente con sujetos únicos y claros: retratos, fotos de producto, paisajes e imágenes con un estilo consistente y reconocible. Las imágenes de referencia limpias y bien iluminadas tienden a dar prompts igualmente limpios. Hay algunas áreas predecibles en las que se vuelve poco fiable. Las composiciones recargadas con varios sujetos pueden confundirla sobre qué elemento debe enfatizar el prompt. El arte abstracto es difícil de reducir a texto y siempre pierde parte de su esencia. Las imágenes con mucho texto (carteles, infografías, memes) suelen devolver texto distorsionado o alucinado, porque los modelos de visión no son muy buenos transcribiendo texto. Y, como cualquier modelo de IA, la herramienta de extracción puede alucinar: puede describir con total seguridad un material, una marca o un detalle que en realidad no está en la imagen. Así que trata el resultado como un borrador que debes contrastar con la imagen original, no como un registro literal: léelo, elimina lo que esté mal y quédate con lo que sea útil. En unos diez segundos puedes extraer un prompt. Extraer un prompt describe un estilo; no transfiere la propiedad. Bien utilizada, es una herramienta de aprendizaje e ideación: una forma de entender por qué una imagen funciona y de crear algo nuevo en la línea que admiras. Utilizada sin cuidado, roza el plagio. Una línea razonable es: inspírate en la iluminación, la composición y la atmósfera, pero no repliques la obra característica de un artista vivo, un personaje protegido por derechos de autor o un logotipo de marca y lo hagas pasar por tuyo, especialmente para uso comercial. Un «estilo» general no pertenece a nadie, pero una expresión específica y reconocible puede tener dueño. Para eso sirve exactamente el flujo de «reemplazo»: cambia el sujeto, la escena o el ángulo y haz que el resultado sea realmente tuyo. ¿La herramienta Image to Prompt es gratuita? Sí. Puedes subir una imagen y generar un prompt en YouMind sin pagar. ¿Qué formatos de imagen son compatibles? JPG y PNG, entre otros, que cubren la mayoría de fotos, capturas de pantalla e imágenes exportadas. ¿Con qué herramientas de IA se pueden usar los prompts generados? Con cualquier modelo de texto a imagen. El resultado es texto plano, así que funciona con Nano Banana Pro, GPT Image 2, Midjourney, Stable Diffusion, DALL·E y más. ¿Recreará exactamente la misma imagen? No, y es a propósito. Te da el prompt detrás del estilo para que generes tu propia versión, no una copia píxel a píxel. ¿Necesito experiencia escribiendo prompts? No. Precisamente la gracia de image-to-prompt es ahorrarte el paso de escribir manualmente. Puedes refinar el resultado, pero no tienes que empezar de cero. La próxima vez que una imagen te detenga el scroll, no tienes por qué adivinar el texto que hay detrás ni limitarte a copiarla. , dale la forma que quieras y crea algo verdaderamente tuyo.
La IA está rompiendo los viejos contenedores del pensamiento humano
La primera vez que sucedió, toda la oficina se quedó paralizada. Entonces alguien susurró: "¡Mierda!". Le siguió un coro de voces. El texto estático en una pantalla acababa de transformarse —justo delante de nosotros— en algo responsivo, fluido, casi vivo. Fue la primera ejecución exitosa de Dynamic View de Gemini 3 dentro de YouMind, junto con Nano Banana Pro y su motor de generación de imágenes. Y, por supuesto, tuve que probarlo yo mismo. El problema era... que en ese momento no tenía imaginación alguna. Así que elegí la primera idea que se me ocurrió: ¿Y si convirtiera mi tedioso boletín de IA en El Profeta —el periódico de retratos en movimiento de Harry Potter? Lo construí. Funcionó. El Profeta interactivo, Edición Boletín de IA. Consigue el mismo efecto [aquí](https://youmind.club/use-cases/turn-plain-text-to-interactive-webpage-instantly). Y por un momento, sinceramente pensé que podría llorar. El contenido no era nada especial, solo las actualizaciones habituales de IA que publico cada semana. Pero ahora esas mismas palabras bailaban en un periódico encantado y vivo que se ondulaba con movimiento y emoción. No podía apartar la vista. Y fue entonces cuando me asaltó la verdadera pregunta: Si esta cosa puede hacer que un contenido mediocre resulte tan convincente, ¿qué podría hacer con algo verdaderamente grandioso? A primera vista, esto parece un truco visual genial. Una animación elegante. Un periódico mágico. Pero esa es la historia pequeña. La gran historia es que rompe un hechizo bajo el que hemos estado durante miles de años, un hechizo que se parece sospechosamente a una versión más suave de la Neolengua de Orwell. En 1984, el régimen crea la Neolengua, un lenguaje que reduce el alcance del pensamiento humano. Quita la palabra libertad, y la gente eventualmente pierde el concepto de libertad. Comprime el lenguaje, comprime el pensamiento. Pero aquí está la incómoda verdad: tú y yo también hemos estado viviendo bajo nuestra propia forma de Neolengua. No impuesta por un régimen, sino por algo más sutil: La técnica. Dentro de tu mente, las ideas no son lineales. Son tridimensionales, estratificadas, espaciales, como un palacio con habitaciones, escaleras y puertas ocultas. Pero a menos que seas pintor, arquitecto o músico, no puedes expresarlo de la manera más vívida. Te ves obligado a aplanar todo en la estrecha franja de texto lineal. Una frase tras otra. Una idea apretada detrás de la siguiente. En el momento en que el pensamiento abandona tu mente, pierde su profundidad. Incluso en la era de internet, este problema no ha desaparecido. Sabes que una página web podría ser espacial, interactiva, dinámica, pero no sabes cómo codificar, diseñar u orquestar un diseño. Así que te retiras a los documentos estáticos, la zona segura donde la complejidad debe reducirse para encajar. La técnica comprime la expresión. Y al comprimir la expresión, comprime el pensamiento mismo. Por eso tu idea parece brillante en tu cabeza, pero decepcionante en la página. El contenedor mata la energía mucho antes de que el mundo tenga la oportunidad de verla. Pero cuando Gemini 3 se fusiona con Nano Banana Pro dentro de YouMind, ese techo finalmente se rompe. Por primera vez, texto, imágenes, movimiento e interacción fluyen juntos en un único medio que cualquiera puede controlar. Por primera vez, puedes expresar un pensamiento espacial como un pensamiento espacial. No porque conozcas el diseño, sino porque la IA hace que el diseño sea permeable. Este es el encanto anti-Neolengua: la IA devuelve el derecho a pensar —previamente robado por la técnica— a los creadores. Cuando el contenedor se expande, la mente se expande con él. Hay otra barrera que la IA disuelve silenciosamente: la estética. Antiguamente, la belleza era un privilegio. En la École des Beaux-Arts de París, los profesores recorrían los estudios de examen y clasificaban silenciosamente los dibujos de los estudiantes en dos montones: continuar y abandonar. Sin criterios. Sin explicaciones. La estética era un lenguaje privado, accesible solo para aquellos con tiempo, riqueza y formación. YouMind ahora puede generar interfaces con ritmo natural, jerarquía y armonía. No necesitas "saber de diseño" para expresar algo que parezca diseñado. La belleza se convierte en infraestructura pública. Y una vez que el miedo a "hacerlo bonito" desaparece, los creadores pueden finalmente volver a la verdadera pregunta: ¿Qué tipo de mundo espiritual quiero construir? Si la estética es la cara, la entrega de valor es el alma. En la década de 1990, McKinsey redefinió la consultoría al pasar de los densos "Libros Azules" a presentaciones de PowerPoint limpias y visuales. Esto cambió no solo cómo se presentaba el conocimiento, sino cómo se valoraba. Hoy, YouMind se encuentra en el Momento McKinsey, pero multiplicado. Para consultores, educadores, investigadores —cualquiera cuyo trabajo sea el conocimiento— los documentos ya no son el resultado final. Son ingredientes crudos. El resultado real es la interfaz: una expresión viva e interactiva de tus ideas. Ya no estás vendiendo información. Estás vendiendo una experiencia de comprensión. Hace un siglo, el Nuevo Movimiento Cultural en China luchó por el derecho a escribir en el lenguaje cotidiano —el vernáculo en lugar del clásico. El argumento era simple: la expresión es un derecho. No un privilegio. Hoy, estamos en un nuevo tipo de movimiento cultural: el derecho a usar el espacio, el movimiento y la interacción para construir los mundos que imaginamos. Por primera vez en la historia: Un escritor puede pensar como un arquitecto. Un estudiante puede componer ideas como un director. Un investigador puede presentar información como un diseñador de infografías. Tus creaciones no solo se quedan en una página. Se mantienen erguidas. Respiran. Conversan. Aquí hay una sutil ironía. Estás leyendo esto en un documento de texto, mientras yo explico por qué el texto ya no es suficiente. El texto sigue siendo la forma más rápida de capturar una chispa. Pero ya no es el límite de lo que esa chispa puede llegar a ser. Al igual que la filosofía en el corazón de YouMind: "Todo comienza como un borrador. Y un borrador se convierte en todo." El texto es la semilla. No la dejes atrapada en el frasco. Este borrador y los elementos visuales que lo acompañan fueron cocreados con YouMind.