SEO+GEO-Sichtbarkeits-Engine
Schwachstellen für Suche & KI-Zitate finden
SEO+GEO-Sichtbarkeits-Engine
Schwachstellen für Suche & KI-Zitate finden
Einblicke
Beschreibung
Optimiere die Sichtbarkeit von Artikeln, Produktseiten und Landingpages in der Suche und verbessere ihre Vorbereitung auf KI-Zitate. Ermittle schnell die wichtigsten Verbesserungsmöglichkeiten oder erhalte direkt nutzbare Titel, überarbeitete Texte, Content-Briefs, technische Maßnahmenlisten oder Pläne zur Wirkungsmessung. Vier Modi richten sich nach der jeweiligen Aufgabe: Sende nur einen Link oder Text, erhältst du standardmäßig eine schnelle Diagnose. Wenn du Schreibunterstützung anforderst, bekommst du zuerst verwendbare Texte. Ein vollständiges Audit wird nach Ziel-Engine und Seite aufgeschlüsselt. Bei einer Wirkungsmessung werden Datenquelle, Zähler, Nenner und Vergleichsbedingungen klar angegeben. Für einfache Aufgaben ist kein langer Komplettbericht nötig. Unterstützt werden plattformspezifische Prüfungen für Google AI Overviews / AI Mode, Bing / Copilot, ChatGPT Search, Perplexity und Claude. Zugriffe durch Suche, Training und Nutzer werden getrennt bewertet. Chinesische Plattformen werden anhand tatsächlich verfügbarer Informationen und direkter Beobachtung angepasst, ohne Regeln anderer Engines zu übertragen. v8 vereinheitlicht Bewertungs- und Evidenzmaßstäbe, begrenzt den Umfang lokaler Blockierungen, unterscheidet Antwortauslösungsrate, bedingte Zitierrate und gesamte Zitierrate und aktualisiert die Prüfung der KI-Steuerung auf Google-Website-Ebene. Du kannst eigene Websites, Artikel auf Drittplattformen und unveröffentlichte Entwürfe prüfen. Die Empfehlungen unterscheiden zwischen Inhalten, die du ändern kannst, und Punkten auf Plattformseite, die noch überprüft werden müssen. Zu jeder wichtigen Einschätzung gehören Belege oder klar benannte Einschränkungen. Bewertungen werden nur bei Bedarf ausgegeben. Es werden keine Daten, Autoren oder Zitate erfunden, und es gibt keine Garantie für Rankings, Indexierung oder KI-Zitate. Beispiel eines tatsächlichen Laufs (2026-09-07; Testmaterial, kein Geschäftsergebnis) Titelmodus: Für den Testtext „Wie schreibt man einen Team-Wochenbericht?“ wurden ausschließlich drei Titel angefordert. Tatsächlich ausgegeben wurden: 1. Wie schreibt man einen Team-Wochenbericht? Mit leerer Vorlage 2. Leitfaden zum Schreiben eines Team-Wochenberichts: Fortschritte, Probleme und Plan für die nächste Woche (mit Vorlage) 3. Vorlage für den Team-Wochenbericht: Fortschritte dieser Woche, aufgetretene Probleme, Plan für die nächste Woche Berechnungsmodus: 12 Versuche wurden simuliert, davon waren 10 erfolgreich und 2 liefen in einen Timeout. In 2 erfolgreichen Durchläufen wurde eine KI-Antwort erzeugt, in 1 davon wurde die Zielwebsite zitiert. Tatsächliche Ausgabe: Antwortauslösungsrate 2/10 = 20 %, bedingte Zitierrate 1/2 = 50 %, gesamte beobachtete Zitierrate 1/10 = 10 %. Erfolgreiche Durchläufe ohne Antwort bleiben im Gesamtnenner, Timeouts werden separat ausgewiesen. Diese Werte prüfen nur die Berechnungsmethode und stellen keine tatsächliche Zitationsleistung dar.
Ähnliche Fähigkeiten
Alle anzeigen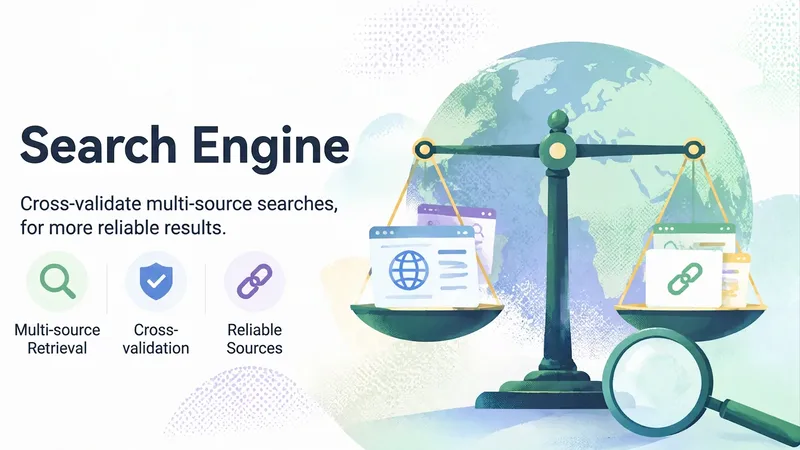
Suchmaschine
Verwandelt Fragen in nachvollziehbare Suchergebnisse aus dem öffentlichen Web – geeignet für die Recherche, das Überprüfen von Nachrichten, das Finden von Artikeln aus offiziellen WeChat-Konten, die Fehlersuche in Programmen sowie die Suche nach Fachartikeln, technischen Dokumentationen und Open-Source-Projekten. Bei Themen, die aktuelle Informationen oder Belege aus mehreren Quellen erfordern, kombiniert die Suche chinesische und internationale Ergebnisse und deckt verschiedene Arten öffentlicher Quellen ab. So lassen sich Lücken und Verzerrungen durch die Nutzung nur einer Suchmaschine verringern. Neben der Zusammenfassung relevanter Seiten werden Titel, Quellen, Links und verfügbare Veröffentlichungsdaten erfasst. Doppelte Ergebnisse werden zusammengeführt, und unabhängige Belege verschiedener Institutionen oder Websites werden voneinander unterschieden. Bei wichtigen Aussagen werden stützende und widersprechende Informationen, Abweichungen zwischen den Quellen sowie eine Einschätzung der Vertrauenswürdigkeit auf Grundlage der Anzahl und Qualität der Belege dargestellt. So ist klar erkennbar, welche Inhalte durch mehrere Quellen bestätigt werden und welche weiterhin nur auf einem einzelnen Beleg beruhen oder nicht bestätigt werden können. Du kannst direkt Suchbegriffe oder eine zu prüfende Aussage eingeben und zusätzlich ein Fachgebiet, einen Zeitraum, eine Region, Sprachpräferenzen oder bestimmte Websites angeben. Du erhältst eine strukturierte Suchzusammenfassung, eine Quellenliste, Ergebnisse des Abgleichs und offene Prüfaufgaben. Nicht zugängliche Inhalte, Anmeldeschranken oder Einschränkungen beim Abruf werden transparent gekennzeichnet; Vermutungen ersetzen niemals echte Quellen.
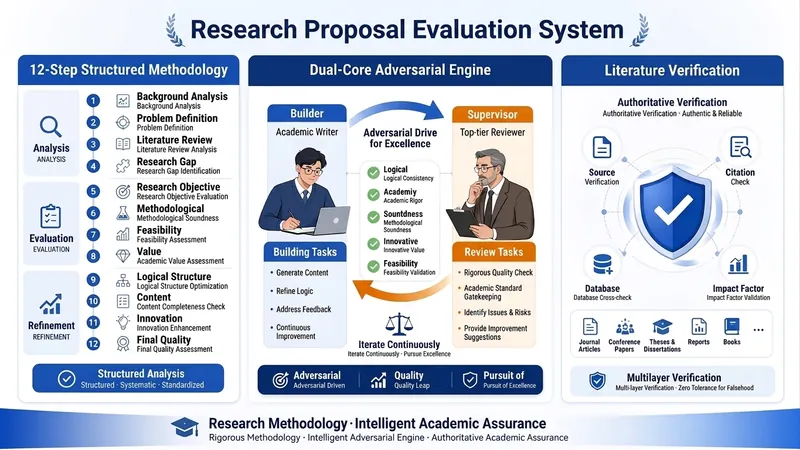
Antragsoptimierung PRO V2.0
🎯 Überblick über die Kernfunktionen Dies ist ein intelligentes Bewertungs- und Optimierungssystem, das speziell für die Beantragung von nationalen Sozialwissenschafts-, Bildungsministeriums- und Provinzprojekten entwickelt wurde. Es simuliert die Denkweise eines erfahrenen Gutachters mit 15 Jahren Erfahrung und gewährleistet durch drei Kernmechanismen die akademische Strenge und Wettbewerbsfähigkeit des Antrags. 🔧 Drei Kernmechanismen 1️⃣ 12-stufige strukturierte Methodik Die gesamte Bewertung eines Projektantrags wird in 12 Schritten abgedeckt: Phase 1-3: Basisdiagnose - Detaillierte Analyse der Ausschreibung (Förderschwerpunkte, Bewertungskriterien, Anforderungen) - Identifizierung des interdisziplinären Typs (8 Typen präzise erkennbar) - Forschungslücke in 5 Dimensionen identifizieren (Theorie/Methode/Empirie/Policy/Technik) Phase 4-7: Bewertung der Kernelemente - Analyse der Forschungsfrage nach dem TMAQ-Modell (Theorie, Methode, Ansatz, Frage) - Überprüfung der Forschungsziele nach SMART-Prinzipien - Bewertung der Vollständigkeit des Forschungskonzepts - Zuordnung des Forschungstyps (6 Typen) Phase 8-10: Tiefe Qualitätssteigerung - Präzise Identifizierung der Schwerpunkte und Herausforderungen (mit Abgrenzungskriterien und Lösungswegen) - 7-dimensionale Erkundung von Innovationspunkten - 7-dimensionale Durchführbarkeitsbegründung Phase 11-12: Gesamtoptimierung - 9-dimensionale Qualitätskontrolle (akademische Strenge, Innovation, Durchführbarkeit usw.) - Umfassende Optimierungsvorschläge und Abschlussbericht 2️⃣ Dual-Core-Konfrontationsmechanismus (Builder vs. Supervisor) Funktionsweise: - Builder (akademischer Schreiber): Generiert Optimierungsvorschläge auf Basis der Benutzermaterialien - Supervisor (Top-Journal-Gutachter): Stellt die Vorschläge des Builders mit strengsten Maßstäben in Frage - Konfrontationsiteration: Drei Runden der Konfrontation stellen sicher, dass die Vorschläge einer Prüfung standhalten Anwendungsszenarien: - Bei der Identifizierung von Innovationspunkten: Builder schlägt Innovation vor → Supervisor hinterfragt die Neuheit → iterative Optimierung - Bei der Durchführbarkeitsargumentation: Builder entwirft Plan → Supervisor hinterfragt die Durchführbarkeit → ergänzende Argumentation - Bei der Zitation von Literatur: Builder zitiert → Supervisor überprüft die Echtheit → stellt akademische Standards sicher 3️⃣ Literatur-Echtheits-Verifikationsmechanismus Zwei Arbeitsmodi: Modus A: Platzhalter-Modus (Standard) - Verwendung von [Literatur-Platzhalter-001] u.ä. anstelle konkreter Literatur - Ausgabe einer „Literaturanforderungsliste", die die Suchkriterien für jeden Platzhalter festlegt - Der Benutzer sucht selbst und fügt echte Literatur ein Modus B: Echtzeit-Verifikationsmodus - Aufruf von Google Scholar zur Echtzeit-Überprüfung der Literatur - Erstellung eines „Literaturverifikationsberichts" (Bewertung von Echtheit/Relevanz/Autorität) - Sicherstellung, dass jede Zitation nachvollziehbar ist Vermeidung von KI-Halluzinationen: - Keine erfundenen Autoren, Zeitschriften, DOIs - Alle Literatur muss verifiziert oder als Platzhalter markiert sein - Wahrung der akademischen Integrität 💡 Kernwerte und Anwendungsszenarien ✅ Gelöste Kernprobleme 1. Mangelnde akademische Strenge: KI-generierte Inhalte enthalten oft erfundene Literatur, logische Lücken 2. Unzureichende Innovation: Schwierigkeiten, echte akademische Innovationspunkte zu identifizieren 3. Schwache Durchführbarkeit: Forschungspläne entbehren systematischer Argumentation 4. Interdisziplinäre Herausforderungen: interdisziplinäre Themen sind oft „zwischen den Stühlen" 🎓 Zielgruppe - Hochschuldozenten (Sozialwissenschaften, Bildung, Geisteswissenschaften) - Wissenschaftler (Beantragung nationaler, provinzieller Projekte) - Akademische Teams (die systematisierte Bewertungsprozesse benötigen) 📋 Typischer Arbeitsablauf 1. Eingabe: Hochladen der Ausschreibung + Antragsentwurf 2. Bewertung: System führt 12-stufige strukturierte Analyse durch 3. Konfrontation: Dual-Core-Mechanismus optimiert Schlüsselbereiche iterativ 4. Verifikation: Überprüfung der Literatur auf Echtheit 5. Ausgabe: Vollständiger Bewertungsbericht + Optimierungsvorschläge + Literatursammlung 🔍 Vergleich mit herkömmlicher Begutachtung | Dimension | Herkömmliche manuelle Begutachtung | Dieses Gutachtersystem | |-----------|------------------------------------|-------------------------| | Bewertungstiefe | abhängig von persönlicher Erfahrung | 12-stufig strukturiert + 9D-Qualitätskontrolle | | Akademische Strenge | schwer umfassend zu prüfen | Literaturverifikation + Dual-Core-Konfrontation | | Innovationsidentifikation | subjektive Beurteilung | 7-dimensionale systematische Analyse | | Durchführbarkeitsargumentation | erfahrungsgetrieben | 7-dimensionale schrittweise Argumentation | | Konsistenz | variiert von Person zu Person | standardisierter Prozess | | Effizienz | Tage bis Wochen | 1-2 Stunden für erste Bewertung | Der Kernvorteil dieses Systems liegt darin, dass es das implizite Wissen eines erfahrenen Gutachters mit 15 Jahren Erfahrung explizit, strukturiert und reproduzierbar macht, sodass jeder Benutzer eine Bewertung auf Expertenniveau erhält.
Google-Content-Checker v2.0
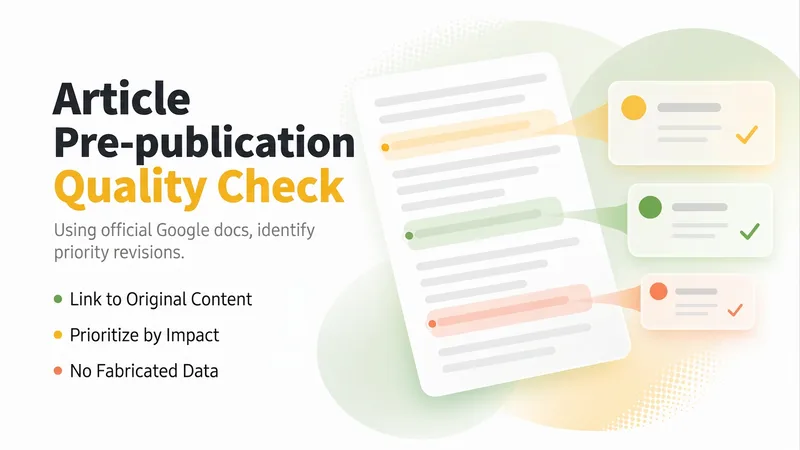
Prüft SEO-Artikel vor der Veröffentlichung: ob Leserinnen und Leser sie wirklich nutzen können, welche Aussagen nicht stichhaltig sind und was unglaubwürdig wirkt. Dazu werden die öffentlich zugänglichen Qualitätsrichtlinien von Google Search Central herangezogen. Nach Einfluss priorisiert das Skill die 3–5 wichtigsten Verbesserungen, verweist bei jeder auf die entsprechende Stelle im Original und schlägt konkrete Änderungen vor. Auf Wunsch kann es den Text auch direkt umformulieren – Erfahrungen und Daten, die nicht im Original stehen, werden jedoch nicht erfunden. Du kannst den vollständigen Text einfügen oder direkt einen Link senden. Update v2.0: Fest codierte Jahreszahlen und Namen von Algorithmus-Updates wurden entfernt. Bei konkreten Richtlinien wird die offizielle Google-Dokumentation direkt geprüft. Mechanische Regeln wie Wortzahl oder Keyword-Häufigkeit fließen nicht mehr in die Bewertung ein. Statt einer großen Tabelle mit 8 Dimensionen enthält der Bericht nun eine nach Priorität geordnete Änderungsliste. Beim Umschreiben werden keine Erfahrungen der Autorin oder des Autors, Fallbeispiele oder Daten erfunden.
Informationen
- Version
- v9
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Automatisch