Modellwahl für Code & Content
Passende Modelle wählen, Kontext bewahren
Modellwahl für Code & Content
Passende Modelle wählen, Kontext bewahren
Einblicke
Beschreibung
Je nach Aufgabenschwierigkeit, Inhaltstyp und Projektphase hilft dir dieser Skill, ein passenderes KI-Modell auszuwählen und ein Regelwerk für einen sparsameren Einsatz von Kontingent und Token anzuwenden. So erledigst du Programmier-, Kreativ-, Planungs-, Design- und Informationsanalyseaufgaben bei kontrolliertem Kontingentverbrauch. Ob Seitenkomponenten, API-Anbindungen, einfache Fehlerbehebungen oder Architekturdesign, komplexe Logik, Code-Reviews und Refactorings – du erhältst klare Modellempfehlungen und direkt die benötigten Ergebnisse. Der Skill eignet sich ebenso für alltägliche Texte, Titel und Hooks, Story-Inhalte, Markenkonzepte, Marketingpläne, PPT-Strukturen, visuelle Ideen, Markttrends, Wettbewerbsanalysen und Datenauswertungen. Einfache, umfangreiche und formatierte Aufgaben werden bevorzugt mit kontingentschonenden Methoden bearbeitet. Bei wichtigen Entscheidungen, komplexen Schlussfolgerungen oder der finalen Fassung wirst du daran erinnert, für bessere Qualität ein geeigneteres Modell einzusetzen. Bei der fortlaufenden Nutzung passt der Skill seine Empfehlungen anhand deiner Modellpräferenzen, Ausgabegewohnheiten, des technischen Stacks deines Projekts, wichtiger Entscheidungen, anstehender Aufgaben und bekannter Probleme an und reduziert so wiederholte Abstimmungen. Bei Codeaufgaben liegt der Fokus standardmäßig auf den zentralen Änderungen, ergänzt durch eine Zusammenfassung. Bei Texten und Konzepten wird zunächst die Gesamtstruktur geklärt und anschließend nach Bedarf ausgearbeitet. So passt sich jedes Gespräch besser an dein aktuelles Projekt und deinen Arbeitsrhythmus an.
Ähnliche Fähigkeiten
Alle anzeigen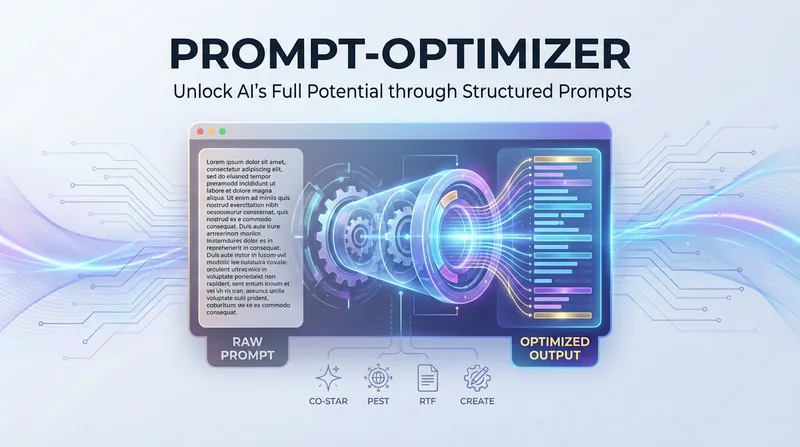
KI-Prompt-Optimierungsexperte
Der KI-Prompt-Optimierungsexperte verbessert mithilfe systematischer Frameworks die Qualität von Anweisungen und hilft dir, deine Absicht präzise zu vermitteln, damit die KI-Ausgaben stabiler und erwartungsgemäßer sind. Egal, ob du bestehende Anweisungen optimieren, komplexe Aufgabenbeschreibungen von Grund auf erstellen oder professionelle Vorlagen für bestimmte Szenarien suchen möchtest – diese Fähigkeit bietet umfassende Unterstützung. Sie kann vage Anfragen in strukturierte Anweisungen umwandeln und identifiziert durch Diagnoseprozesse häufige logische Fehler, um diese zu beheben. Die Fähigkeit verfügt über mehrere ausgereifte Optimierungsframeworks und passt die Strategie flexibel an die Art der Aufgabe an. Bei formellen Dokumenten und professionellen Inhalten legt sie beispielsweise mehr Wert auf die Festlegung von Kontext und Zielgruppe; bei Codegenerierung oder Datenverarbeitung hingegen liegt der Schwerpunkt auf Rollendefinition und konkreten Einschränkungen. Auf diese Weise stellt sie sicher, dass jede Anweisung klare Ziele, einen eindeutigen Stil und ein standardisiertes Ausgabeformat hat. Darüber hinaus enthält sie spezielle Vorlagen für viele häufige Anwendungsfälle – von Texterstellung über Datenanalyse bis hin zum Verfassen technischer Dokumentationen. Du kannst diese bewährten Strukturen direkt nutzen und schnell wichtige Informationen wie Kernbotschaften, Datenangaben oder Zielgruppenkontext einfügen. Während der Optimierung gleicht die Fähigkeit die Eingaben mit einer Qualitätscheckliste ab, und durch mehrere Iterationen sowie den Vergleich von Lösungen hilft sie dir, die wichtigsten Techniken des Prompt Engineerings zu erlernen, Kommunikationskosten erheblich zu senken und die Produktivität zu steigern.
Token-Spar-Experte
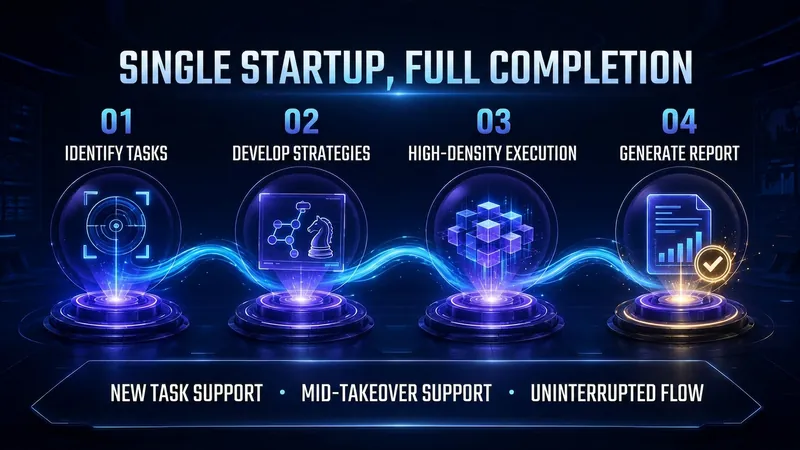
Hast du schon einmal berechnet, wie viel du jeden Monat für das 'Geschwafel' der KI bezahlst? "Okay, lass mich dir helfen..." "Lass uns zunächst deine Frage zusammenfassen..." "Zusammenfassend ist das oben Genannte..." Diese Sätze liest du nicht einmal, aber jedes Wort kostet dich Token. 💸 Ich habe einen Skill namens 'Token-Spar-Experte' entwickelt, der genau dagegen vorgeht: ✅ Automatische Erkennung des Aufgabentyps und Anwendung der Token-sparenden Strategie ✅ Entfernt Redundanz, nicht Tiefe – Qualität ohne Abstriche ✅ Nach der Aufgabe automatisch eine Abrechnung: Diesmal 40%+ gespart – klar und deutlich Wenn du KI regelmäßig nutzt, installiere ihn und spare ein paar Euro für den nächsten Kaffee. Eine Tatsache, die die meisten übersehen: Ein erheblicher Teil des Geldes, das du für KI ausgibst, fließt nicht in die 'Antworten', sondern in die 'Prozesssprache' – Begrüßungen, Wiederholungen der Frage, Überleitungen, Zusammenfassungen. Diese Inhalte erzeugen keinen Mehrwert, aber jeder Token wird abgerechnet. Ich habe die gesamte Methodik zur Optimierung der Informationsdichte in einen Skill verpackt: 'Token-Spar-Experte'. Seine Arbeitsweise ist direkt – er erkennt den Aufgabentyp, wendet automatisch die Token-sparende Strategie an, führt Aufgaben mit höchster Informationsdichte aus, entfernt alle redundanten Ausdrücke, während harte Vorgaben die Qualität sichern; nach Abschluss der Aufgabe erstellt er automatisch einen detaillierten Token-Bericht, der dir zeigt, wie viel jede Phase verbraucht hat, wie viel im Vergleich zum Standardmodus gespart wurde und wie du in Zukunft noch optimieren kannst. Unterstützt werden zwei Modi: Start von Anfang oder Übernahme während der Aufgabe – keine Konfiguration erforderlich. Wenn du ein intensiver KI-Nutzer bist – Autor, Forscher, Ersteller von Masseninhalten, API-Nutzer mit nutzungsabhängiger Abrechnung – ist dieser Skill im Wesentlichen eine 'Geldsparmaschine': Einmal installiert, reduziert er bei jedem Gespräch deine Kosten. Jetzt im YouMind Skill-Markt verfügbar – suche nach 'Token-Spar-Experte', um ihn zu installieren.
Forschungsantrags-Assistent
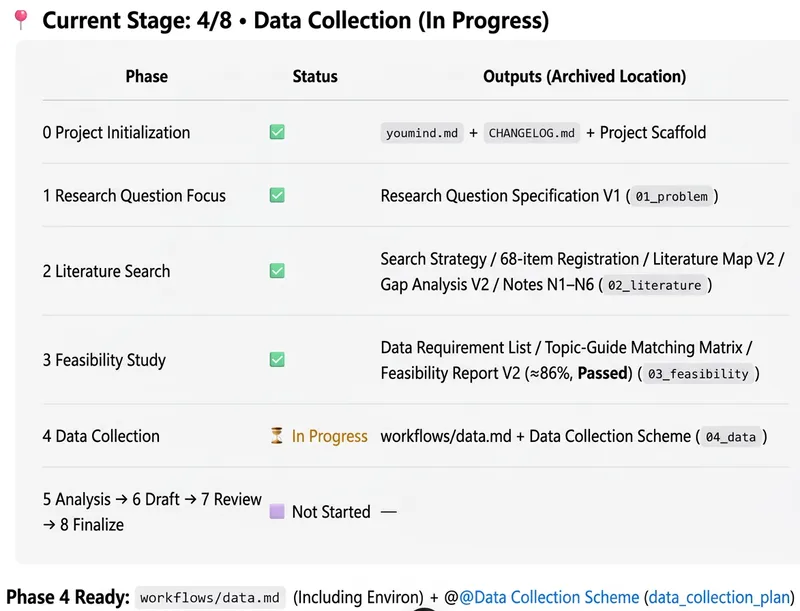
Für Hochschullehrende und Forschende: Ausgehend von einer vagen Forschungsidee entsteht Schritt für Schritt ein umsetzbares und antragsfähiges Forschungsvorhaben. Unterstützt werden nationale und provinzielle geistes- und sozialwissenschaftliche Projekte, Lehrreformprojekte sowie weitere Arten von Forschungsvorhaben. Du stellst lediglich Projektart und Ausschreibung oder Vorlage, Forschungsrichtung, bisherige成果 sowie persönliche Angaben und Informationen zur Einrichtung bereit. Der Assistent hilft dir dann, Forschungsfrage, Antragsanforderungen und Bewertungslogik zusammenzuführen, das Thema zu präzisieren, die Fragestellung zu fokussieren und einen vollständigen Grundrahmen für den Antrag zu erstellen. Im weiteren Verlauf unterstützt der Assistent bei der wissenschaftlichen Recherche, der Aufarbeitung von Literatur, der Analyse von Forschungslücken, der Begründung der Machbarkeit von Daten und Methoden, dem Abgleich mit ähnlichen Projekten sowie der Anpassung des Forschungsdesigns. Dabei wird darauf geachtet, dass Literatur, Daten und Angaben zu bewilligten Projekten tatsächlich überprüfbar sind. Die Integration von KI, Aktualität und methodische Innovation werden in Thema und Innovationspunkten konkret umgesetzt. Sobald der Forschungsplan ausgereift ist, kann der Assistent anhand deiner Ausschreibung oder einer leeren Vorlage einen ersten Entwurf des Antrags verfassen, Änderungen aus unterschiedlichen Begutachtungsperspektiven vorschlagen und den Text fortlaufend bis zur finalen Fassung überarbeiten. Das gesamte Projekt bewahrt Zwischenergebnisse, Versionsverläufe und Begründungen für Änderungen. Am Ende können der Antrag, ein technischer Ablaufplan, ein Forschungsrahmendiagramm, ein Logikdiagramm der Innovationspunkte und ein Gantt-Diagramm zum Zeitplan zusammengestellt werden. Für Aufgaben, die eine externe Umgebung benötigen, etwa die vollständige Analyse von PDFs, das Ausführen von Code, das Abrufen von Daten oder die Verarbeitung großer Datenmengen, weist der Assistent die Übergabe klar aus und unterstützt das spätere Einfügen und Fortsetzen. So begleitet er dich von der Vorbereitung des Vorhabens bis zur formal korrekten Endfassung.
Informationen
- Version
- v2
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Automatisch