So erstellen Sie mit YouMind aus PDFs, Web-Seiten und Notizen ein Kunden-Deck (Vollständiges Tutorial)
Verwandt: Eine Präsentations-Skill auswählen → 10 Skills für professionelle Decks. Ein Deck aus deinen eigenen Materialien fertigstellen → dieser Artikel.
Was dieser Leitfaden löst (30 Sekunden)
Du hast bereits einen PDF-Bericht, zwei Referenzseiten und deine eigenen Notizen. Du brauchst in wenigen Stunden ein fertiges Briefing-Deck – nicht noch eine weitere Fünf-Schritte-Übersicht à la „Sammeln → Gliedern → Generieren → Bearbeiten → Exportieren“.
Dieser Artikel führt einen echten YouMind-Fall von Anfang bis Ende durch: Quellenliste, was wir gestrichen haben, was der erste Entwurf falsch gemacht hat, Korrekturen auf Folienebene, eine Stilentscheidung, die wir verworfen haben, und Export-Limits, die du kennen solltest, bevor du ein „bearbeitbares PowerPoint“ versprichst. Wenn du fertig bist, solltest du den Ablauf mit deiner PDF und deinen Notizen wiederholen können – und wissen, was nach der Generierung zu korrigieren ist.
Szenario (festgelegt): ein internes Briefing im Stil eines Knowledge Workers / Beraters. In dieser Demo fragt das Briefing, welche zwei KI-Workflows ein kleines Content-Team nächsten Monat testen könnte. Wir weiten das hier nicht auf Studenten-, Pitch- oder Schulungsfälle aus; für die Suche nach Skills/Stilen nutze die oben verlinkte Sammlung.
Fall-Setup und Quellenliste
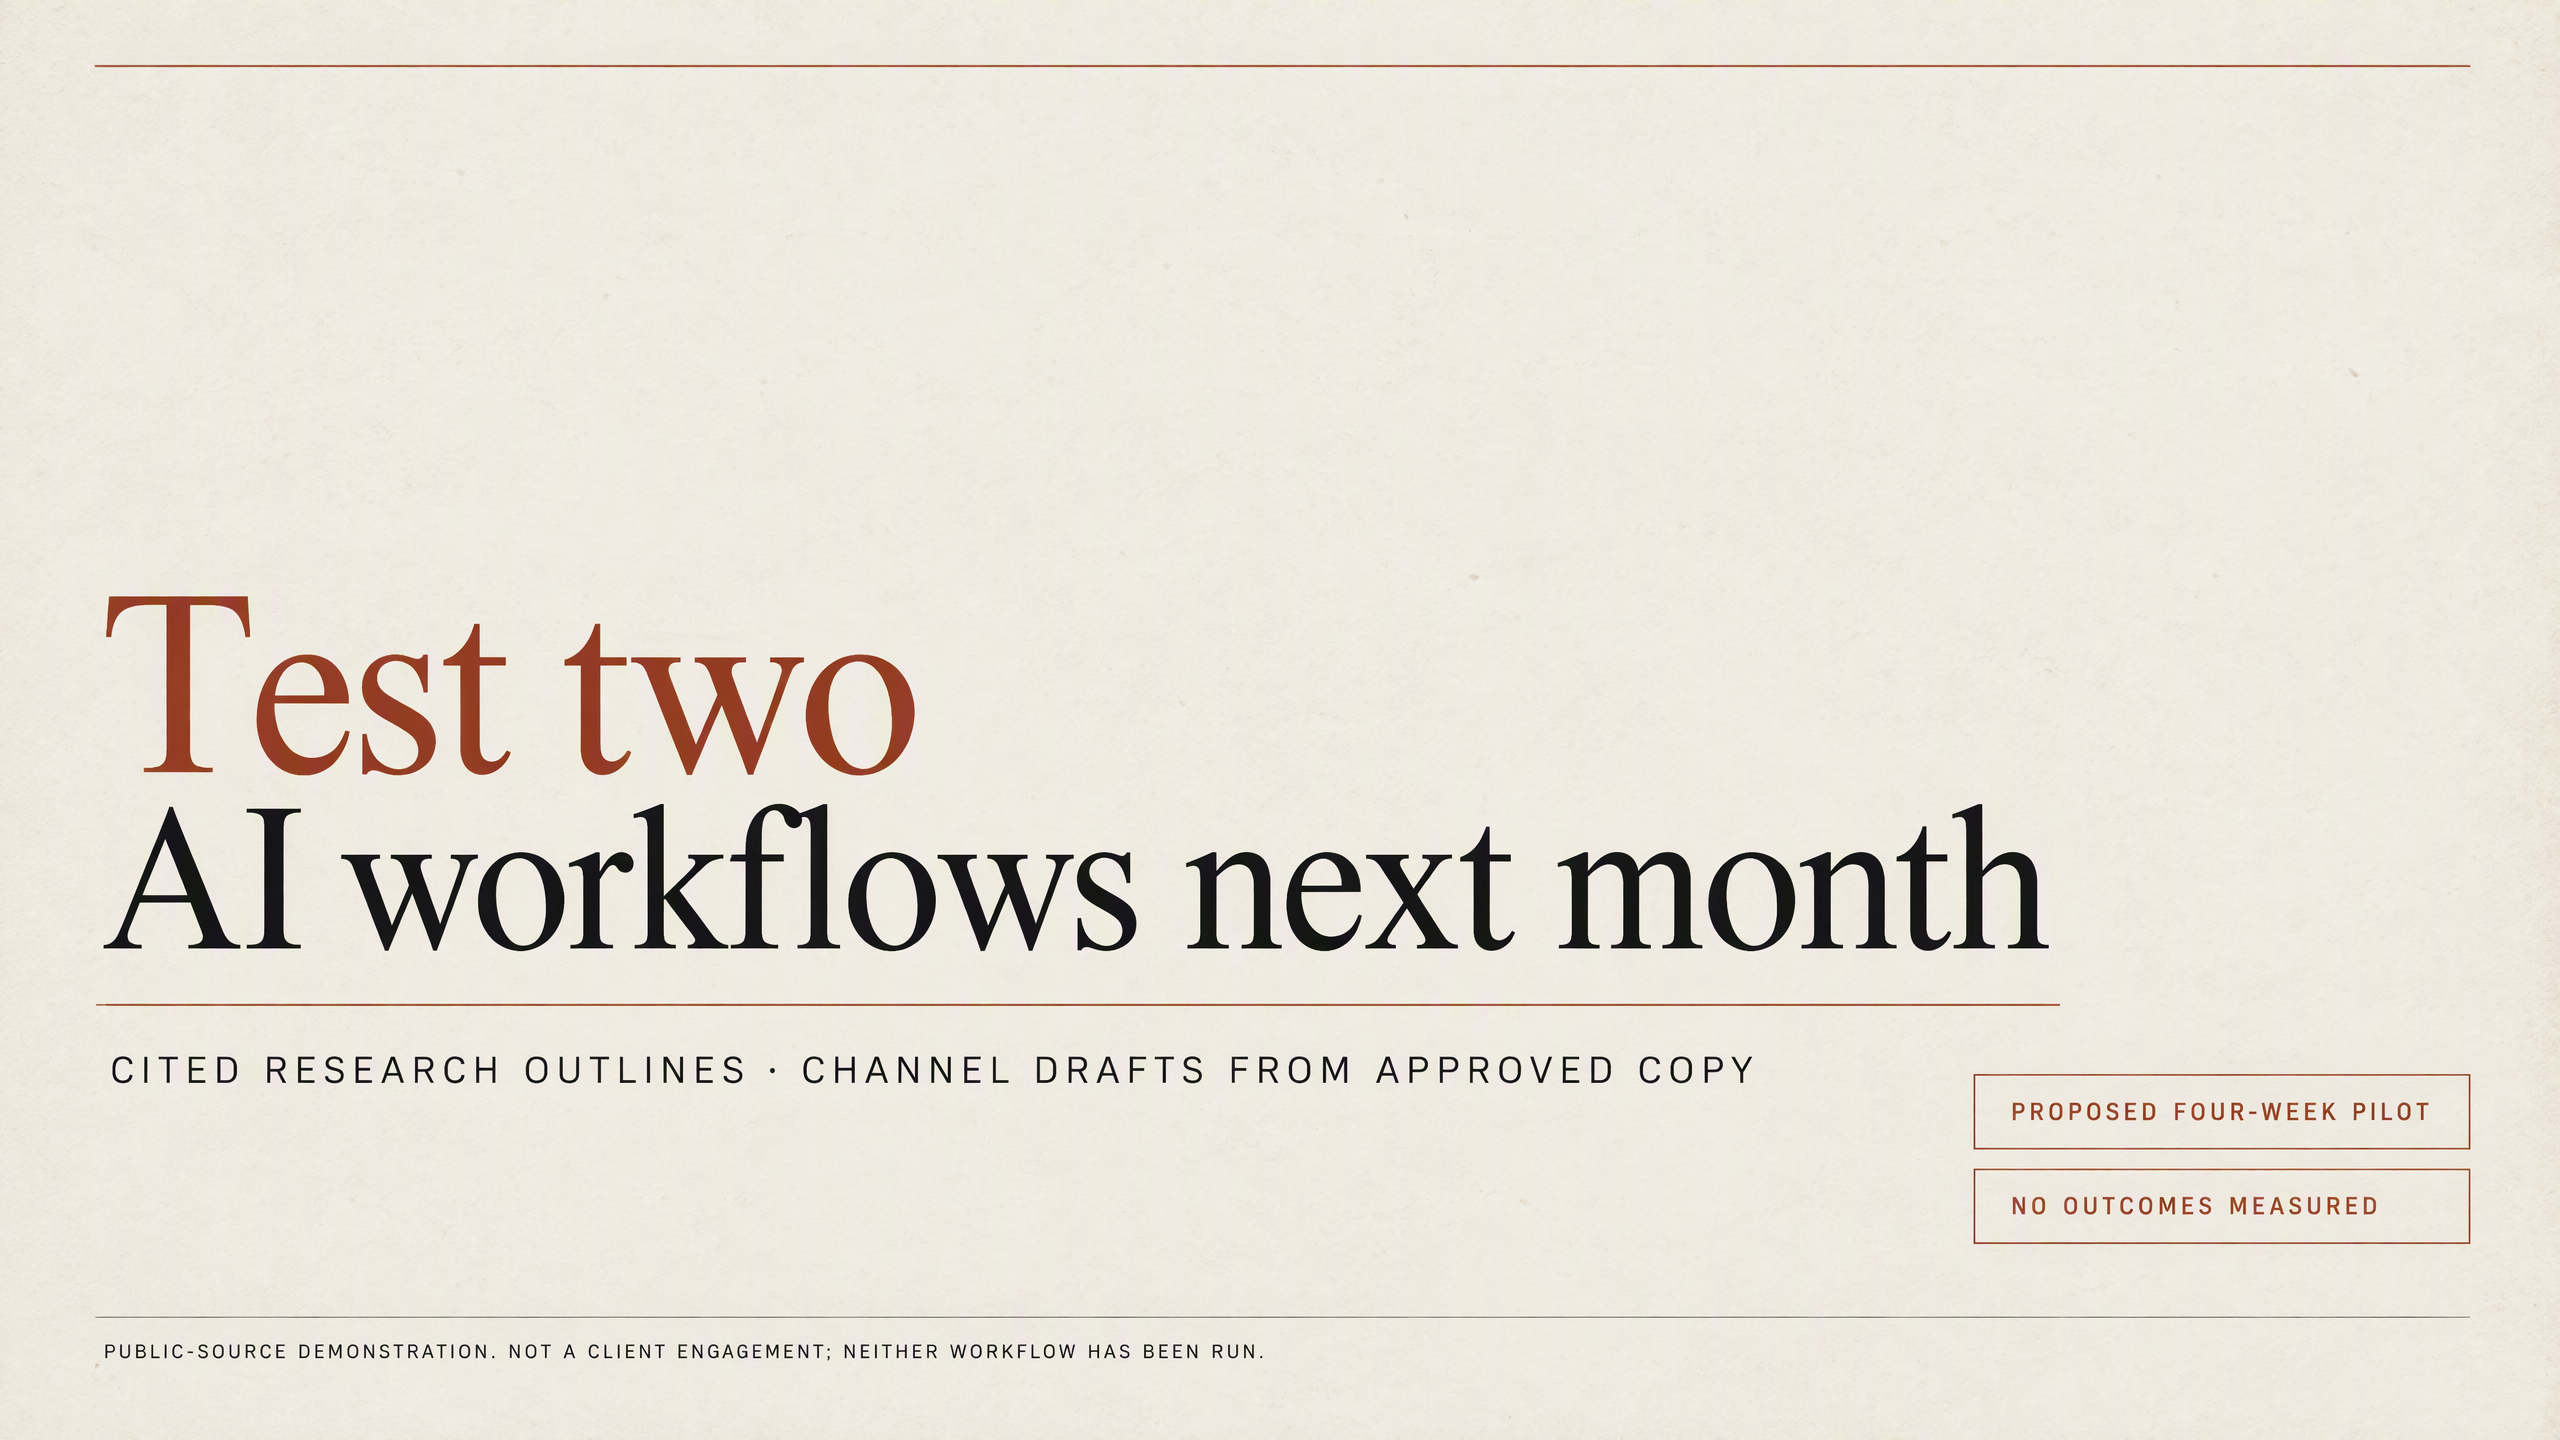
- **Ziel** — Einer Content-Leitung und Redakteuren zwei vierwöchige KI-Workflow-Piloten vorschlagen; klären, was Menschen verantworten und wie über eine Fortführung entschieden wird
- **Publikum — Kleines Content-Team · ~10 Minuten · 8 englische Folien**
- **Messlatte** — Kontrollierbare Länge, präsentationsreife Aussagen, jede wichtige Zahl auf eine Quelle zurückführbar – keine erfundenen Kunden, Mitarbeiterzahlen, Budgets oder „eingesparten Zeiten“
- **Kennzeichnung** — Tutorial-Demonstration mit öffentlichen Quellen – kein Kundenauftrag, kein freigegebener interner Plan
Quellen
- Quelle: Microsoft 2026 Work Trend Index (PDF) · Rolle: Primär · Ergebnis: Beibehalten; gedruckte Seitenzahlen für Prüfungen genutzt
- Quelle: Anthropic Economic Index: Cadences (Web) · Rolle: Unterstützend · Ergebnis: Beibehalten; nach Kapitel zitiert
- Quelle: Stanford 2026 AI Index — Economy (Web) · Rolle: Geplante Unterstützung · Ergebnis: Ausgeschlossen – der Capture enthielt nur Navigation/CSS, keinen Fließtext
- Quelle: Projektbriefing / Research Notes / Ursprüngliches Briefing · Rolle: Aussagen, Verbote, Publikum · Ergebnis: Beibehalten; Setup begann auf Chinesisch, Auslieferung wurde vor der Foliengenerierung auf Englisch festgelegt
Drei Fragen, bevor du generierst (Entscheidung #0)
Schreib diese zuerst auf. Jeder spätere Schnitt hängt davon ab.
- Welche Entscheidung muss das Publikum treffen? Zwei vierwöchige Piloten genehmigen – und die Abbruchregeln –, bevor jemand anfängt.
- Welche Aussage verteidigen wir? Nutzungsdaten sind ein Grund, einen kleinen Test durchzuführen, keine Prognose über Einsparungen. Beide Workflows sind Vorschläge; es wurde noch nichts gemessen.
- Was ist verboten? Erfundene Kunden, Mitarbeiterzahlen, Budgets oder Effizienzgewinne; die Nutzer eines einzelnen Produkts auf eine ganze Branche zu verallgemeinern; jede Zahl ohne Quelle, Grundgesamtheit und Nenner.
Noch eine Entscheidung in diesem Durchlauf: Die ursprüngliche Aufgabennotiz und die vorläufige Gliederung waren auf Chinesisch. Vor der Foliengenerierung wurde die Auslieferungssprache auf Englisch festgelegt; das englische Projektbriefing ersetzt die frühere Notiz.
Von den Quellen zur Gliederung: Was blieb, was wir rausgeworfen haben
PDF, Seiten und Notizen auf ein Board zu bringen, ist der einfache Teil. Die Gliederung kostet Zeit – wegen der Auswahl, nicht wegen des Layouts.
Gestrichen (absichtlich, mit Dokumentation)
- Stanford-Economy-Kapitel: Fließtext unlesbar → aus der Argumentation ausgeschlossen und als Import-Limit auf dem Deck und in den Research Notes gekennzeichnet. Kein Raten.
- Ein Dutzend „verfügbarer, aber nicht essenzieller“ Prozentwerte (Output-Mix, selbstberichtete Gewinne, Lohnvergleiche und mehr) → entfernt, damit das Deck kein Statistikmuseum wird.
- Genaue Erhebungszeiträume der Umfragen → die Quellennotizen widersprachen sich selbst; das Deck sagt nur „Umfrage 2026“.
- Pilot 1 als review-freie „Delegation“ und Pilot 2 als Umschreiben des Originalartikels in einen „zweiten Entwurf“ darzustellen → korrigiert: Beide Piloten brauchen ein redaktionelles Review; Pilot 2 startet von einem freigegebenen Text und schreibt niemals den Quellartikel um.
- 49 % als „aller Gespräche“ anzugeben → korrigiert gemäß Anmerkung zur Zahl: Anteil der klassifizierten Nutzerziele (Microsoft WTI, gedruckte S. 08) – nicht Zeit, nicht Sitzungsanzahl.
Nur zwei Fakten haben es auf die Folien geschafft
- F1: In den ausgewerteten Copilot-Gesprächen unterstützen 49 % der klassifizierten Nutzerziele kognitive Arbeit (Analysieren, Problemlösen, Bewerten, kreatives Denken und Verwandtes). Quelle: Microsoft 2026 Work Trend Index, S. 08. Nenner: klassifizierte Nutzerziele.
- F2: Unter den als arbeitsbezogen klassifizierten Claude-Gesprächen sind Dokumente und Berichte mit etwa 20 % das häufigste Artefakt. Quelle: Anthropic Cadences, Kapitel 2. Nenner: als Arbeit klassifizierte Gespräche.
Unterschiedliche Nenner bleiben auf getrennten Panels. Wir führen sie nie zu einer Einsparungsaussage zusammen.
Gliederungs-Gate: eine Aussage pro Folie; fehlende Belege markieren; bei acht Folien für einen zehnminütigen Vortrag bleiben.
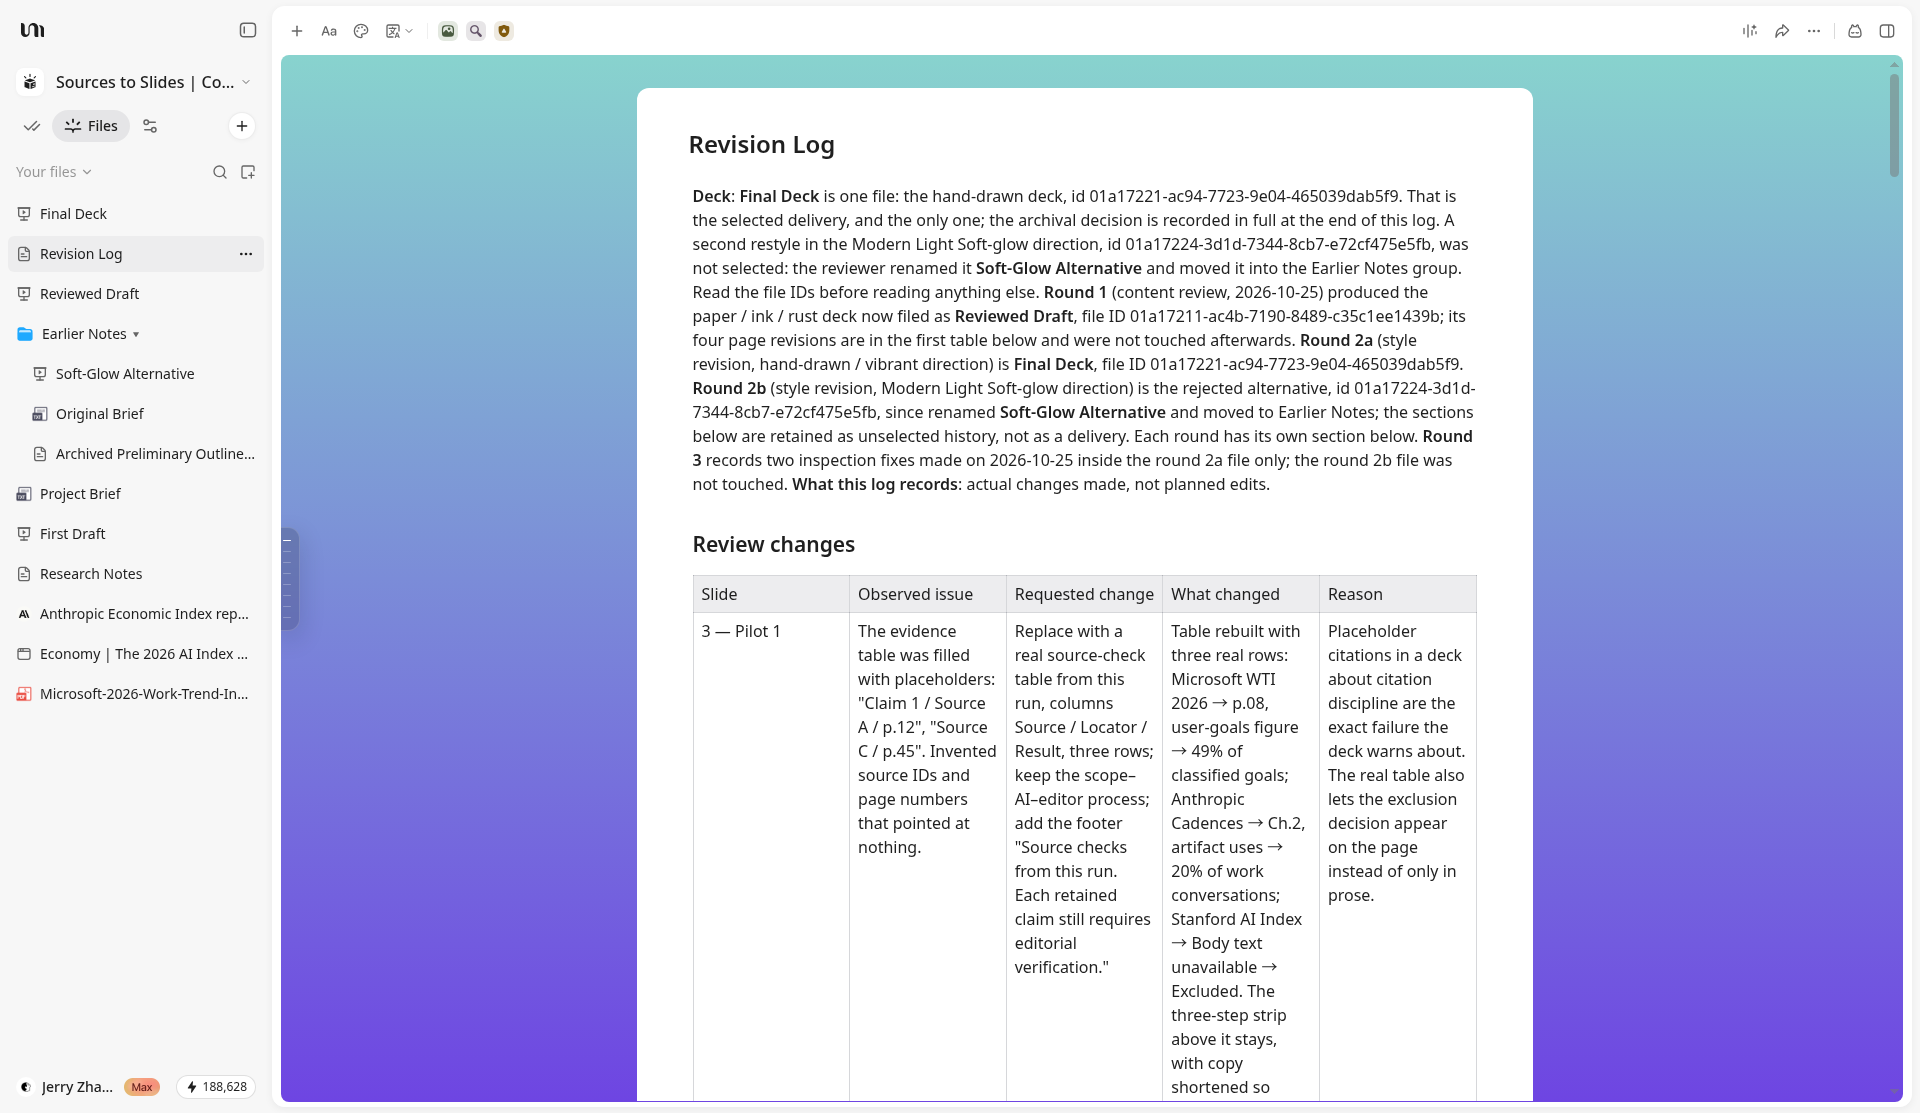
Wie dieser Fall das Deck tatsächlich generiert hat
- Phase: Erster Entwurf · Was wir taten: Board-Konversation „Build the Content Team Pilot Deck“ (keine separate „Architect PRO“-Skill – hier nicht so nennen)
- Phase: Inhaltliche Überarbeitung · Was wir taten: Runde 1 → Reviewed Draft (inhaltliche Korrekturen auf Folienebene)
- Phase: Finale Optik · Was wir taten: Vibrant handdrawn for young professional Skill (v1) kompletter Restyle → Final Deck
- Phase: Verworfene Alternative · Was wir taten: Modern Light Soft-glow Skill (v9) → umbenannt in Soft-Glow Alternative, verschoben zu Earlier Notes
Wenn du noch einen Stil oder eine Skill für einen anderen Job auswählen musst, nutze die Skills-Sammlung und die Skills-Galerie. Scheduled Tasks und „gleiches Board, andere Formate“ bekommen in diesem Artikel höchstens einen Satz – sie sind nicht das Rückgrat.
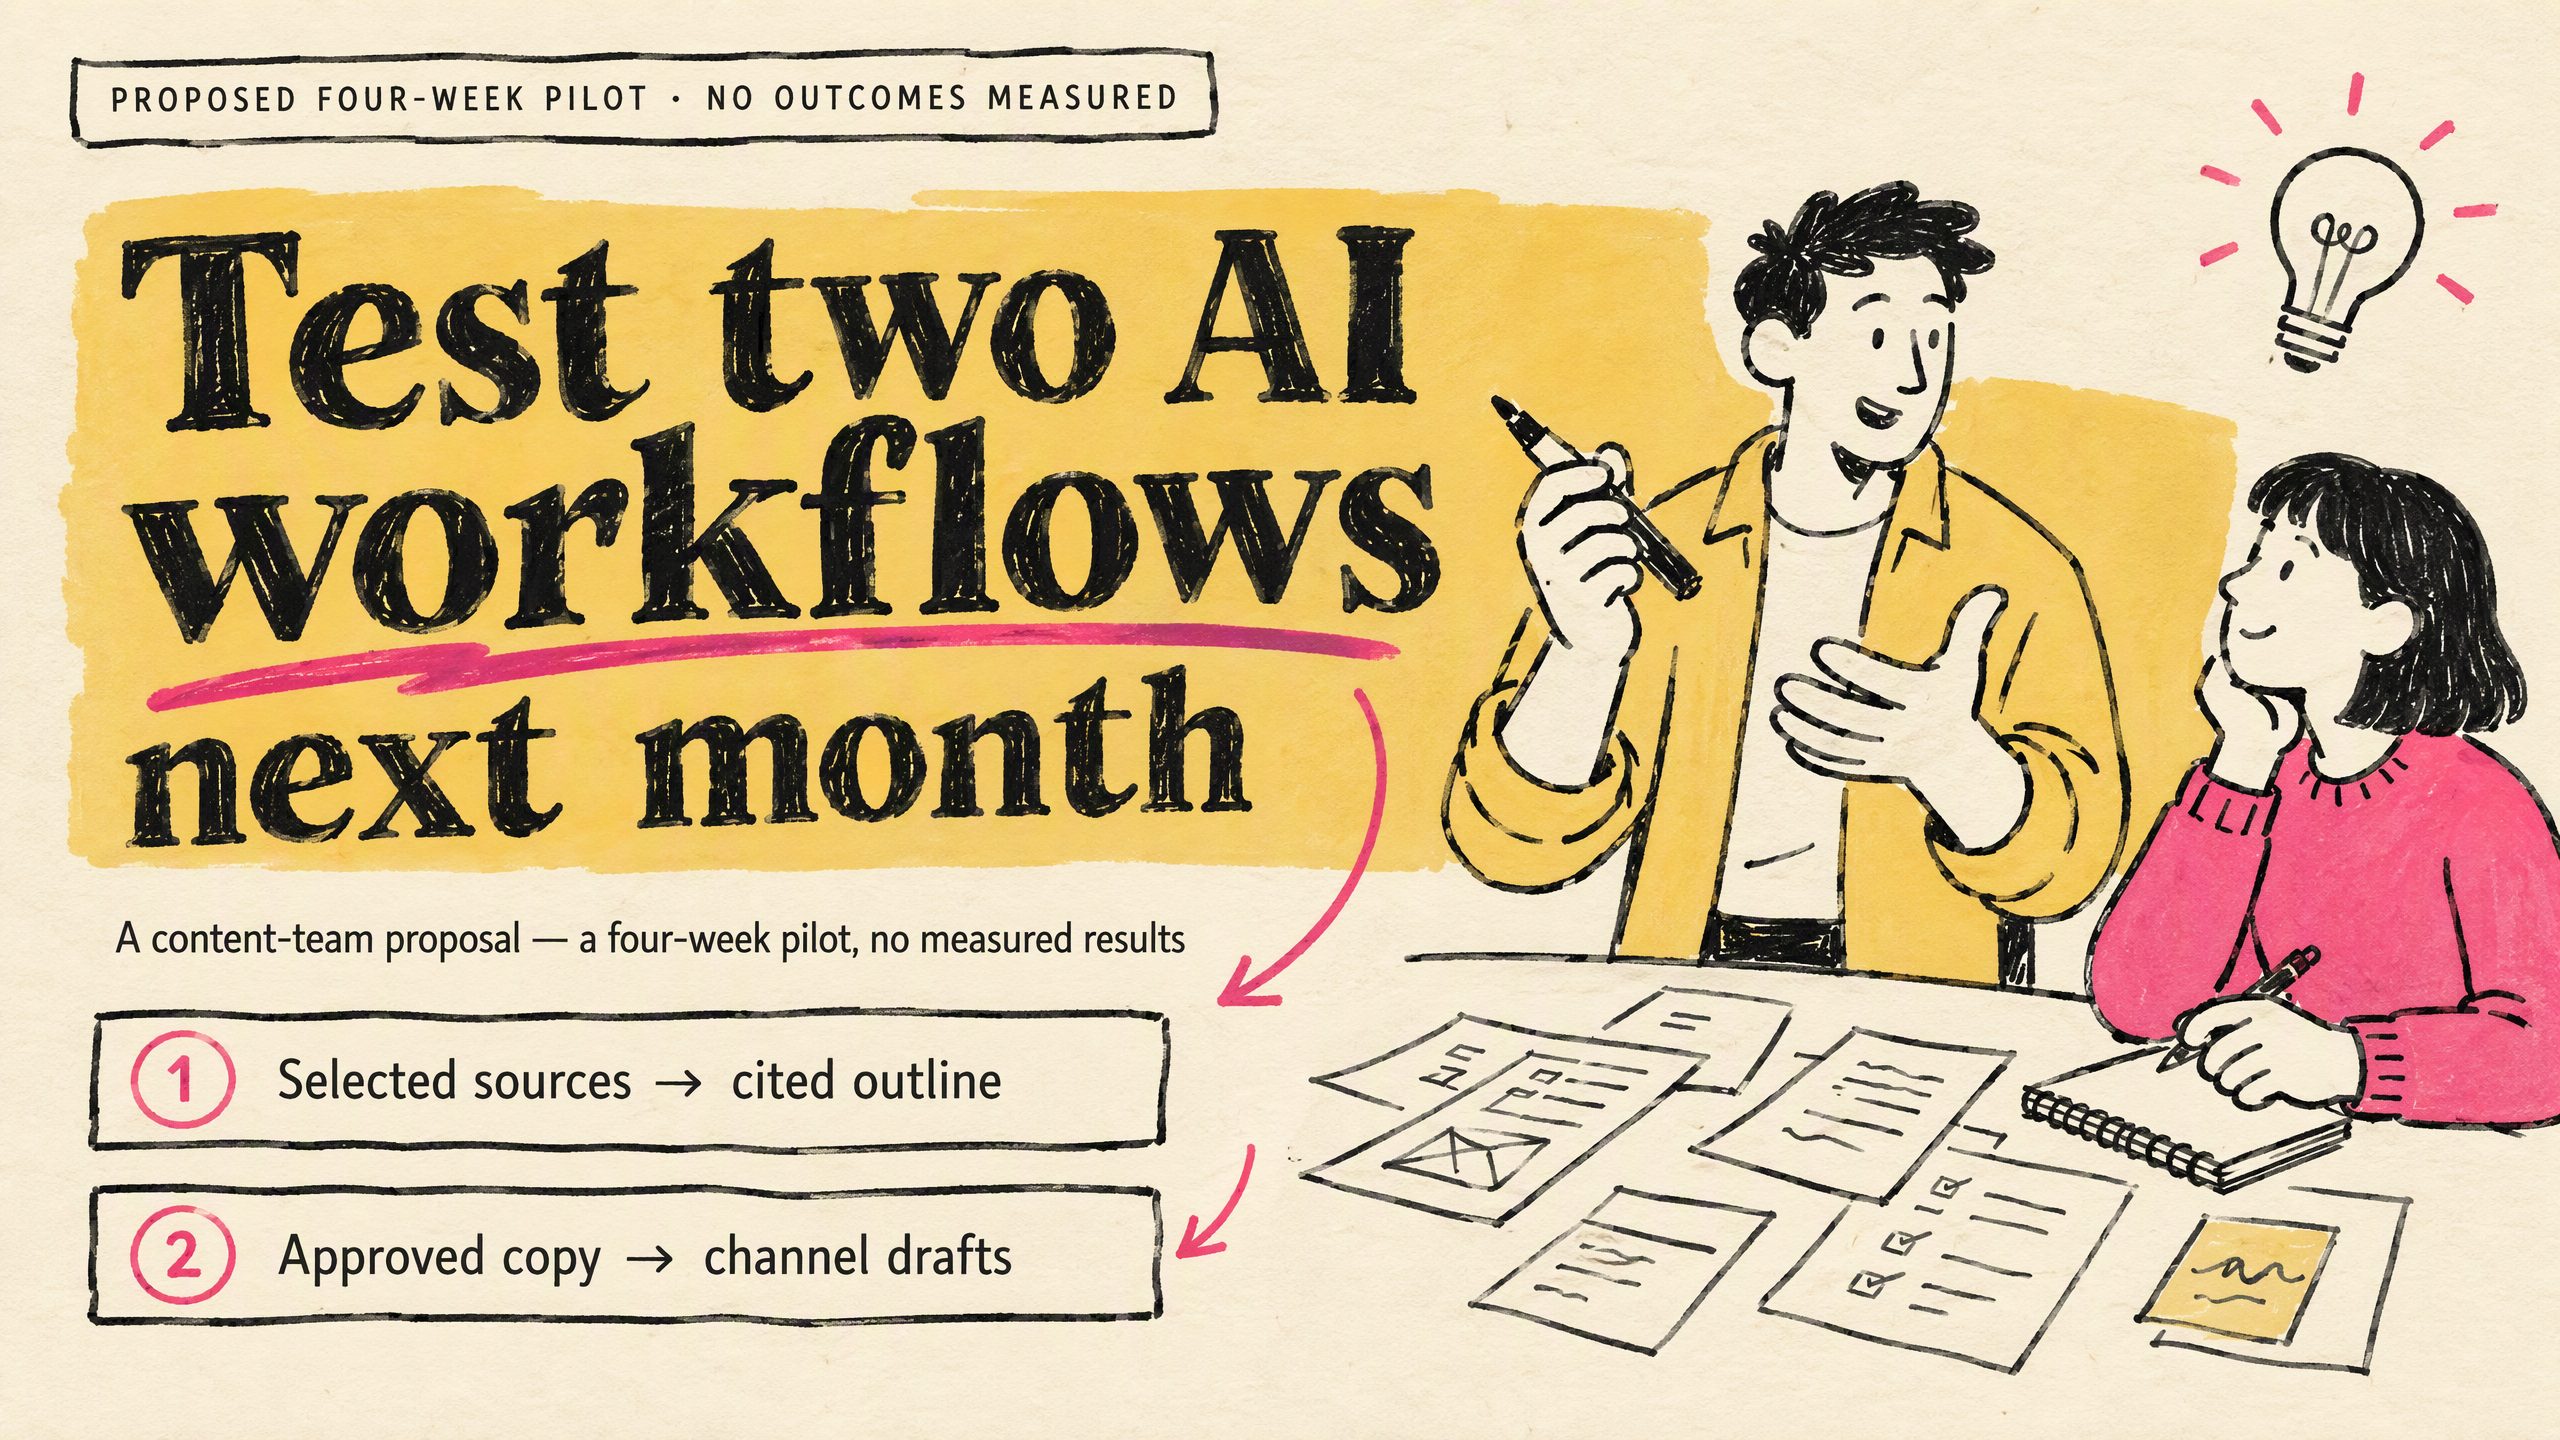
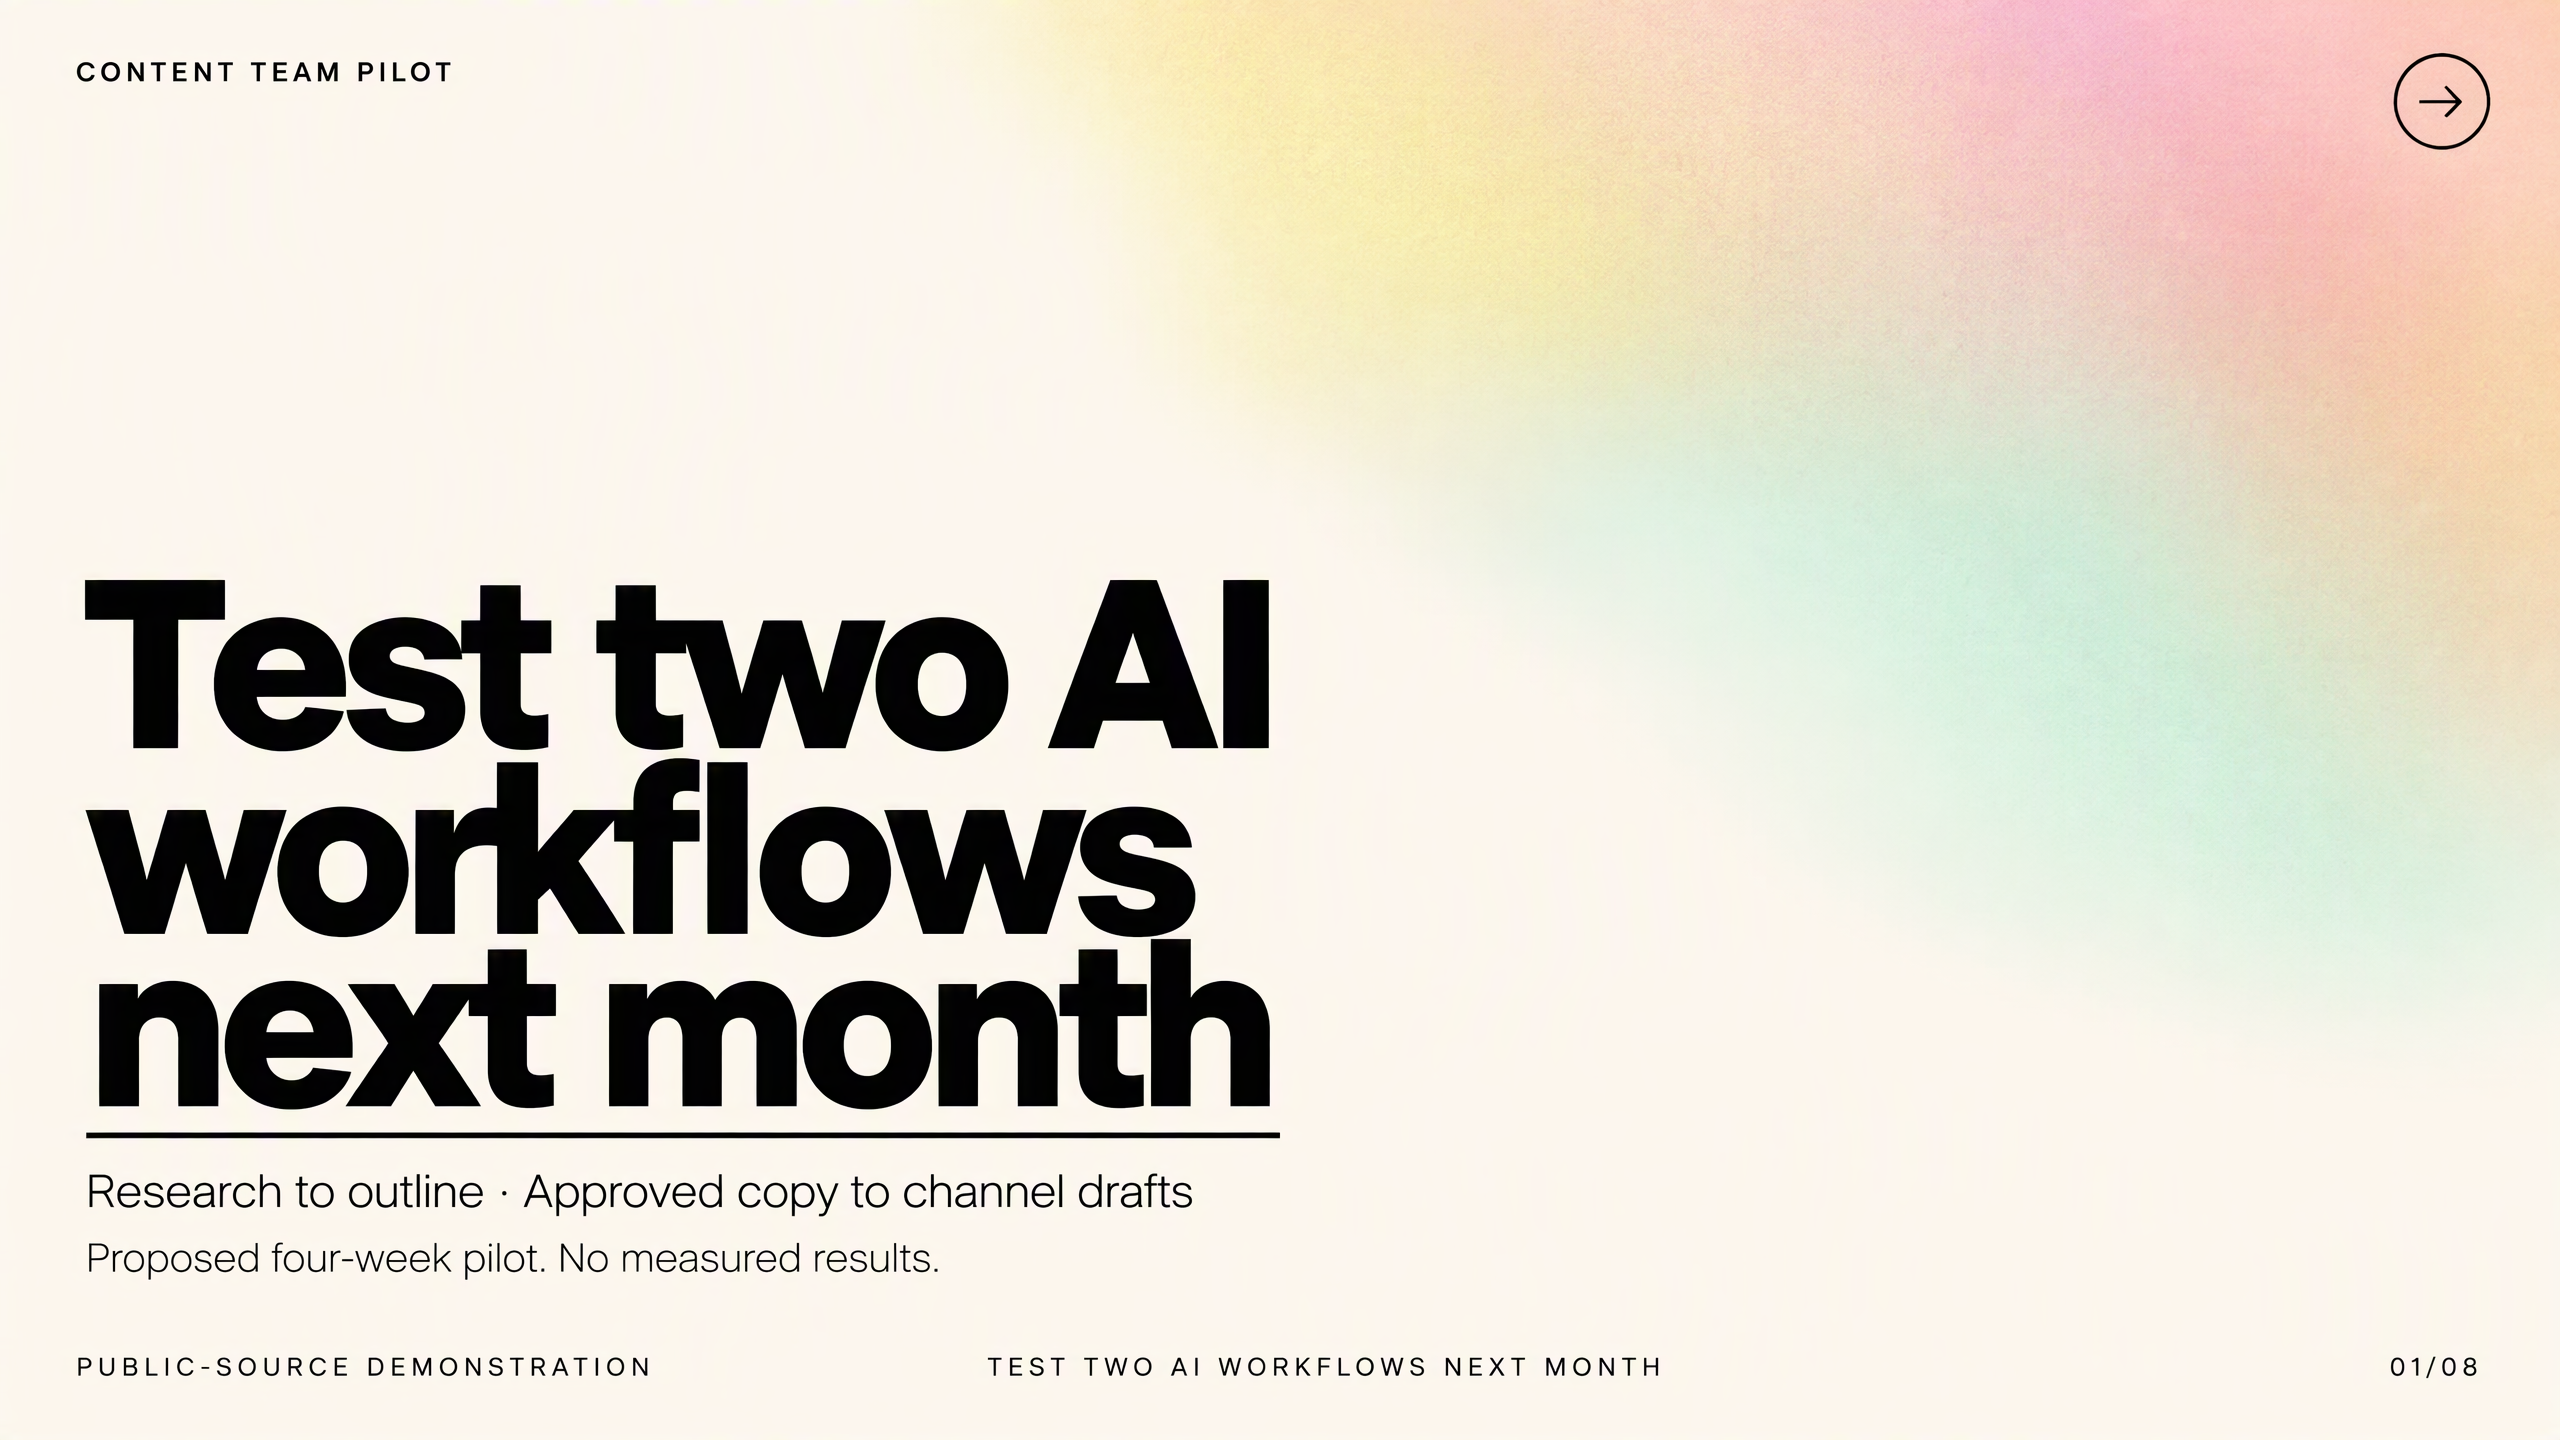
Wie der erste Entwurf aussah
Der First Draft hatte bereits ein vollständiges achtseitiges englisches Rückgrat – und war trotzdem nicht auslieferbar.
- Cover- und Empfehlungsfolien sahen relativ sauber aus.
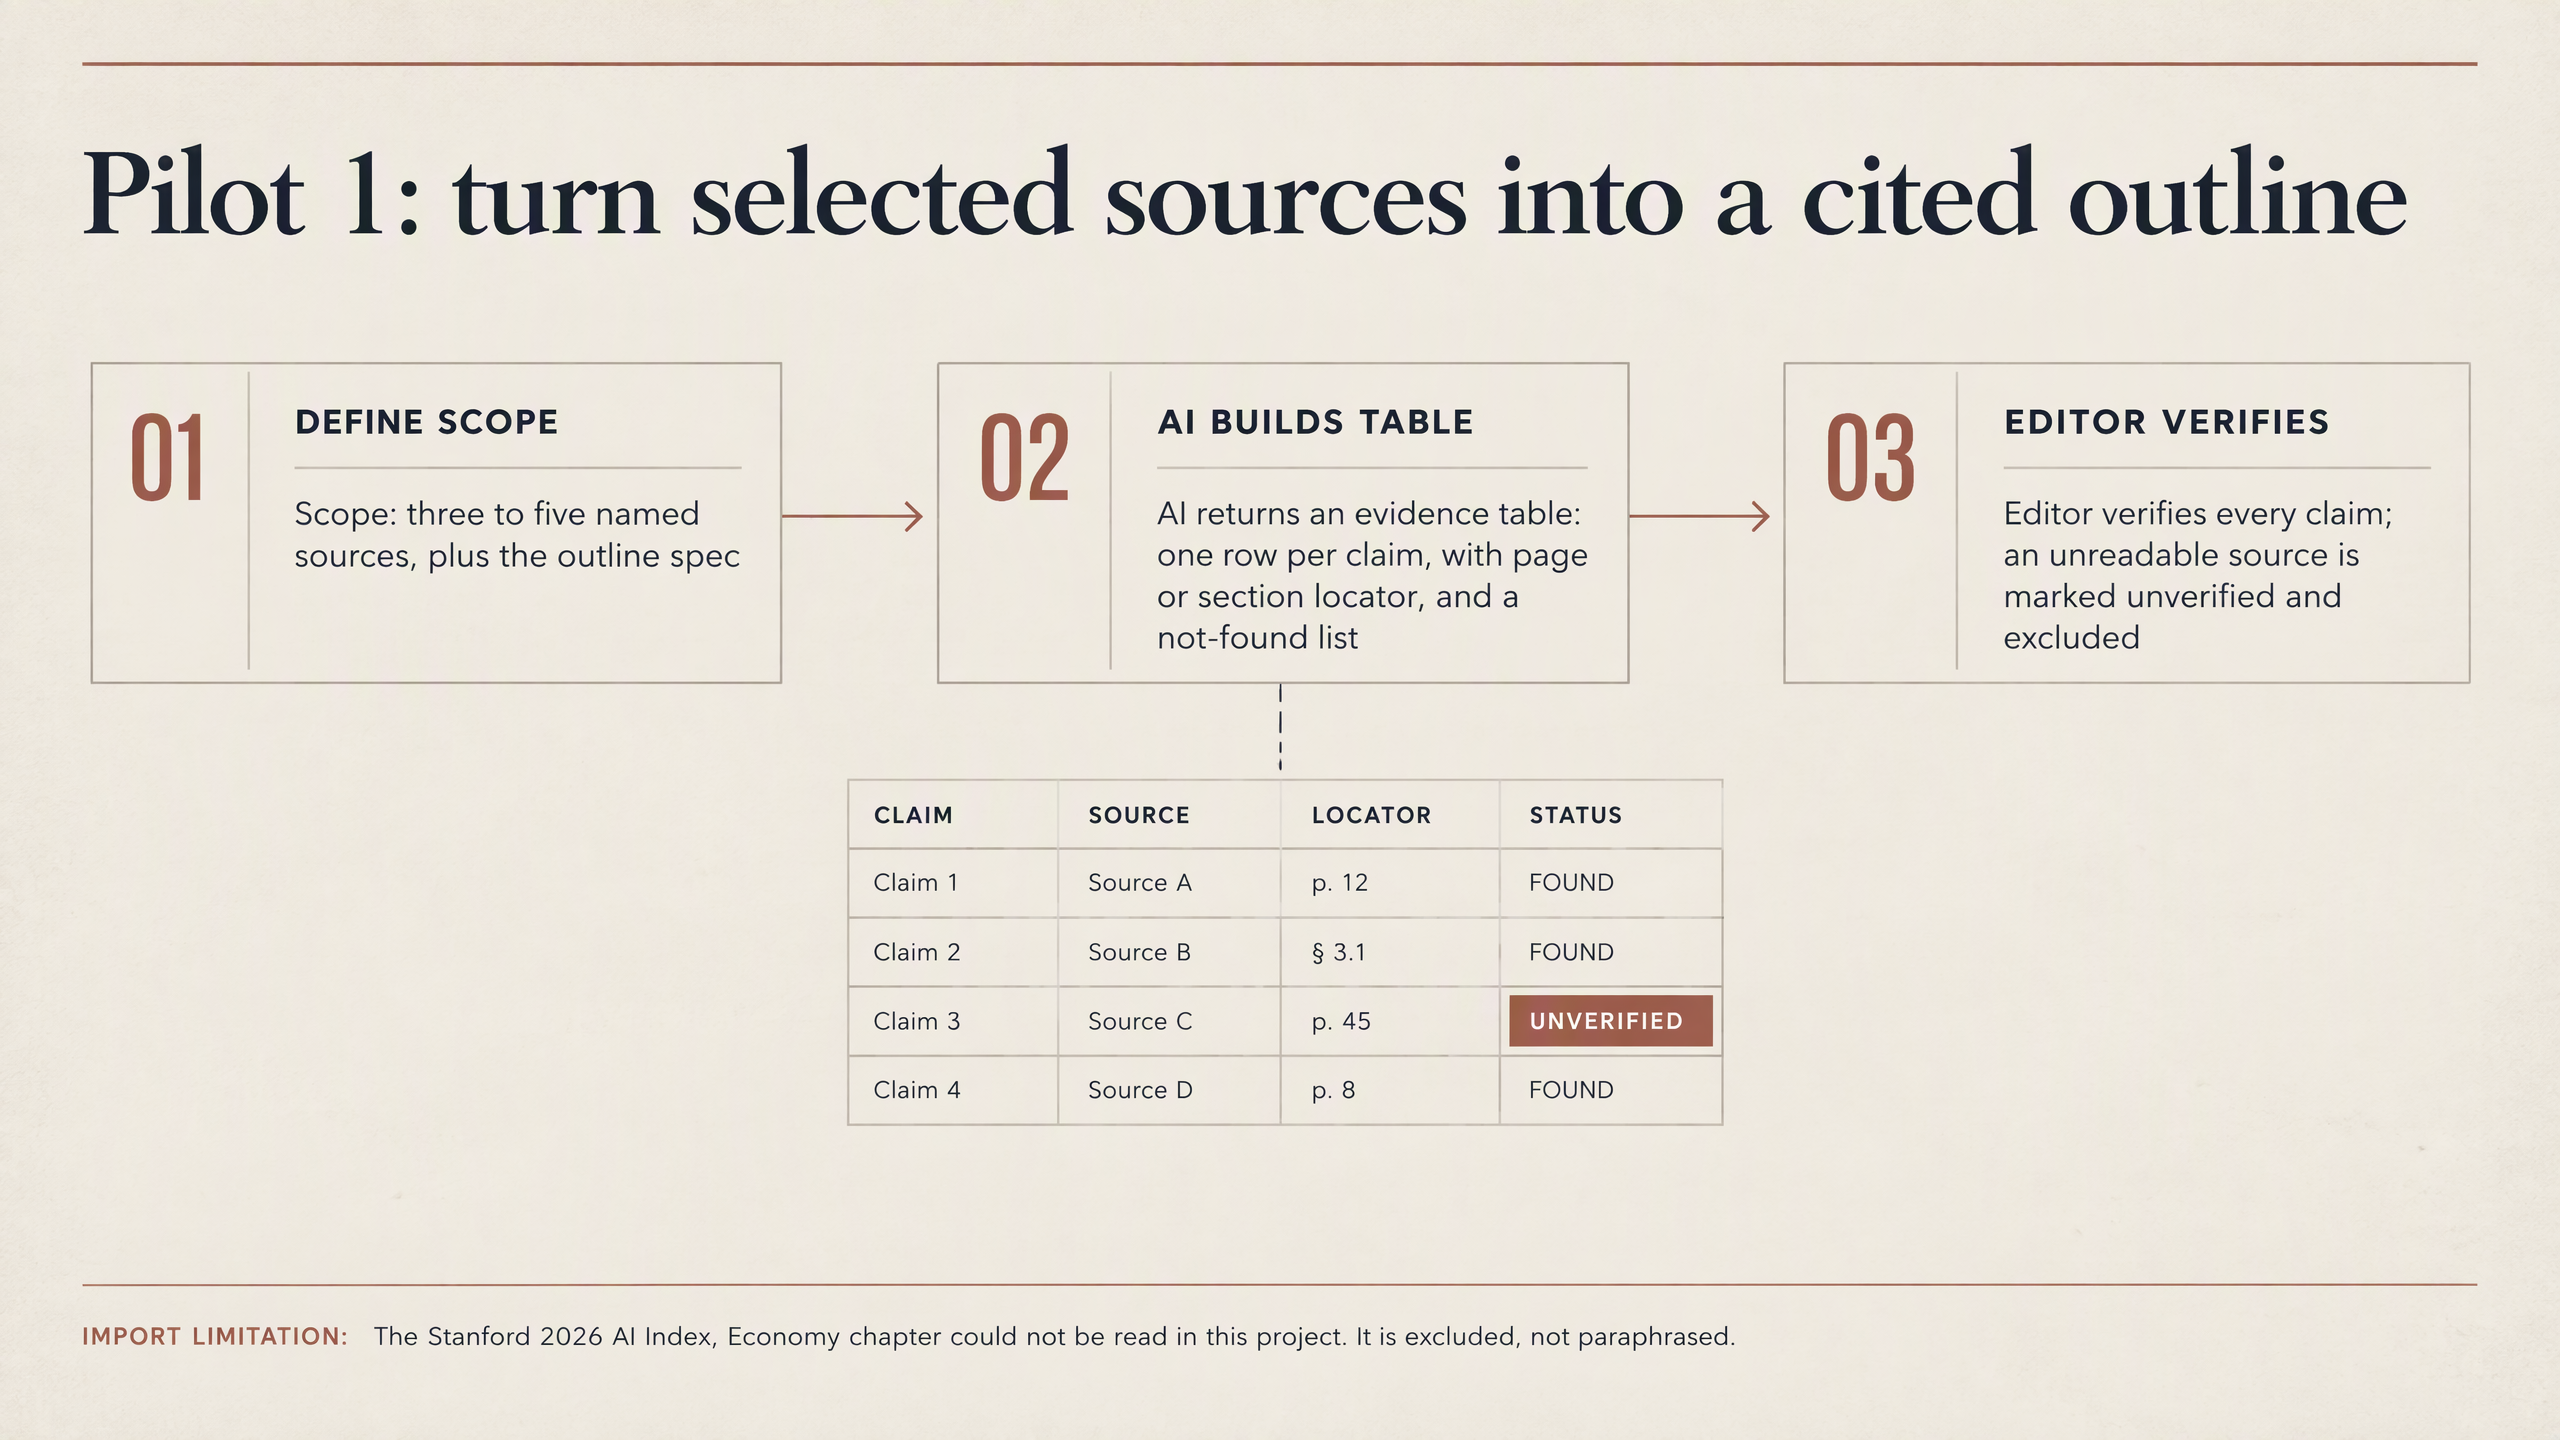
- Problemfolien waren bereits eingebaut: Die Belegtabelle von Pilot 1 zeigte Platzhalter wie „Aussage 1 / Quelle A / S. 12“; Pilot 2 nutzte CHANNEL-A/B/C-Karten, die eigentlich Prozessschritte auflisteten; der Fehlermodi-Folie fehlten Spaltenüberschriften, und derselbe Satz wurde in Warnungs- und Prüfzellen dupliziert.
Den Ton zu polieren repariert das nicht. Du reparierst es anhand der Quellen. Alles unten stammt aus dem Revision Log des Boards – echte Änderungen, keine nachträglich angepasste Best-Practice-Liste.
Editier-Checkliste (der Kern dieses Artikels)
1. Quellen verwerfen: Leere Captures gehören aufs Deck
Stanford wurde nicht nur in den Notizen gestrichen. Der Quellenprüfungs-Streifen des finalen Decks sagt Fließtext nicht verfügbar → Ausgeschlossen. In einem Zitations-Workflow lautet das ehrliche Ergebnis oft „unbestätigt“, nicht eine erfundene Seite.
Es gab einen zweiten Verwurf beim Stil: Der Soft-Glow-Restyle wurde vollständig generiert und nicht ausgewählt. Das Log verzeichnet zwei HTTP-404-Fehler beim Versuch abzubrechen, sodass der Job weiterlief – das ist ein fehlgeschlagener Abbruch, kein ruhiger A/B-Test. Schreib das nicht als absichtliche Doppel-Auslieferung um.
2. Struktur neu schreiben: Die Grenze von Pilot 2
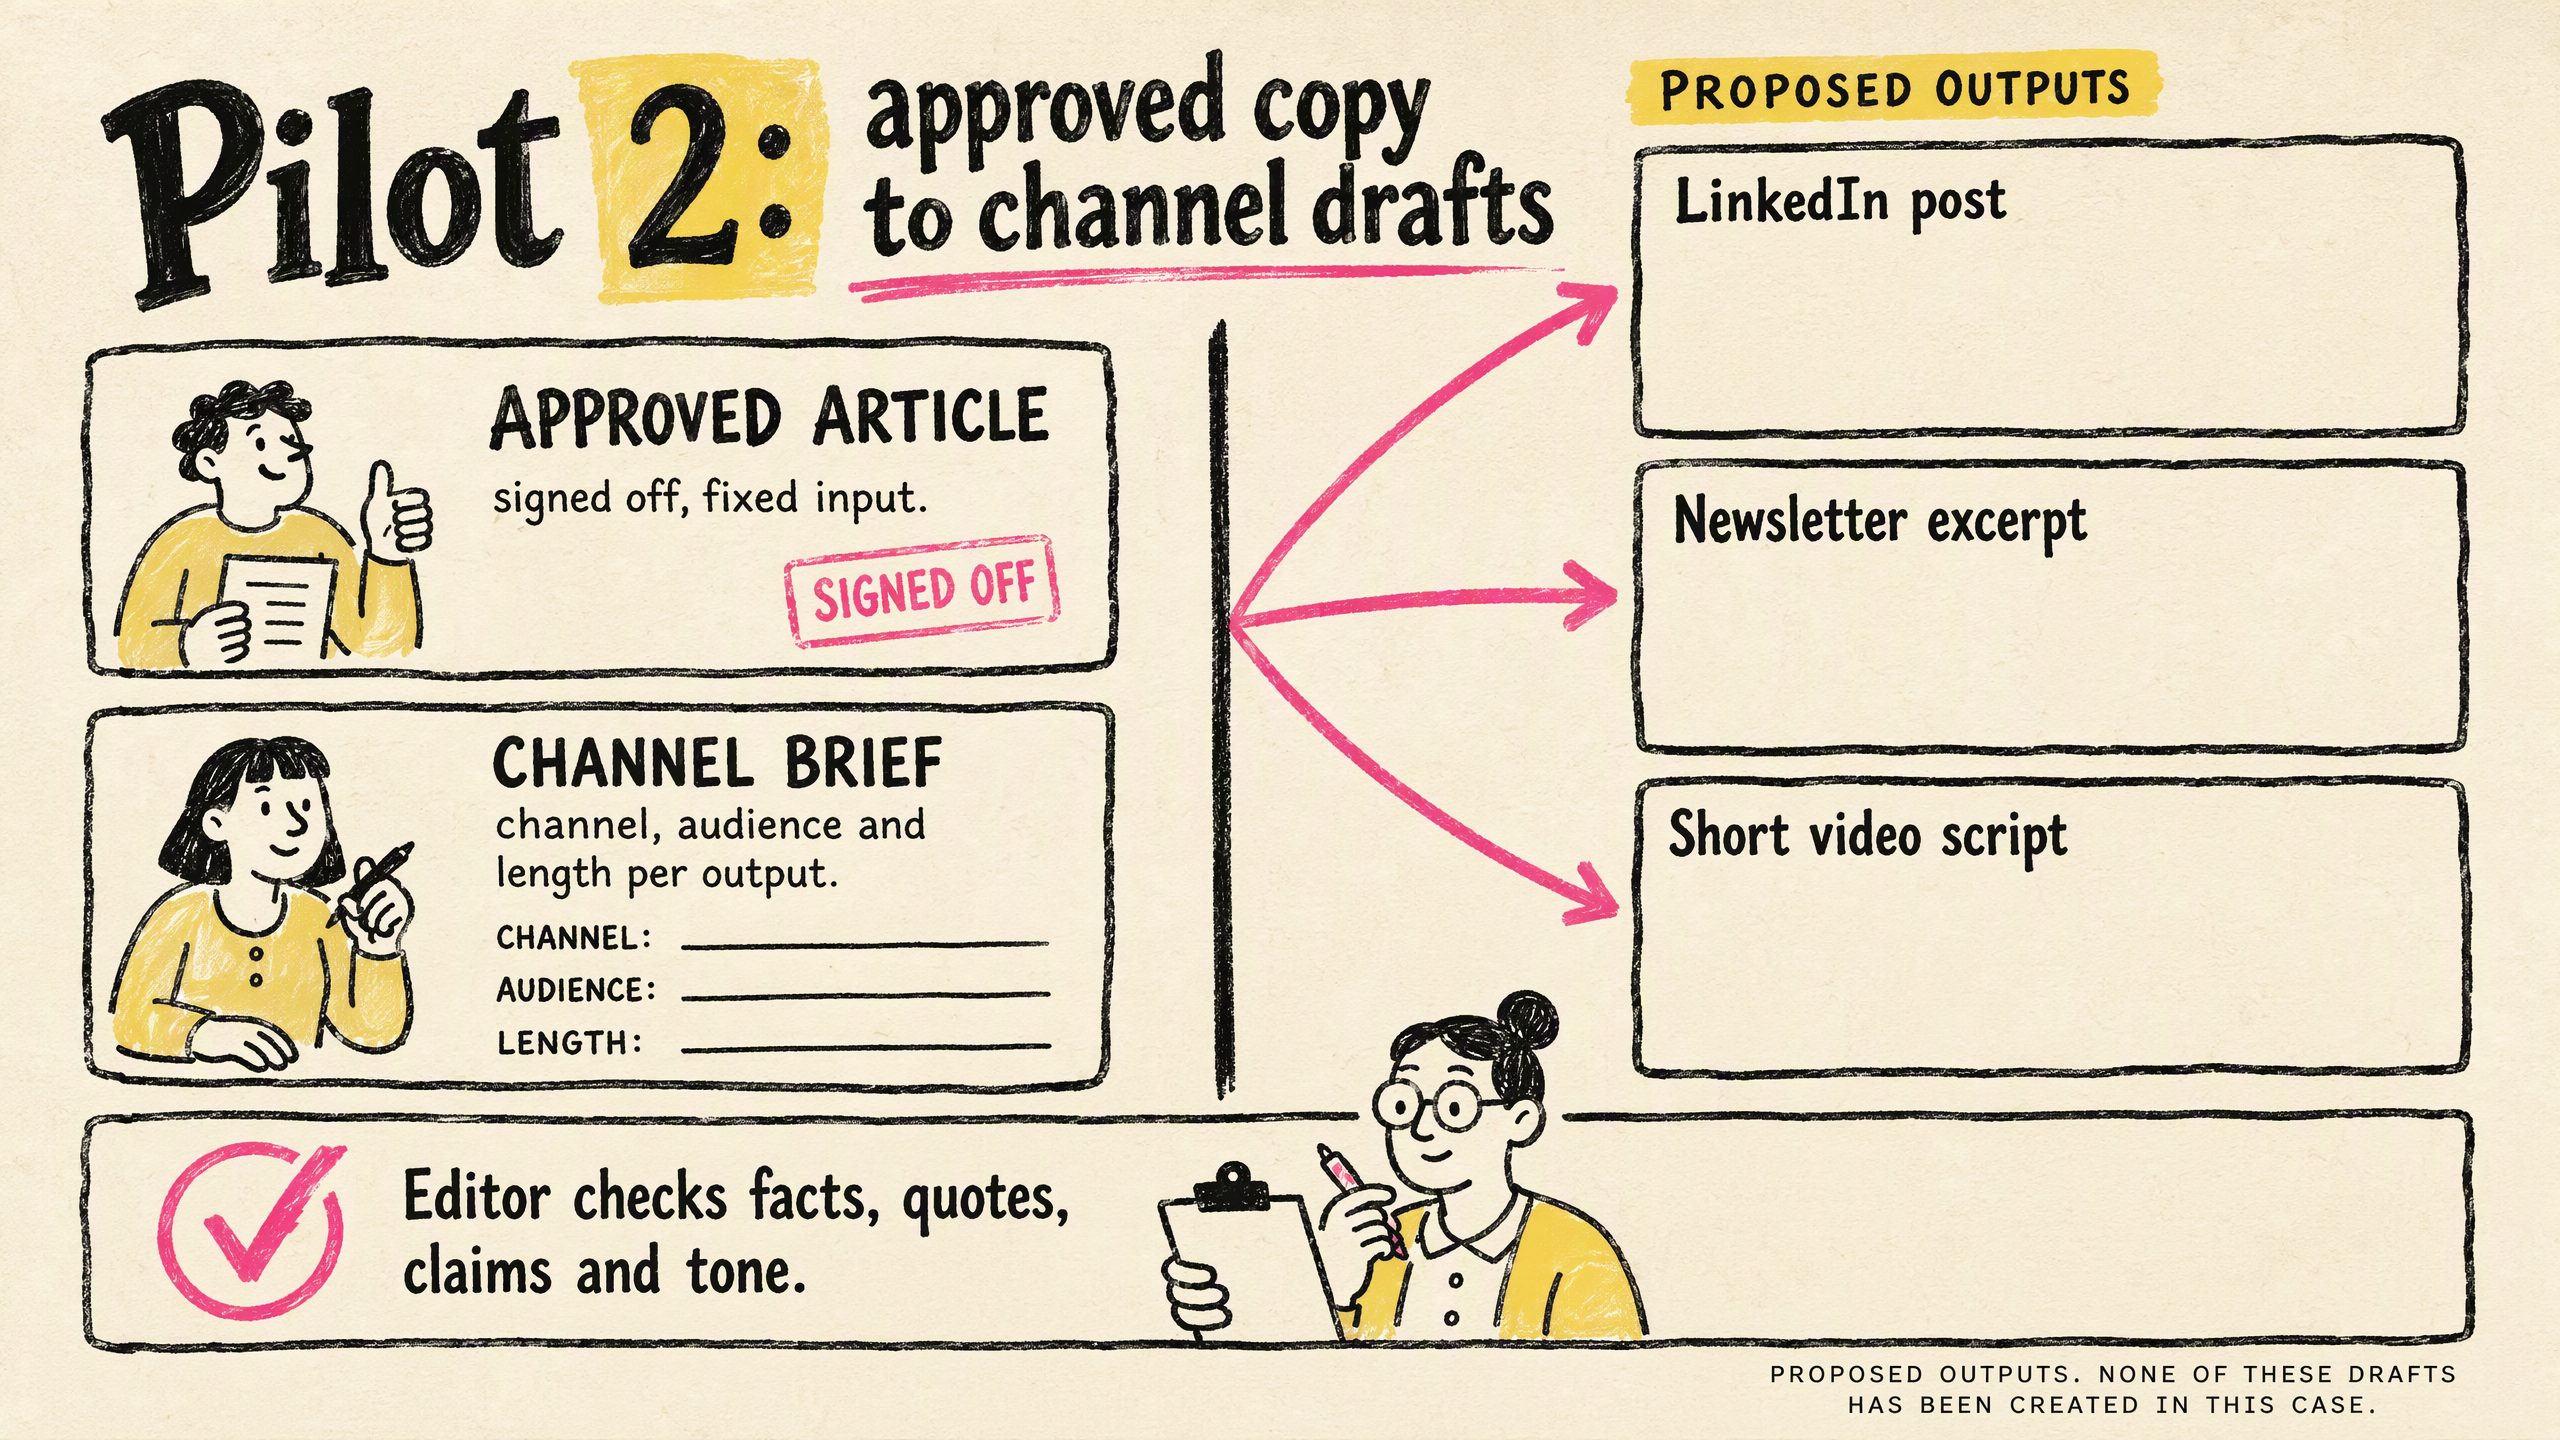
- Problem · Vorher: CHANNEL-A/B/C-Karten enthielten Schritte, während das Diagramm „Kanal“ sagte · Nachher: Links: freigegebener Artikel + Kanal-Briefing; rechts: drei benannte, leere vorgeschlagene Outputs (LinkedIn, Newsletter, Kurzvideo); ein gemeinsamer Review-Balken
- Warum · Vorher: In diesem Fall existieren noch keine Kanal-Entwürfe · Nachher: Fußzeile: vorgeschlagene Outputs; hier wurden keine erstellt
- Zweiter Durchgang · Vorher: Anweisungstext („Links:…“, „Rechts:…“) sickerte in die Kartenkörper · Nachher: Bei der Neugenerierung entfernt
Aussage gesichert: Der freigegebene Text ist die Grenze; die KI bearbeitet nicht das Original.
3. Zahlen- und Zitationsprüfung: Platzhalter → echte Quelltabelle
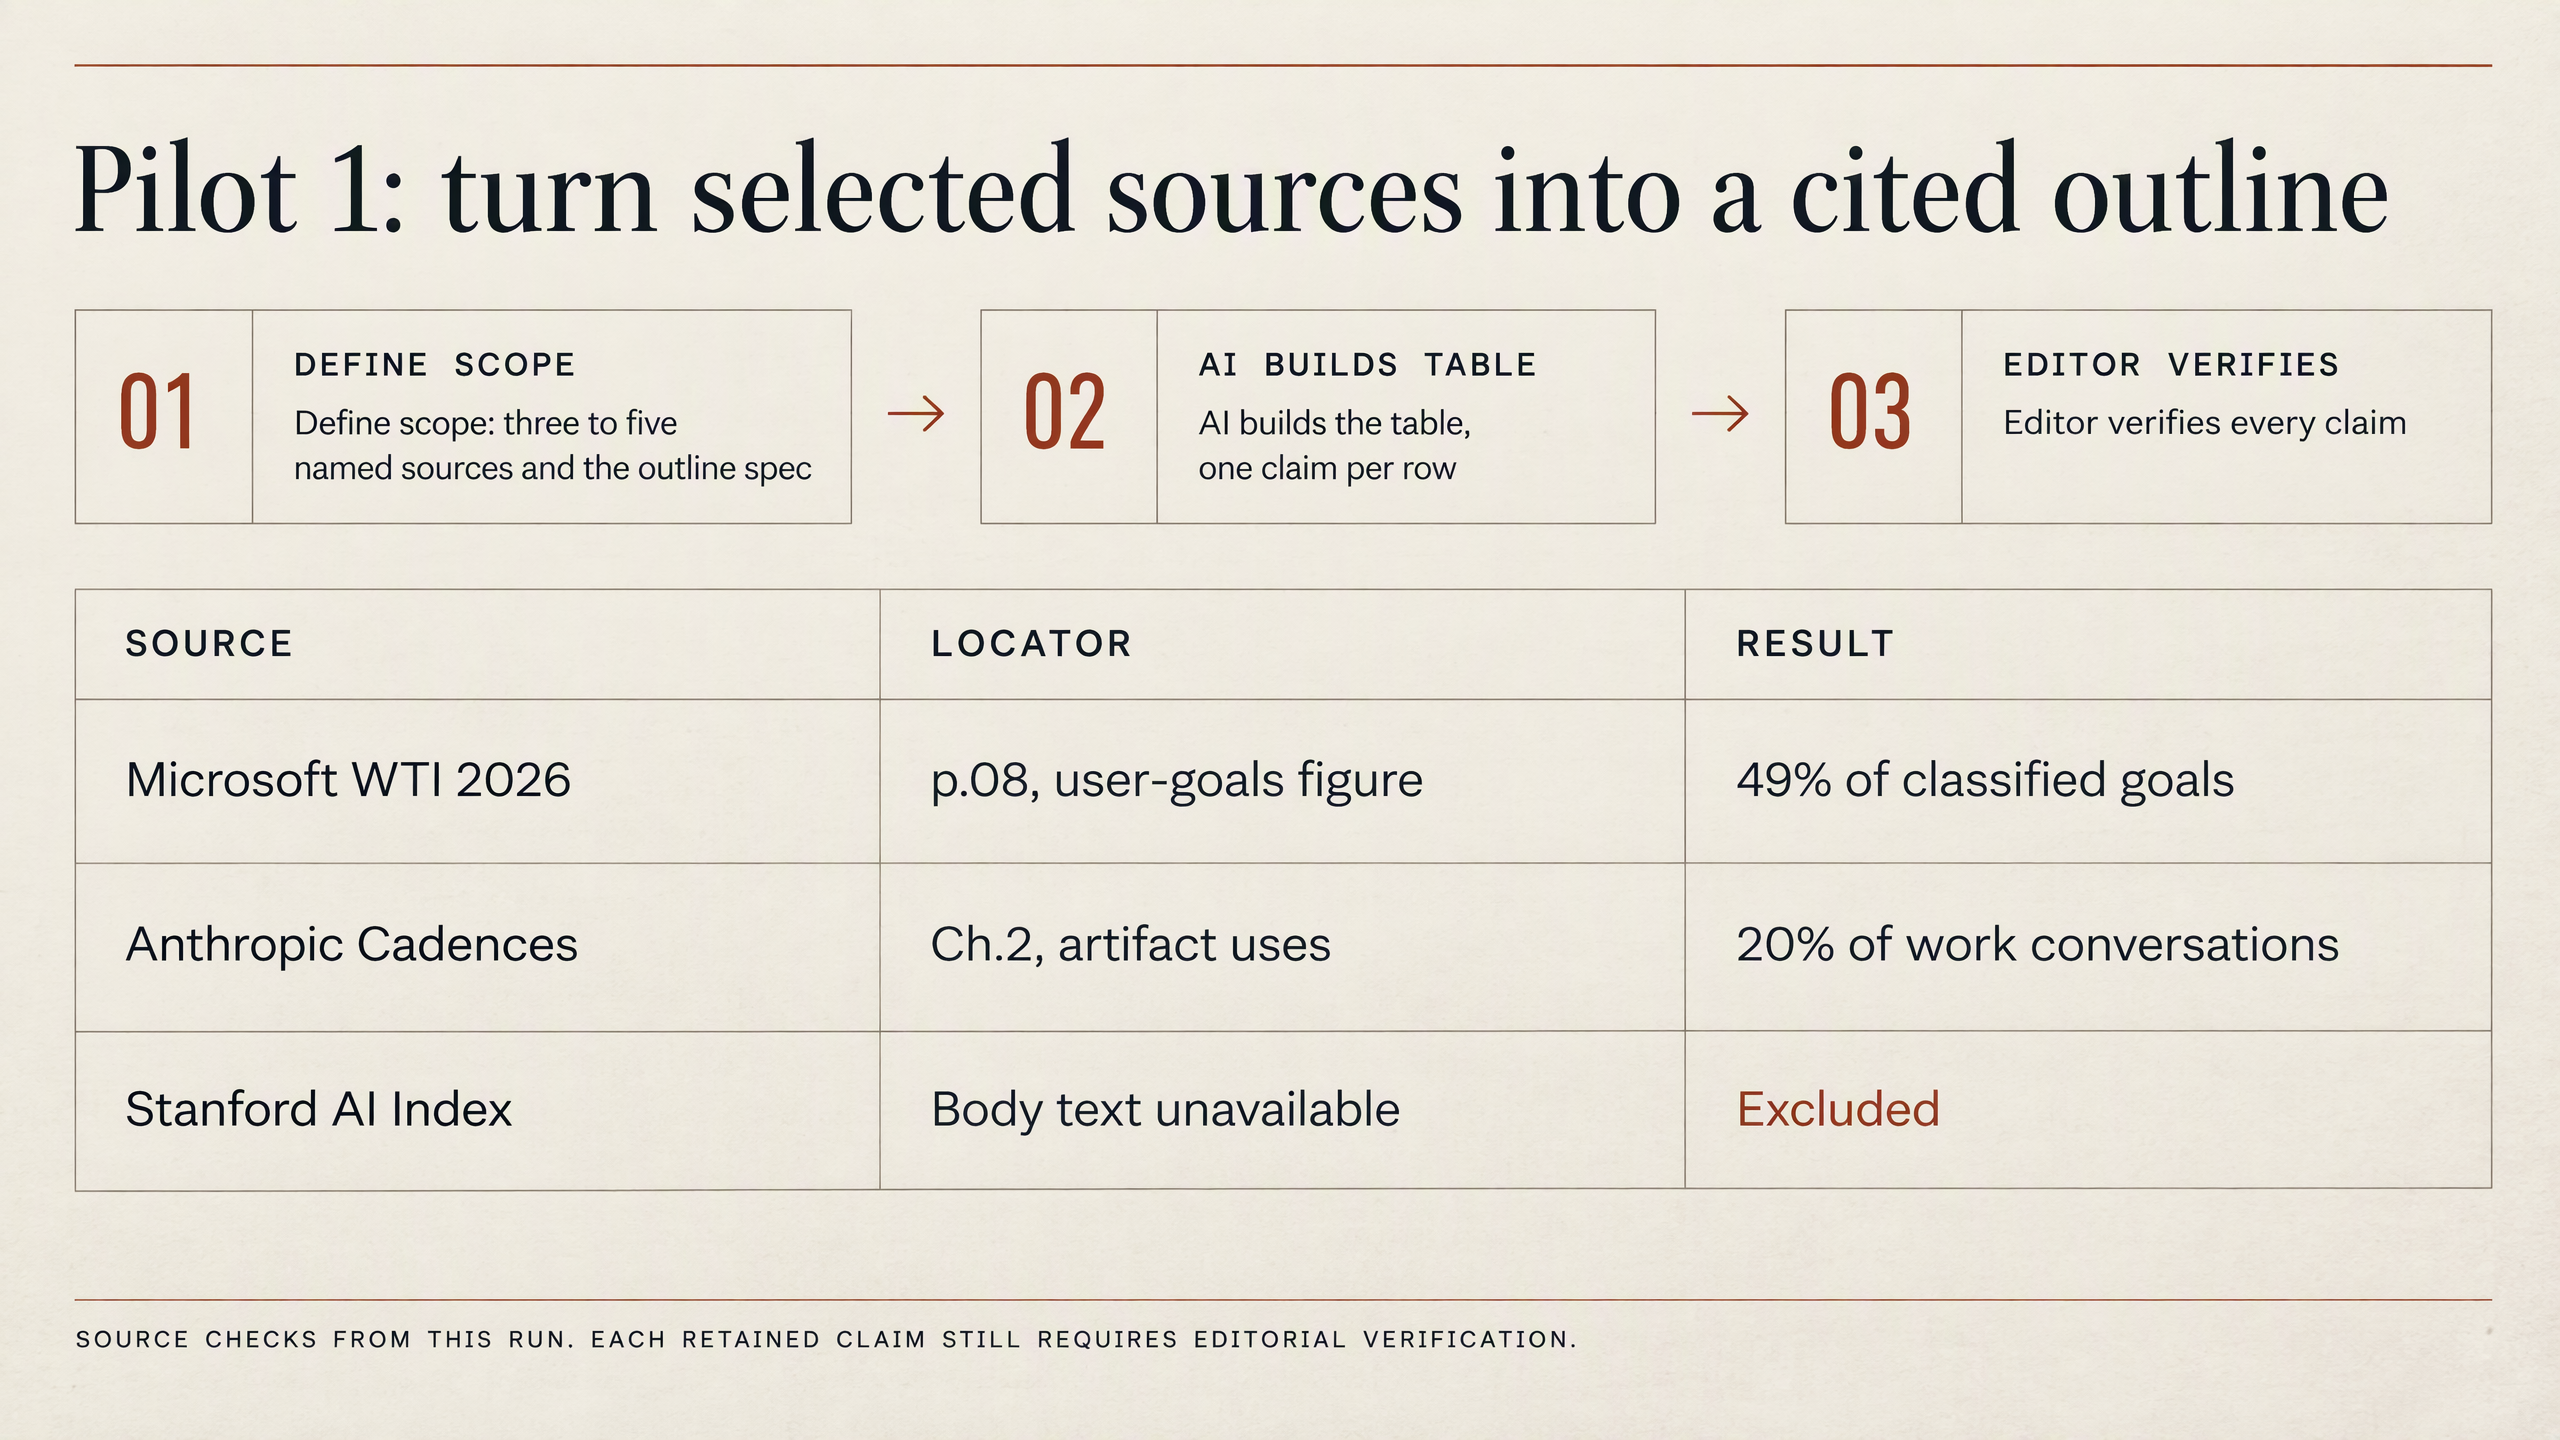
Folie 3 (Pilot 1), Runde 1
- Problem: „Aussage 1 / Quelle A / S. 12“ und Ähnliches – erfundene Fundstellen auf genau der Folie, deren Thema Zitationsdisziplin ist.
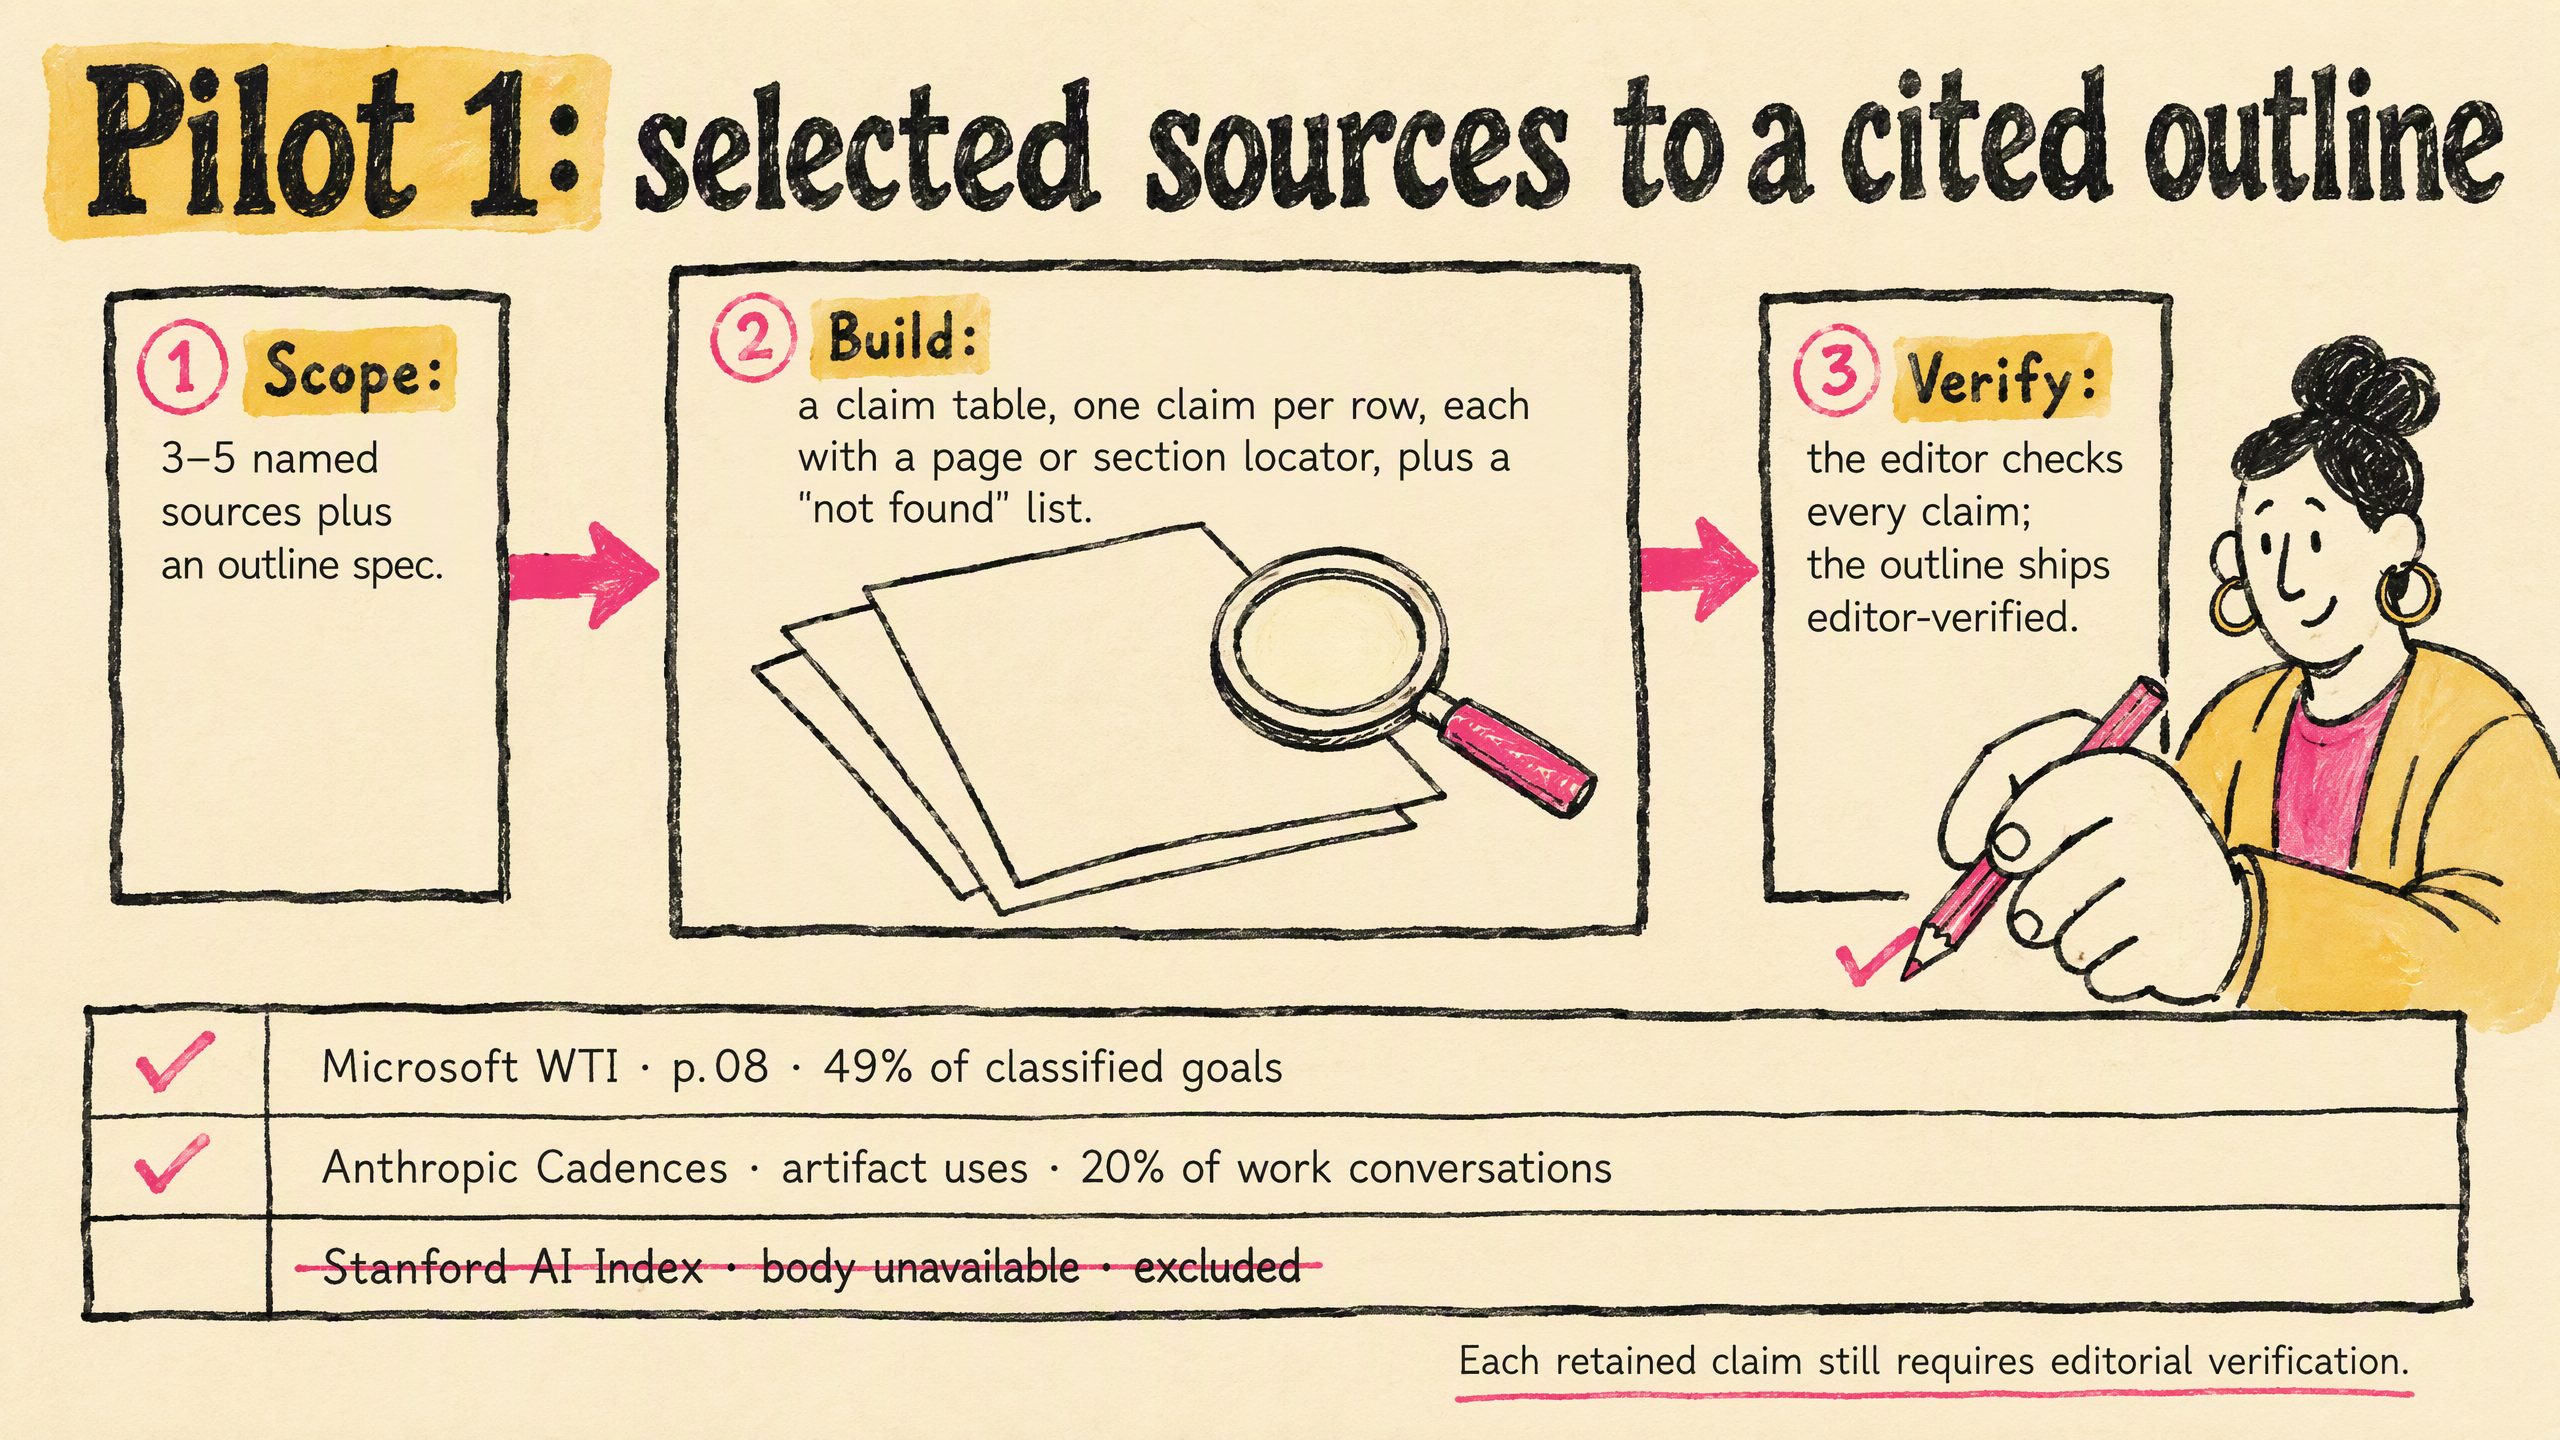
- Lösung: drei echte Zeilen – Quelle / Fundstelle / Ergebnis:
- Microsoft WTI 2026 → S. 08 → 49 % der klassifizierten Ziele
- Anthropic Cadences → Kap. 2 Artefaktnutzung → 20 % der Arbeitsgespräche
- Stanford AI Index → Fließtext nicht verfügbar → Ausgeschlossen
- Fußzeile: Quellenprüfungen aus diesem Durchlauf; beibehaltene Aussagen benötigen weiterhin redaktionelle Prüfung.
Runde 3 (Bildprüfung nach dem Export): Eine Mini-Tabelle in der Mitte führte wieder falsche Fundstellen ein („S. 12“, „§ 3.1“). Lösung: die Mini-Tabelle komplett entfernen; durch einen unbeschrifteten, handgezeichneten Papierstapel ersetzen; den echten dreizeiligen Streifen darunter behalten.
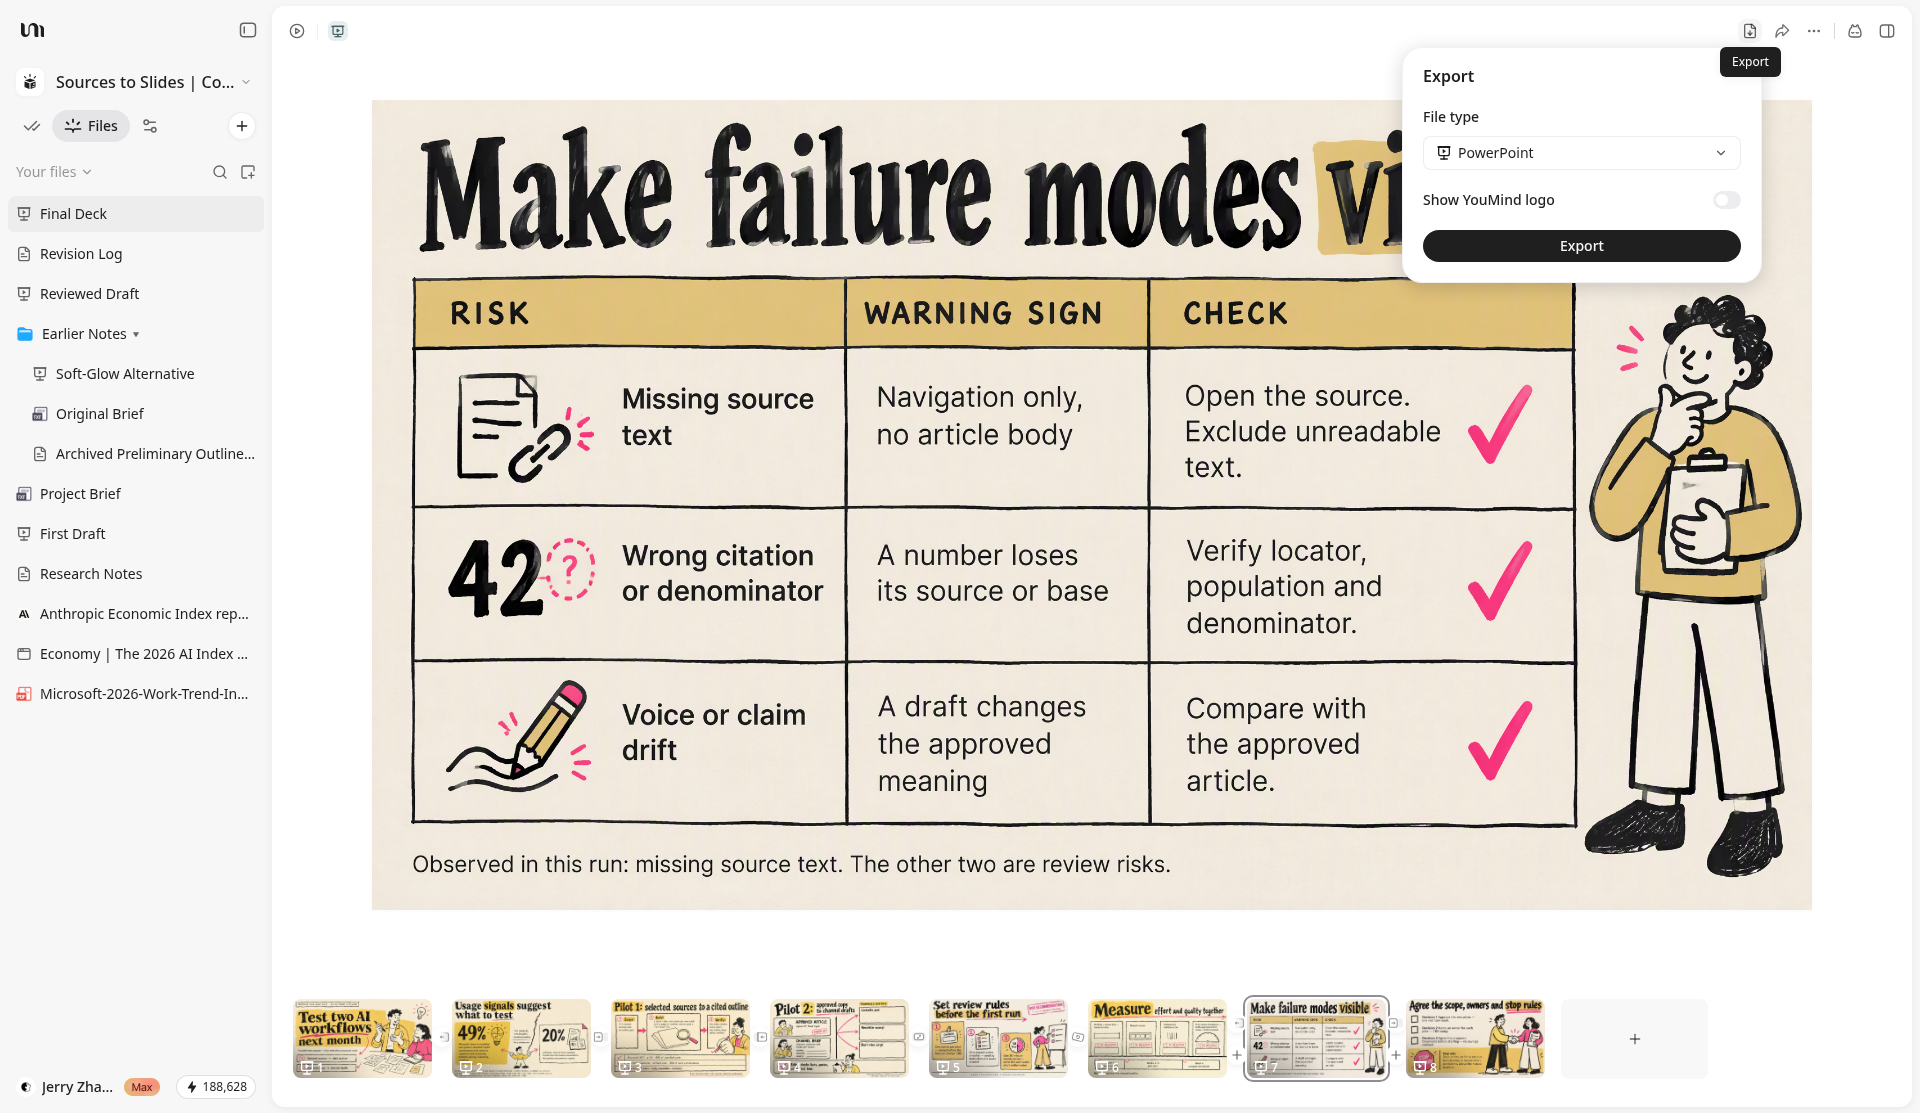
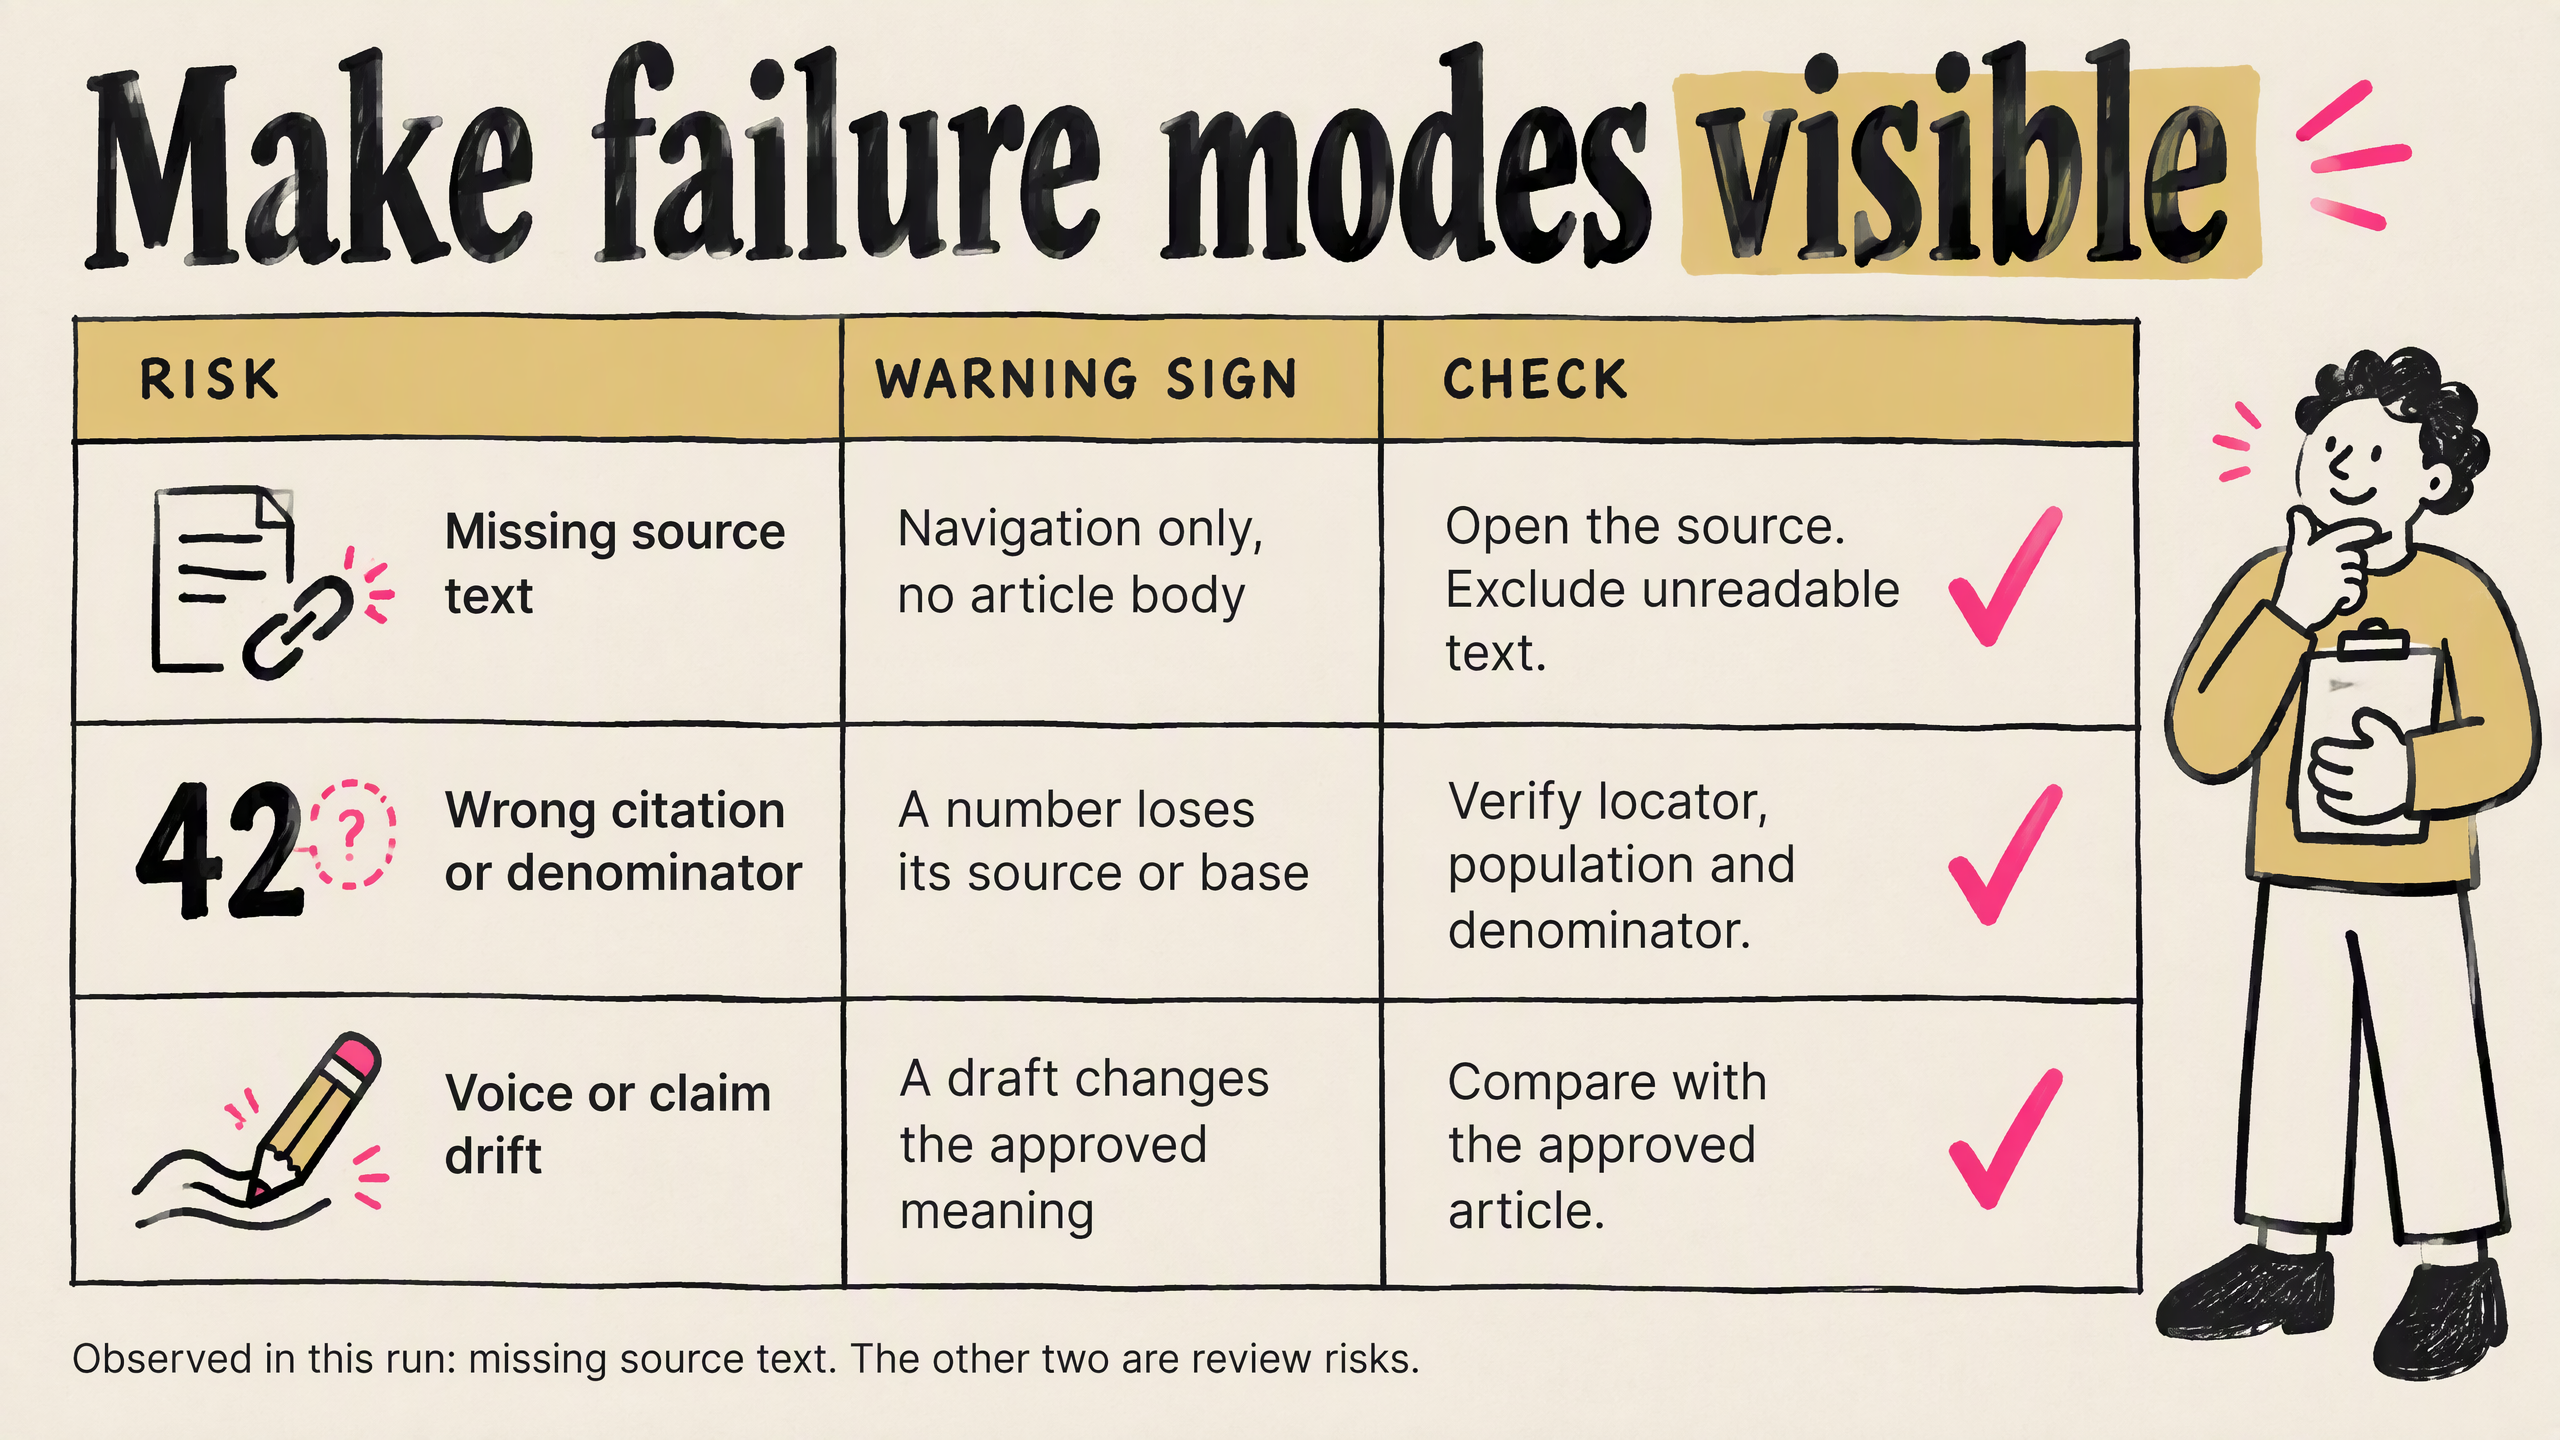
4. Klarheitskorrektur: Fehlermodi-Folie
- Keine Spaltenüberschriften; die zweite Zeile wiederholte denselben Satz in Warnungs- und Prüfspalte und löschte so die mittlere Bedeutung.
- Danach: Überschriften Risiko / Warnsignal / Prüfung; drei unterschiedliche Zeilen (fehlender Quelltext; falsches Zitat oder falscher Nenner; Stimm- oder Aussageabweichung) mit praktischen Prüfungen.
- Runde 3: CHECK saß über dekorativen Häkchen statt über der Aktionsspalte → Neuaufbau auf einem echten Dreispaltenraster.
5. Im Editor / Neugenerieren: Du kannst nicht „ein Wort reparieren“
- Die Fußnote auf Folie 6 endete mit einem verstümmelten Zeichen → die gesamte Seite neu generieren; den exakten Satz sperren: Week 1 establishes the manual baseline.
- Ein erfundenes Präfix „SOURCE: INTERNAL RESEARCH TEAM“ tauchte einmal auf → entfernt (eine solche interne Quelle gibt es in diesem Fall nicht).
- Alle vier Metriken bleiben TO BE MEASURED – keine Fake-Zahlen.
6. Stilentscheidung: gleicher freigegebener Inhalt, zwei visuelle Sprachen
Nachdem der Inhalt aus Runde 1 durchging, wirkte der Papier/Tinte-Entwurf zu schlicht – starke Argumentation, schwaches Layout. Also:
- Runde 2a: Vibrant handdrawn for young professional (v1) → ausgewählt als Final Deck (handgezeichnete Konturen, kräftige Farbblöcke, bewusst unterschiedliche Folientypen).
- Runde 2b: Modern Light Soft-glow (v9) → nicht ausgewählt, archiviert.
Der Inhalt blieb beim Restyle konstant: 49-%-Nennerformulierung, zwei getrennte Faktenpanels, Stanford ausgeschlossen, Pilot 2 mit leeren vorgeschlagenen Outputs, ungemessene Metriken, Verantwortlicher TBD, Abbruchregel als „vorgeschlagen“ gekennzeichnet.
7. Nach dem Export: Limits, die das Versprechen ändern
Die PPTX aus diesem Deck ist ein Rasterbild pro Folie (z. B. 2560×1440) – keine bearbeitbaren Textobjekte, keine Sprechernotizen-Spur. Ein Wort zu ändern bedeutet, dieses Seitenbild neu zu generieren und das Segment auszutauschen. Die Moderation steht in den Research Notes; präsentiere von dort. Fußnoten, die auf einem Laptop lesbar sind, können hinten im Raum scheitern.
Wo Buttons und Exportformate zu finden sind, zeigt die Produktseite: nano-banana-pro-slide. Beschreibe diese Datei nicht als normales, textbearbeitbares PowerPoint.
Das finale Deck auf einen Blick
- #: 1 · Finale Titelrichtung: Nächsten Monat zwei KI-Workflows testen · Entscheidung, die die Folie schützt: Plan, nicht Ergebnisse; unbenannte Outcomes werden gemessen
- #: 2 · Finale Titelrichtung: Nutzungssignale zeigen, was getestet werden sollte · Entscheidung, die die Folie schützt: Zwei Fakten, zwei Nenner; Grund zum Testen ≠ Einsparungsprognose
- #: 3 · Finale Titelrichtung: Pilot 1: ausgewählte Quellen → zitierte Gliederung · Entscheidung, die die Folie schützt: Echte Quellenprüfungstabelle; unlesbar → ausschließen
- #: 4 · Finale Titelrichtung: Pilot 2: freigegebener Text → Kanal-Entwürfe · Entscheidung, die die Folie schützt: Grenze beim freigegebenen Text; Outputs nur „vorgeschlagen“
- #: 5 · Finale Titelrichtung: Review-Regeln vor dem ersten Lauf festlegen · Entscheidung, die die Folie schützt: Governance ist unsere Empfehlung, kein Forschungsergebnis
- #: 6 · Finale Titelrichtung: Aufwand und Qualität gemeinsam messen · Entscheidung, die die Folie schützt: Review-Zeit einbeziehen; Woche 1 schafft die Baseline
- #: 7 · Finale Titelrichtung: Fehlermodi sichtbar machen · Entscheidung, die die Folie schützt: Drei Risiken + günstige Prüfungen; hier nur „fehlender Quelltext“ beobachtet
- #: 8 · Finale Titelrichtung: Umfang, Verantwortliche und Abbruchregeln vereinbaren · Entscheidung, die die Folie schützt: Entscheidungsfolie; Abbruchregeln vor Arbeitsbeginn
Checkliste zum Kopieren
- Die drei Einstiegsfragen notiert (Entscheidung / Aussage / Verbote)
- Ungenutzte Quellen dokumentiert (inklusive leerer Web-Captures)
- Eine Aussage pro Folie; wichtige Zahlen verweisen auf PDF/Seite + Nenner
- Platzhalter, durchgesickerte Anweisungen und falsch beschriftete Diagramme bereinigt
- Wenn zwei Stile generiert wurden, Auswahl- und Ablehnungsgründe protokolliert (inklusive fehlgeschlagener Abbrüche)
- Inhaltlicher Durchlauf vor dem Export + Prüfung nach dem Export: bearbeitbar oder nicht, wo die Notizen liegen
- Keine Fake-Kunden, Fake-Einsparungen oder das Behandeln unbewiesener Suchphrasen als verifizierter Traffic
FAQ
Wie macht man aus einer PDF, Webseiten und Notizen mit KI eine Bericht-PPT?
Quellen und ein klares Publikum/eine klare Aussage in einen Workspace packen → eine prüfbare Gliederung erstellen (eine Aussage pro Folie) und freigeben → einen ersten Entwurf per Konversation oder Skill generieren → Titel bearbeiten, Rauschen streichen und Zahlen erneut gegen die Quellen prüfen → bestätigen, was der Export wirklich liefert, dann ausliefern. Es geht nicht um Perfektion auf Anhieb; es geht um Rückverfolgbarkeit, eine freigegebene Gliederung und menschliche Korrektur nach der Generierung.
Was repariert man normalerweise, nachdem die KI eine PPT generiert hat?
Vier wiederkehrende Handgriffe: (1) Quellen streichen, die der Aussage nicht dienen oder nicht lesbar sind; (2) vage Titel in aussagenkräftige Thesen umschreiben; (3) Zahlen und Zitate in der Original-PDF oder auf der Seite prüfen; (4) an die reale Exportform anpassen – wenn Folien ganzseitige Rasterbilder sind, plane ein, eine Seite neu zu generieren, wenn ein Wort falsch ist.
Wie unterscheidet sich das von Hochladen → Generieren → Exportieren auf der Tool-Seite?
Die Tool-Seite zeigt den Funktionspfad. Dieser Artikel zeigt Entscheidungen und Vorher/Nachher an einem Materialset, damit du weißt, wo du stoppen und bearbeiten musst. Buttons gibt es auf der Tool-Seite; die Auslieferbarkeit steckt in der Editier-Checkliste.
Vergleichst du noch Anbieter? Siehe /compare/autoppt.
Nächster Schritt
Öffne ein Board mit einer deiner eigenen PDFs und deinen Notizen. Geh dieselbe Checkliste durch: drei Fragen → Gliederung kürzen → generieren → mindestens einen Titel und eine Zahl gegen die Quelle korrigieren. Hängst du bei der Skill-Wahl fest? Zurück zur Sammlung. Brauchst du den Produktpfad? Nutze die Tool-Seite.
Hast du Fragen zu diesem Artikel?
KI kostenlos fragenVerwandte Beiträge
Sofort wiedererkennbar: Nutzen Sie Image-to-Prompt für einen konsistenten visuellen Markenauftritt
Nimm deine letzten zehn Bilder und lege sie nebeneinander. Wenn sie wirken, als gehörten sie zu zehn verschiedenen Marken – eins cool und minimalistisch, ein anderes warm und handgezeichnet, das nächste plötzlich mit hoher Sättigung –, dann liegt das Problem nicht darin, ob ein einzelnes Bild gut aussieht. Das Problem ist, dass jedes eine andere Geschichte erzählt. In einem Feed, der vor Inhalten nur so überquillt, sorgt nicht ein einzelnes atemberaubendes Bild dafür, dass man sich an dich erinnert, sondern ein Gefühl von Beständigkeit, das den Betrachter denken lässt: "Ich weiß, dass du es bist, noch bevor ich den Namen sehe." Und diese Beständigkeit ist kein Talent – sie ist ein System. Visuelle Konsistenz klingt nach etwas, das nur großen Marken und professionellen Designern vorbehalten ist, aber im Kern ist es eigentlich ganz einfach: dieselbe Beleuchtung, dieselbe Farbpalette, dieselbe Medium-Textur, dieselbe Komposition, wiederholt, bis sie zu deiner Identität wird. Die Schwierigkeit liegt nie darin, "ein einziges gut aussehendes Bild zu machen" – sondern darin, "das hundertste Bild immer noch so aussehen zu lassen, als gehöre es zur gleichen Familie wie das erste." Und ironischerweise haben KI-Bildgenerierungstools dies noch schwieriger gemacht. Genau das, was Text-zu-Bild so attraktiv macht, ist das, was es für die Markenbildung gefährlich macht: Jede Generierung ist ein wenig anders. Derselbe Prompt, "warmer, heilender Illustrationsstil", kann dir heute ein cremig-weiches Licht und morgen eine satte orange-rote Intensität liefern. Derselbe "minimalistische Produktshot" könnte diesmal mit einem rein weißen Hintergrund kommen und beim nächsten Mal unerklärlicherweise einen Schatten hinzufügen. Das Modell interpretiert deine vage Beschreibung jedes Mal von Grund auf neu und verinnerlicht nie wirklich, wie "deine Marke aussehen sollte" in deinem Kopf. Also gerätst du in eine vertraute Schleife: Du beschreibst jedes Bild von null an, es ist immer ein bisschen daneben, du gibst dich zufrieden und veröffentlichst es, und Monate später schaust du zurück und dein Account sieht aus, als wäre er von drei oder vier Leuten mit völlig unterschiedlichen Ästhetiken verwaltet worden. wird oft als einfaches Werkzeug verwendet, um "rückwärts zu ermitteln, wie ein Bild erstellt wurde". Aber im Kontext der Markenbildung tut es etwas viel Wichtigeres: Es nimmt einen visuellen Stil, den du sofort erkennst, aber nur schwer beschreiben kannst, und fixiert ihn in einem Textblock, den du kopieren und wiederverwenden kannst. Der Ansatz ist einfach. Wähle zunächst ein "Stilanker"-Bild aus, das die Stimmung deiner Marke repräsentiert – es könnte dein erfolgreichster Beitrag sein, ein Referenzbild, zu dem du immer wieder zurückkehrst, oder ein Basisbild, das du speziell für diese Marke erstellt hast. Füttere es in das Werkzeug, und es wird dieses Bild in eine strukturierte Beschreibung "lesen": was das Motiv ist, woher das Licht kommt, ob die Farbpalette kühl oder warm ist, ob es sich um Fotografie oder Illustration handelt, die Schärfentiefe und Textur sowie die Gesamtstimmung. Diese Beschreibung ist die textuelle Version der visuellen DNA deiner Marke. Von nun an musst du nicht mehr jedes Mal von null anfangen und dich auf dein Gefühl verlassen. Du hast eine Vorlage, die du unverändert wiederverwenden kannst. In einem extrahierten Prompt sind einige Elemente die Konstanten deiner Marke, und einige sind nur der Inhalt dieses bestimmten Bildes. Sie zu trennen, ist der Schlüssel zur gesamten Methode. Was du festlegen solltest, umfasst normalerweise diese Aspekte: die Farbpalette – die Farbtöne, die dich auf einen Blick erkennen lassen; die Beleuchtung – sanftes Morgenlicht oder hartes Seitenlicht; die Medium-Textur – realistische Fotografie, semi-realistische Illustration oder 3D-Rendering; die Kompositionsgewohnheit – viel negativer Raum, Motiv zentriert oder außermittig; und die Gesamtstimmung – ruhig, klar oder lebendig. Zusammen sind sie der Teil, der die Leute sagen lässt: "Ich erkenne dich, noch bevor ich genau hinsehe." Was du jedes Mal austauschen solltest, ist nur der Inhalt selbst: Dieses Mal ist das Motiv Produkt A, nächstes Mal Produkt B; dieses Bild zeigt eine Frühstücksszene, jenes einen Schreibtisch. Du bewahrst die "Gene" deines Stils, ersetzt nur diese eine Variable und generierst neu – die Beleuchtung und Farbpalette bleiben erhalten, und nur das, was du geändert hast, ändert sich tatsächlich. Das ist die eigentliche Grenze zwischen "einem ganzen Satz von Bildern, die zur gleichen Marke gehören" und "jedes Mal aufs Neue auf Glück hoffen". Der wahre Test für die visuelle Konsistenz einer Marke ist nicht ein einzelnes Bild – es sind die verschiedenen Kontexte. Ein Blogbeitrags-Cover, ein Satz von Social-Media-Bildern, eine externe Präsentation – wenn sie alle unterschiedliche Stile haben, wirkt selbst großartiger Inhalt fragmentiert. Mit diesem festgelegten Prompt kannst du dieselbe visuelle Sprache über alle Berührungspunkte verbreiten: Verwende ihn, um ein Blog-Cover zu generieren, das den Ton deiner Marke trägt, erstelle einen Satz von Bildern für Social-Media-Beiträge, die zusammengehören, und lege sogar ein einheitliches Erscheinungsbild für Illustrationen in deinen Präsentationen fest. In YouMind kannst du, ausgehend von diesem Prompt, nahtlos durch all diese Aufgaben navigieren – Cover, Begleitbilder und Slides teilen sich dasselbe Licht und dieselbe Farbpalette, anstatt jeweils eigene Wege zu gehen. Da ein Prompt reiner Text ist, funktioniert er mit verschiedenen Tools: Nano Banana Pro, GPT Image 2, Midjourney und Stable Diffusion können alle dieselbe Beschreibung lesen. Dein Markenstil ist nicht an ein einziges Modell gebunden. Es gibt eine Grenze, die man klar ziehen sollte. Sich von der Beleuchtung, Komposition und Atmosphäre eines Bildes inspirieren zu lassen, ist in Ordnung. Aber wenn dein "Stilanker" direkt von einem charakteristischen Look eines Konkurrenten, einer urheberrechtlich geschützten berühmten Figur oder dem Logo einer anderen Marke stammt und du ihn als dein eigenes Gesicht verwendest – dann rutscht das von "einen Stil entwickeln" in "eine Identität imitieren" ab. Generische "Stile" gehören niemandem, aber der spezifische, wiedererkennbare Ausdruck einer Marke ist ihr eigenes Kapital. Der sicherste Ansatz ist daher, auf deinem eigenen Material zu verankern – deinen Produkten, deinen Szenen, deiner Basis – und dann den extrahierten Prompt zu verwenden, um es zu systematisieren und zu skalieren. Jedes von dir erstellte Bild wird dann sowohl konsistent als auch wirklich deins sein. In der Vergangenheit beruhte die visuelle Konsistenz einer Marke auf einem Designer, der sich jedes Detail merkte, oder einem Styleguide, den niemand lesen wollte. Jetzt kannst du sie in einen Textblock komprimieren: einmal extrahieren, wiederholt verwenden, nur das austauschen, was geändert werden muss. Wenn du das nächste Mal ein Bild für neuen Inhalt brauchst, musst du nicht auf Glück hoffen und ein leeres Prompt-Feld anstarren. Du weißt bereits, wie deine Marke aussieht, und du kannst sie jedes Mal so aussehen lassen. Wie hilft Bild zu Prompt bei der visuellen Konsistenz einer Marke? Es übersetzt ein Bild, das die Stimmung deiner Marke repräsentiert, in einen strukturierten Prompt. Du legst die Farbpalette, Beleuchtung, Medium und Komposition fest und ersetzt jedes Mal nur das Motiv oder die Szene. Die Ausgabebilder behalten immer den gleichen Stil. Welches Bild sollte ich als "Stilanker" verwenden? Dein eigenes Material ist am sichersten: dein erfolgreichster Beitrag, ein speziell erstelltes Basisbild oder ein fertiges Bild, das die Stimmung deiner Marke am besten repräsentiert. Versuche, die Verwendung von Konkurrenten oder urheberrechtlich geschützten Figuren als Anker zu vermeiden. Kann dieser Prompt in verschiedenen KI-Tools verwendet werden? Ja. Die Ausgabe ist reiner Text, und gängige Text-zu-Bild-Tools wie Nano Banana Pro, GPT Image 2, Midjourney und Stable Diffusion können ihn direkt verwenden. Dein Markenstil ist nicht an ein einziges Modell gebunden. Werden dadurch alle Bilder genau gleich aussehen? Nein. Es legt die stilistischen Konstanten fest, aber der Inhalt ist jedes Mal anders. Das Ziel ist, dass sie wie "eine Familie" aussehen, nicht dass dasselbe Bild kopiert und eingefügt wird. Brauche ich Erfahrung in Design oder der Erstellung von Prompts? Nein. Der Extraktionsschritt übersetzt visuelle Elemente für dich in Text. Du musst nur entscheiden, welche Elemente deine Markenkonstanten sind und welche du austauschen möchtest, und schon kannst du mit der Wiederverwendung beginnen.
Verwandeln Sie Bilder in wiederverwendbare KI-Bildgenerierungs-Prompts
Du kennst das bestimmt: Du scrollst durch deinen Feed, siehst ein Bild und kannst nicht wegschauen – das Licht, die Farbpalette, die Atmosphäre, nach der du wochenlang gesucht hast, alles in einem einzigen Frame eingefangen. Du willst etwas Ähnliches erstellen, also öffnest du deinen KI-Bildgenerator, starrst auf das leere Prompt-Feld und tippst so etwas Vages wie „filmreifes Foto, schönes Licht, volle Atmosphäre". Das Ergebnis? Etwas, das mit dem Bild, das du im Kopf hattest, überhaupt nichts zu tun hat. Das Problem ist meistens nicht dein Geschmack – es ist die Übersetzung. Ein fertiges Bild zurück in den Text zu verwandeln, der es erschaffen könnte, ist wirklich schwierig. Dafür braucht es ein spezielles Vokabular rund um Komposition, Kamerawinkel, Beleuchtung, Farbschemata und Stil – ein Vokabular, das sich die meisten Menschen nie aneignen können. Genau das erledigt das für dich: Gib ihm ein Bild, und es gibt dir den Text zurück. In diesem Artikel erfährst du, was es ist, wann es gut funktioniert, wo es an seine Grenzen stößt und wie du in Sekunden deinen ersten Prompt erhältst. Image to Prompt ist das Gegenteil von Text-zu-Bild. Normalerweise schreibst du eine Beschreibung und das Modell generiert ein Bild. Hier gibst du dem Modell ein fertiges Bild, und es schreibt die Beschreibung – den Prompt, den du eingegeben hättest, um genau dieses Bild zu erhalten. Du hast vielleicht schon andere Begriffe dafür gehört: Reverse Prompting, Prompt Extraction, Image-to-Prompt oder einfach „Prompts aus Bildern zurückentwickeln". Die Namen variieren, aber die Aufgabe ist dieselbe: visuelle Informationen in eine strukturierte, wiederverwendbare Textbeschreibung umzuwandeln, die jedes Text-zu-Bild-Tool verstehen kann. Eine nützliche Extraktion geht weit über etwas so Vages wie „eine Katze" hinaus. Sie erfasst die Elemente, die ein Bild wirklich ausmachen: Du lädst ein Bild hoch und das Tool „liest" es wie ein geschultes Auge: Es identifiziert die Elemente, die die visuelle Wirkung wirklich bestimmen – Motiv und Komposition, Richtung und Qualität des Lichts, gesamte Farbpalette, Stil und Medium sowie technische Details wie Schärfentiefe und Textur. Dann übersetzt es das Gesehene in präzise Sprache und setzt einen kohärenten, sofort nutzbaren Prompt zusammen. Ein bestimmtes Licht wird zu „weichem Morgenlicht", ein bestimmter Ton zu „warmer, halbrealistischer Stil". In Sekunden hast du einen Prompt, den du direkt verwenden kannst. In YouMind kannst du ihn als Ausgangspunkt für ein Artikel-Cover nutzen oder sogar Illustrationen für eine Präsentation erstellen. Aber denk dran: Dieses Ergebnis ist ein solider erster Entwurf, keine endgültige Wahrheit. Es ist der beste Versuch des Tools, das Bild zu interpretieren – und genau darum geht es im nächsten Abschnitt. Hier ist ein kompletter, realer Durchlauf. Zuerst lädst du ein Referenzbild hoch (in diesem Fall eine sanft beleuchtete Illustration einer Person, die eine weiße Katze hält). Die Upload-Karte zeigt an: Datei bereit, bereit zur Verarbeitung. Klicke auf Prompt generieren, und hier ist die tatsächliche Ausgabe: Siehst du? Es geht weit über „eine Person, die eine Katze hält" hinaus. Es spezifiziert die Lichtrichtung, Farbpalette, Schärfentiefe, Komposition und Stimmung – genau die Faktoren, die darüber entscheiden, ob dein nächstes Bild dem Referenzbild entspricht. Zusammen mit dem Prompt liefert das Tool klare nächste Schritte: Generiere es unverändert, ersetze ein Element und behalte die ursprüngliche Komposition bei, oder verwende den Look für Cover oder Social-Media-Grafiken. Von hier aus musst du nicht von vorn anfangen – ändere einfach eine Variable. Tausche die weiße Katze gegen einen Hund, ändere die Pulloverfarbe oder verlege die Szene in eine Leseecke und generiere neu. Komposition und Beleuchtung bleiben erhalten; nur das geänderte Element ist anders. Du behältst die „DNA" des Referenzbildes – seine Beleuchtung, seinen Bildausschnitt und seine Atmosphäre – während das Endergebnis unverkennbar dein eigenes ist. Die meisten Image-to-Prompt-Tools stoppen bei „hier ist eine Beschreibung" – und dieser Schritt ist inzwischen praktisch Standard. Wo YouMinds wirklich glänzt, ist das, was nach der Beschreibung passiert: Am besten ist es bei einzelnen, klaren Motiven: Porträts, Produktfotos, Landschaften und Bildern mit einem konsistenten, wiedererkennbaren Stil. Saubere, gut beleuchtete Referenzbilder führen besonders oft zu ebenso sauberen Prompts. In einigen vorhersehbaren Bereichen wird es unzuverlässig. Unübersichtliche Kompositionen mit mehreren Motiven können das Tool verwirren, wenn es darum geht, welches Element der Prompt betonen soll. Abstrakte Kunst lässt sich nur schwer auf Text reduzieren und verliert dabei immer etwas von ihrem Wesen. Textlastige Bilder (Plakate, Infografiken, Memes) liefern oft verstümmelten oder halluzinierten Text, weil Vision-Modelle nicht gut im Transkribieren von Text sind. Und wie jedes KI-Modell kann auch das Extraktionstool halluzinieren: Es könnte selbstbewusst ein Material, eine Marke oder ein Detail beschreiben, das gar nicht im Bild ist. Behandle die Ausgabe also als Entwurf, der gegen das Originalbild geprüft werden muss, nicht als wortgetreue Aufzeichnung: Lies sie, streiche, was falsch ist, behalte, was nützlich ist. In etwa zehn Sekunden kannst du einen Prompt extrahieren. Das Extrahieren eines Prompts beschreibt einen Stil; es überträgt kein Eigentum. Gut eingesetzt, ist es ein Werkzeug zum Lernen und für Ideenfindung – ein Weg zu verstehen, warum ein Bild funktioniert, und etwas Neues in der Richtung zu schaffen, die du bewunderst. Nachlässig eingesetzt, rutscht es ins Plagiat ab. Eine vernünftige Grenze ist: Dich vom Licht, der Komposition und der Atmosphäre inspirieren zu lassen, aber nicht das unverkennbare Werk eines lebenden Künstlers, eine urheberrechtlich geschützte Figur oder ein Markenlogo zu kopieren und als dein eigenes auszugeben – besonders nicht für kommerzielle Zwecke. Ein allgemeiner „Stil" gehört niemandem, aber ein spezifischer, wiedererkennbarer Ausdruck kann geschützt sein. Genau dafür ist der „Ersetzungs-Workflow" da: Tausche Motiv, Szene oder Winkel und mach das Ergebnis wirklich zu deinem eigenen. Ist das Image to Prompt Tool kostenlos? Ja. Du kannst auf YouMind ein Bild hochladen und einen Prompt generieren, ohne zu bezahlen. Welche Bildformate werden unterstützt? JPG und PNG, unter anderem – das deckt die meisten Fotos, Screenshots und exportierten Bilder ab. Mit welchen KI-Tools können die generierten Prompts verwendet werden? Mit jedem Text-zu-Bild-Modell. Die Ausgabe ist reiner Text und funktioniert daher mit Nano Banana Pro, GPT Image 2, Midjourney, Stable Diffusion, DALL·E und mehr. Reproduziert es exakt dasselbe Bild? Nein, und das ist beabsichtigt. Es liefert dir den Prompt, der hinter dem Stil steckt, damit du deine eigene Version generieren kannst – keine pixelgenaue Kopie. Brauche ich Erfahrung im Schreiben von Prompts? Nein. Der ganze Sinn von Image to Prompt ist es, dir den manuellen Schreibschritt zu ersparen. Du kannst das Ergebnis verfeinern, aber du musst nicht bei null anfangen. Wenn dich beim nächsten Mal ein Bild zum Innehalten bringt, musst du weder den Text dahinter erraten noch es einfach kopieren. , forme ihn nach deinen Wünschen und erschaffe etwas wirklich Eigenes.
KI sprengt die alten Denkmuster des Menschen
Das erste Mal, als es passierte, erstarrte das ganze Büro. Dann flüsterte jemand: „Heilige Scheiße.“ Ein ganzer Chor folgte. Statischer Text auf einem Bildschirm hatte sich – direkt vor unseren Augen – in etwas Responsives, Flüssiges, fast Atmendes verwandelt. Es war der erste erfolgreiche Lauf von Gemini 3s Dynamic View in YouMind, zusammen mit Nano Banana Pro und seiner Bildgenerierungs-Engine. Und natürlich musste ich es selbst ausprobieren. Das Problem war… ich hatte in diesem Moment keinerlei Vorstellungskraft. Also wählte ich die erste Idee, die mir in den Sinn kam: Was wäre, wenn ich meinen langweiligen KI-Newsletter in den Tagespropheten verwandeln würde – die Zeitung mit den bewegten Porträts aus Harry Potter? Ich habe es gebaut. Es funktionierte. Interaktiver Tagesprophet, KI-Newsletter-Ausgabe. Erzielen Sie den gleichen Effekt Und für einen Moment dachte ich ehrlich, ich müsste weinen. Der Inhalt war nichts Besonderes – nur die üblichen KI-Updates, die ich jede Woche veröffentliche. Aber jetzt tanzten dieselben Worte in einer lebendigen, verzauberten Zeitung, die von Bewegung und Emotionen durchzogen war. Ich konnte nicht wegschauen. Und da traf mich die eigentliche Frage: Wenn dieses Ding mittelmäßige Inhalte so fesselnd wirken lassen kann, was könnte es dann mit etwas wirklich Großartigem anstellen? Auf den ersten Blick fühlt sich das wie ein cooler visueller Trick an. Eine schicke Animation. Eine magische Zeitung. Aber das ist die kleine Geschichte. Die große Geschichte ist, dass es einen Bann bricht, unter dem wir seit Tausenden von Jahren stehen – einen Bann, der verdächtig nach einer weicheren Version von Orwells Neusprech aussieht. Im Jahr 1984 schafft das Regime Neusprech, eine Sprache, die den Umfang des menschlichen Denkens einschränkt. Nimmt man das Wort Freiheit weg, verlieren die Menschen irgendwann das Konzept der Freiheit. Sprache komprimieren, Denken komprimieren. Aber hier ist die unbequeme Wahrheit: Sie und ich leben auch unter unserer eigenen Form von Neusprech. Nicht von einem Regime erzwungen, sondern von etwas Subtilerem: Technik. In Ihrem Kopf sind Ideen nicht linear. Sie sind dreidimensional, vielschichtig, räumlich – wie ein Palast mit Zimmern, Treppen und versteckten Türen. Aber wenn Sie kein Maler, Architekt oder Musiker sind, können Sie das nicht auf die lebendigste Weise ausdrücken. Sie sind gezwungen, alles auf den schmalen Streifen linearen Textes zu pressen. Ein Satz nach dem anderen. Eine Idee hinter die nächste gequetscht. In dem Moment, in dem der Gedanke Ihren Kopf verlässt, verliert er seine Tiefe. Selbst im Internetzeitalter ist dieses Problem nicht verschwunden. Sie wissen, dass eine Webseite räumlich, interaktiv, dynamisch sein könnte – aber Sie wissen nicht, wie man codiert, gestaltet oder ein Layout orchestriert. Also ziehen Sie sich auf statische Dokumente zurück, die sichere Zone, in der Komplexität schrumpfen muss, um zu passen. Technik komprimiert den Ausdruck. Und indem sie den Ausdruck komprimiert, komprimiert sie das Denken selbst. Deshalb fühlt sich Ihre Idee in Ihrem Kopf brillant an, aber auf der Seite enttäuschend. Der Container tötet die Energie lange bevor die Welt eine Chance hat, sie zu sehen. Doch wenn Gemini 3 mit Nano Banana Pro in YouMind verschmilzt, bricht diese Decke endlich auf. Zum ersten Mal fließen Text, Bilder, Bewegung und Interaktion in einem einzigen Medium zusammen, das jeder steuern kann. Zum ersten Mal können Sie einen räumlichen Gedanken als räumlichen Gedanken ausdrücken. Nicht, weil Sie Design verstehen – sondern weil KI Design durchlässig macht. Dies ist der Anti-Neusprech-Charme: KI gibt das Recht zu denken – das zuvor von der Technik gestohlen wurde – an die Schöpfer zurück. Wenn der Container sich ausdehnt, dehnt sich der Geist mit ihm aus. Es gibt eine weitere Barriere, die KI stillschweigend auflöst: Ästhetik. Einst war Schönheit ein Privileg. An der École des Beaux-Arts in Paris gingen Professoren durch die Prüfungsateliers und sortierten die Zeichnungen der Studenten stillschweigend in zwei Stapel: weitermachen und aufhören. Keine Kriterien. Keine Erklärungen. Ästhetik war eine private Sprache, zugänglich nur denen mit Zeit, Reichtum und Ausbildung. YouMind kann jetzt Oberflächen mit natürlichem Rhythmus, Hierarchie und Harmonie generieren. Sie müssen kein „Design verstehen“, um etwas auszudrücken, das gestaltet aussieht. Schönheit wird zur öffentlichen Infrastruktur. Und sobald die Angst vor dem „Schönmachen“ verschwindet, können die Schöpfer endlich zur eigentlichen Frage zurückkehren: Welche Art von spiritueller Welt möchte ich aufbauen? Wenn Ästhetik das Gesicht ist, ist Wertschöpfung die Seele. In den 1990er Jahren definierte McKinsey die Beratung neu, indem es von dichten „Blue Books“ zu klaren, visuellen PowerPoint-Präsentationen überging. Dies veränderte nicht nur die Art und Weise, wie Wissen präsentiert wurde, sondern auch, wie es bewertet wurde. Heute steht YouMind am McKinsey-Moment, aber vervielfacht. Für Berater, Pädagogen, Forscher – jeden, dessen Arbeit Wissen ist – sind Dokumente nicht länger das Endergebnis. Sie sind Rohstoffe. Das eigentliche Ergebnis ist die Schnittstelle: ein lebendiger, interaktiver Ausdruck Ihrer Ideen. Sie verkaufen nicht länger Informationen. Sie verkaufen ein Erlebnis des Verstehens. Vor einem Jahrhundert kämpfte die Neue Kulturbewegung in China für das Recht, in der Alltagssprache zu schreiben – Umgangssprache statt Klassisch. Das Argument war einfach: Ausdruck ist ein Recht. Kein Privileg. Heute befinden wir uns in einer neuen Art von Kulturbewegung: dem Recht, Raum, Bewegung und Interaktion zu nutzen, um die Welten zu bauen, die wir uns vorstellen. Zum ersten Mal in der Geschichte: Ein Schriftsteller kann wie ein Architekt denken. Ein Student kann Ideen wie ein Regisseur komponieren. Ein Forscher kann Informationen wie ein Infografik-Designer präsentieren. Ihre Kreationen sitzen nicht einfach auf einer Seite. Sie stehen aufrecht. Sie atmen. Sie sprechen zurück. Es gibt hier eine leise Ironie. Sie lesen dies in einem Textdokument – während ich erkläre, warum Text nicht mehr ausreicht. Text bleibt der schnellste Weg, einen Funken einzufangen. Aber er ist nicht länger die Grenze dessen, was aus diesem Funken werden kann. Genau wie die Philosophie im Herzen von YouMind: „Alles beginnt als Entwurf. Und ein Entwurf wird zu allem.“ Text ist der Samen. Lassen Sie ihn nicht im Glas gefangen. Dieser Entwurf und die begleitenden Visuals wurden gemeinsam mit YouMind erstellt.