مخطط لقطات فيديو AI
حوّل النص إلى جدول لقطات قابل للتنفيذ
مخطط لقطات فيديو AI
حوّل النص إلى جدول لقطات قابل للتنفيذ
معاينة المحتوى
الوصف
أكثر مشكلتين شيوعًا في فيديوهات الذكاء الاصطناعي هما: أولًا، عدم توضيح المطلوب للنموذج (فعند كتابة «شخص مفعم بالحيوية يستقبل يومًا جديدًا» لا يستطيع النموذج تنفيذ ذلك فعليًا)، وثانيًا، ألّا يبدو الشخص في اللقطة الأولى مثل الشخص نفسه في اللقطة الثانية. يحوّل 【مخطط لقطات فيديو AI】 النص إلى جدول يمكن نسخه ولصقه لتوليد اللقطات واحدة تلو الأخرى، بحيث تتضمن كل لقطة خمسة عناصر: الموضوع (من يفعل ماذا من أفعال مرئية)، والبيئة (ما يوجد في المقدمة والخلفية)، والإضاءة (الاتجاه والنعومة ودرجة حرارة اللون)، والكاميرا (حجم اللقطة وارتفاع موضع الكاميرا وطريقة الحركة)، وجملة الأسلوب (الخامة ودرجات الألوان). والأهم هو «الحيل الثلاث للاتساق»: كتابة وصف الشخصية الرئيسية في كتلة نصية ثابتة تُنسخ كما هي في كل مرة مع تغيير الفعل فقط، وتكرار جملة الإضاءة ووصف المشهد نفسهما في كل لقطة، ثم تثبيت الإطار الأول أولًا، وترك أداة الفيديو تقوده (وهو أكثر فاعلية بكثير من تعديل المطالبات النصية مرارًا). كما يقدّم اقتراحات لتوزيع المدة والانتقالات، ويشرح ست نقاط يسهل أن تؤدي إلى نتائج سيئة (تشوه الوجوه عند ظهور عدة أشخاص في إطار واحد، وتشوه الحركة السريعة، وظهور نصوص مشوشة في الصورة، وأخطاء اللقطات القريبة لليدين، وضبابية الخامات العاكسة، وتغير لون الملابس بين اللقطات) مع طرق صياغة تساعد على تجنبها. القواعد الصارمة: لا يُنشئ فيديو، ولا يستخدم صور أشخاص حقيقيين أو يبدّل الوجوه، ولا يُظهر أي شخصيات موجودة من الرسوم المتحركة أو الألعاب أو الأفلام والمسلسلات، ولا يقلّد مخرجًا أو فنانًا على قيد الحياة دون تسميته، ولا يُنشئ صورًا لقاصرين أو محتوى مكشوفًا، ولا يعلّم كيفية نشر المشاهد المولدة على أنها أخبار مصوّرة حقيقية.
مناسب لـ
مناسب لمنشئي المحتوى والمسوقين ومنتجي الفيديو الذين يحتاجون إلى تحويل النصوص إلى مخططات لقطات ومطالبات توليد متتالية لفيديوهات الذكاء الاصطناعي.
كيفية استخدام هذا Skill
قدّم المدخلات
قدّم نصًا صوتيًا أو تعريفًا بمنتج أو قصة، واذكر الغرض، ومدة الفيديو، ونسبة العرض، والطابع العام، والعناصر أو المشاهد التي يجب الحفاظ على اتساقها، والأداة المستخدمة.
شغّل Skill
قسّم النص إلى جدول لقطات متتالية، مع تحديد الأفعال المرئية، والبيئة، والإضاءة، وحجم اللقطة، وموضع الكاميرا، وحركتها، والأسلوب، مع توحيد أوصاف الشخصيات والمشاهد.
راجع النتيجة
احصل على مطالبات لكل لقطة قابلة للنسخ إلى أدوات الفيديو بالذكاء الاصطناعي، ووصف للإطار الأول، وتوزيع للمدة، واقتراحات للانتقالات، وتنبيهات لتجنب مشكلات الصورة الشائعة.
مهارات ذات صلة
عرض الكل
مطالبات فيديو ومشاهد
حوّل الحبكة، أو إعدادات الشخصيات، أو مطالبات الفيديو الموجودة إلى مشاهد درامية قصيرة احترافية مناسبة لتوليد فيديوهات بالذكاء الاصطناعي، مع مطالبات لقطات جاهزة للاستخدام. سواء كانت المشاهد عصرية أو تاريخية أو غامضة أو عاطفية أو مليئة بالإثارة، ستوضّح المهارة حجم اللقطة، وموضع الكاميرا، وزاوية الرؤية، وحركة الكاميرا، والتكوين، والإضاءة والظلال، والأصوات المحيطة، والحوار، مع التركيز على العلاقات بين الشخصيات وإيقاع الحبكة وخطافات المشاعر، ताकि يكون لكل لقطة تركيز بصري واضح وأفعال قابلة للتنفيذ. تهتم المهارة بشكل خاص باتساق الشخصيات واستمرارية المشاهد، فتساعد على تثبيت مظهر الشخصية، ومنطق ملابسها، وحالتها وهويتها، وتفاصيلها المميزة، مما يقلل مخاطر تغيّر الوجوه، وانحراف المظهر، واضطراب المساحة، وغموض الحركات أثناء التوليد. كما تُحوَّل نظرات الشخصيات وتعبيراتها وتنفسها وحركات أيديها واستجابات أجسادها إلى تغيّرات أدائية مرئية، لتعزيز الصراع والضغط النفسي والانقلابات والتصاعد العاطفي في الدراما القصيرة. يمكنك البدء بحبكة كاملة، أو تقديم أصول الشخصيات أو المشاهد أو المطالبات الموجودة لتحسينها بشكل موجّه. وعند توفر هوية مستقرة للشخصيات، يمكن الاستمرار في استخدامها مباشرة لتجنب إعادة التصميم. وفي النهاية، يمكن تنظيم اللقطات الكاملة في مقاطع لا تتجاوز 15 ثانية، مناسبة للتوليد المتتابع باستخدام نماذج فيديو AI الرائجة، مع الاحتفاظ بمعلومات الصورة والصوت والمدة، لتسهيل النسخ والاستخدام والتحرير اللاحق.
 فيديو
الشرارة | مخططات الفيديو
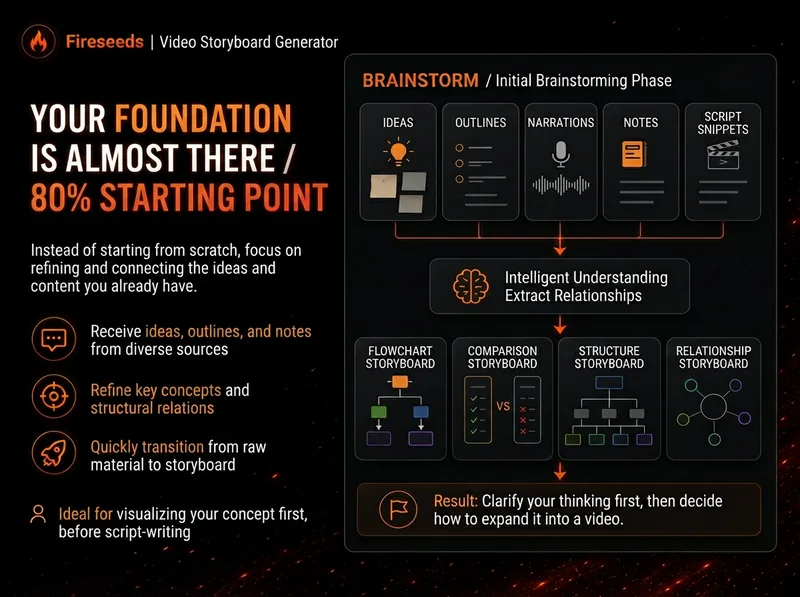
كثير من الفيديوهات لا تفتقر إلى «المحتوى»، بل يكون محتواها مجرّدًا أو كثيفًا أكثر من اللازم؛ فيفهم المشاهد الجملة السابقة وينسى التالية. «الشرارة | مخططات الفيديو» يحوّل أفكارك أو عصفك الذهني أو مخططك أو نصك أو تفريغك الحرفي أو مقالك، أولًا إلى مفاهيم تستحق فعلًا أن تُعرض بصريًا، ثم يحدد ما إذا كان الأنسب التعبير عنها من خلال عملية أو مقارنة أو بنية أو مستويات أو حلقة أو تفرّع أو شجرة قرار أو هيكل توضيحي آخر. لا يرسم المخططات لمجرد زيادة العدد، ولا يحشر المحتوى المعقد في رسم معلوماتي واحد ومزدحم. وتحافظ المخططات المتعددة على اللغة البصرية نفسها، وعلى اتساق التسميات والألوان الدلالية، لتكون جاهزة للإدراج في الفيديو بوصفها هيكلًا للشرح. مناسب خصوصًا لـ: شرح المفاهيم المعقدة تفكيك سير العمل مقارنة طريقتين عرض بنية النظام توضيح علاقات السبب والنتيجة تحويل عصف ذهني طويل إلى مجموعة من العقد البصرية للفيديو يكون الإخراج الافتراضي مخططات توضيحية ثابتة بنسبة 16:9. وإذا لم تتمكن بيئة التشغيل من توفير ملف مصدر Excalidraw قابل للتحرير، فسيُذكر ذلك بوضوح، ولن تُقدَّم صورة ثابتة على أنها ملف .excalidraw. حالات الاستخدام الحالة 1 | تحويل العصف الذهني إلى مخططات لديك مجموعة كبيرة من الأفكار المنطوقة، لكن لا تملك نصًا كاملًا. تبحث المهارة عن الأفكار التي تستحق الرسم، وتنظمها في مجموعة من المخططات ذات تسلسل سردي. الحالة 2 | تحويل النص إلى عقد بصرية للفيديو لديك نص كامل، لكنك لا تعرف أين تضيف العناصر البصرية. تحدد المهارة الفقرات التي تستحق العرض بصريًا، وتختار نوع المخطط المناسب. الحالة 3 | شرح المفاهيم المعقدة مثل: كيف يعمل AI Agent، ولماذا يكون سير العمل أهم من العرض لمرة واحدة، وكيف يعمل نموذج الأعمال، وما الطبقات التي تتضمنها بنية المنتج. الحالة 4 | تفكيك سير العمل أو العملية مثل: بنك الموضوعات ← البحث ← Hook ← النص ← الإنتاج ← المراجعة. الحالة 5 | إجراء المقارنات مثل: من دون سير عمل مقابل مع سير عمل؛ الطريقة التقليدية مقابل طريقة الذكاء الاصطناعي؛ نجاح لمرة واحدة مقابل نجاح مستقر قابل للتكرار.
MiniMax H3: مطالبات فيديو
سلّم فيديو مرجعيًا كاملًا إلى ذكاء اصطناعي متعدد الوسائط، ليحلّل تلقائيًا اللقطات الفعلية والخط الزمني وتغيّرات الصورة والأصوات المسموعة، ثم ينشئ مطالبات احترافية جاهزة للاستخدام في إنشاء الفيديو. لا يقتصر ذلك على الأشخاص أو الإعلانات أو المواد السينمائية، بل يشمل أيضًا عروض المنتجات، والمناظر المعمارية والطبيعية، والحيوانات، والطعام، والحركات الرياضية، والرقص، والرسوم المتحركة ثنائية وثلاثية الأبعاد، وعروض واجهات المستخدم، وتسجيلات الشاشة، والرسوم المعلوماتية، والمؤثرات البصرية، والمقاطع التجريدية وغيرها من الموضوعات. استنادًا إلى بنية المعلومات في الفيديو، يمكن للمساعد إخراج مطالبة كاملة لإنشاء فيديو من النص، أو إنشاء مطالبات لكل لقطة تتضمن الصورة المرجعية أو مطالبة الإطار الأول اللازمة لإنشاء فيديو من صورة، ووصف الحركة المتواصلة، ومطالبة الإطار الأخير عند الحاجة، وقيود الثبات على مستوى اللقطة. وعندما تكون الصورة الثابتة والتغيّرات الزمنية مهمتين، يمكنه تقديم الإصدارين معًا. تحافظ النتائج على المعلومات القابلة للتأكيد فعليًا، مثل الموضوع والتكوين وحركة الكاميرا وعلاقة السبب والنتيجة في الحركة والتغيّرات البنيوية والنصوص والحوار والأصوات المحيطة والموسيقى، كما تتتبع كل لقطة حتى حالتها النهائية الفعلية. بالنسبة إلى النصوص أو الأصوات أو الهويات أو المواقع أو أساليب التصوير التي يتعذر تأكيدها بوضوح، يتجنب المساعد استكمالها من تلقاء نفسه. كما يميّز بين الصورة المستهدفة والعناصر الخارجية، مثل العلامة المائية لمشغّل الفيديو وطبقات التحكم، للحد من انجراف المحتوى أثناء التوليد. يناسب ذلك المبدعين وفرق الإنتاج الذين يحتاجون إلى استخراج مطالبات لإنشاء فيديو من النص أو مطالبات لقطات صورة إلى فيديو من فيديو مرجعي، أو إلى تنظيم المواد لإعادة بناء الفيديو ومحاكاة أسلوبه وإنتاج إعلانات توليدية.
المعلومات
- الإصدار
- v2
- آخر تحديث
- أرصدة التشغيل
- حسب الاستخدام
- النماذج
- تلقائي
- حالات الاستخدام
- الكتابة والمحتوىالفيديو والصوتالتسويق والنمو
- ما ستحصل عليه
- مستندتوجيهخطة